Le Chonk
Oggi lanciamo un'anteprima pubblica di Mistral Large 4. Ufficiosamente ML4, ufficialmente a tutti gli effetti: le Chonk. ML4 porta le prestazioni dei modelli a pesi aperti a nuovi livelli. È possibile provare l'API in anteprima già oggi su Mistral Studio. I pesi saranno disponibili alla fine di questo mese.
Prestazioni all'avanguardia
ML4 è un modello nativamente multimodale da mille miliardi di parametri con 52 miliardi di parametri attivi. È il nostro modello più grande e capace finora, e continua a migliorare rapidamente man mano che lo affiniamo.
Il modello offre prestazioni eccezionali nella codifica, nei flussi di lavoro agentici e nella comprensione multimodale. Già oggi raggiunge prestazioni competitive con i migliori modelli open source a livello globale, superando nettamente qualsiasi modello a pesi aperti sviluppato negli Stati Uniti o in Europe. Nei carichi di lavoro aziendali critici, tra cui sicurezza informatica, finanza e diritto, risulta all'avanguardia tra i modelli aperti. In alcuni ambiti, come il grounding visivo, si spinge ancora oltre, superando persino i modelli chiusi più avanzati.
Rilasceremo i pesi entro la fine del mese. Nel frattempo, sottoponiamo il modello ad attività di red teaming in contesti reali con leader della sicurezza informatica, partner selezionati e autorità statali, che avranno accesso allo stesso modello con una moderazione ridotta e funzionalità ampliate per la sicurezza informatica.



Forgiato in Europe. Progettato per la sovranità dell'IA.
ML4 è stato addestrato da zero su 3.800 GPU NVIDIA Grace Blackwell nei data center di Mistral in Europe. L'anteprima pubblica è erogata sulla stessa infrastruttura. È una tappa importante del nostro investimento a lungo termine in infrastrutture, ricerca e sviluppo di prodotti: prestazioni all'avanguardia in settori critici, offerte attraverso pesi aperti e progettate per dare ai clienti il controllo sulla propria IA.
Questo è particolarmente importante nella sicurezza informatica, dove i rifiuti imposti dal fornitore possono bloccare attività legittime di ricerca sulle vulnerabilità e di risposta agli incidenti, e dove perdere l'accesso a una funzionalità nel corso di un incidente può diventare di per sé un rischio critico per la sicurezza. ML4 unisce prestazioni di primo livello nella sicurezza informatica a pesi aperti e alla possibilità di deployment autonomo, offrendo alle organizzazioni sia le capacità sia l'autonomia necessarie per svolgere attività avanzate di sicurezza secondo le proprie policy.
Il modello sarà disponibile in più regioni a livello globale, incluso un deployment europeo gestito interamente da Mistral, in modo indipendente da altri fornitori di servizi digitali e nel rispetto del diritto europeo. Una curiosità: una parte significativa dei dati di addestramento di ML4 era multilingue e copriva oltre 160 lingue, incluse tutte le lingue ufficiali dell'Unione europea.
Per addestrare ML4 abbiamo collaborato a stretto contatto con aziende leader di tutto il mondo nei settori della finanza, della progettazione, della produzione, della logistica, della farmaceutica, della ricerca, del trasporto marittimo, del settore pubblico e di altri ambiti mission-critical. Il modello utilizza infatti lo stesso ambiente di addestramento, personalizzazione e apprendimento per rinforzo (RL) che offriamo ai nostri clienti tramite Mistral Forge.
Lo provi oggi
Altre novità sono in arrivo. Mentre lavoriamo al rilascio dei pesi, condivideremo ulteriori dettagli sull'architettura del modello, altri benchmark e la nostra metodologia di post-addestramento.
Questo modello sarà anche la base di una nuova generazione di modelli Mistral specializzati e ottimizzati. Nel frattempo, La invitiamo a provare l'API in anteprima e a condividere il Suo feedback con noi sui social media.
Approfondimento sulle funzionalità
Sicurezza informatica
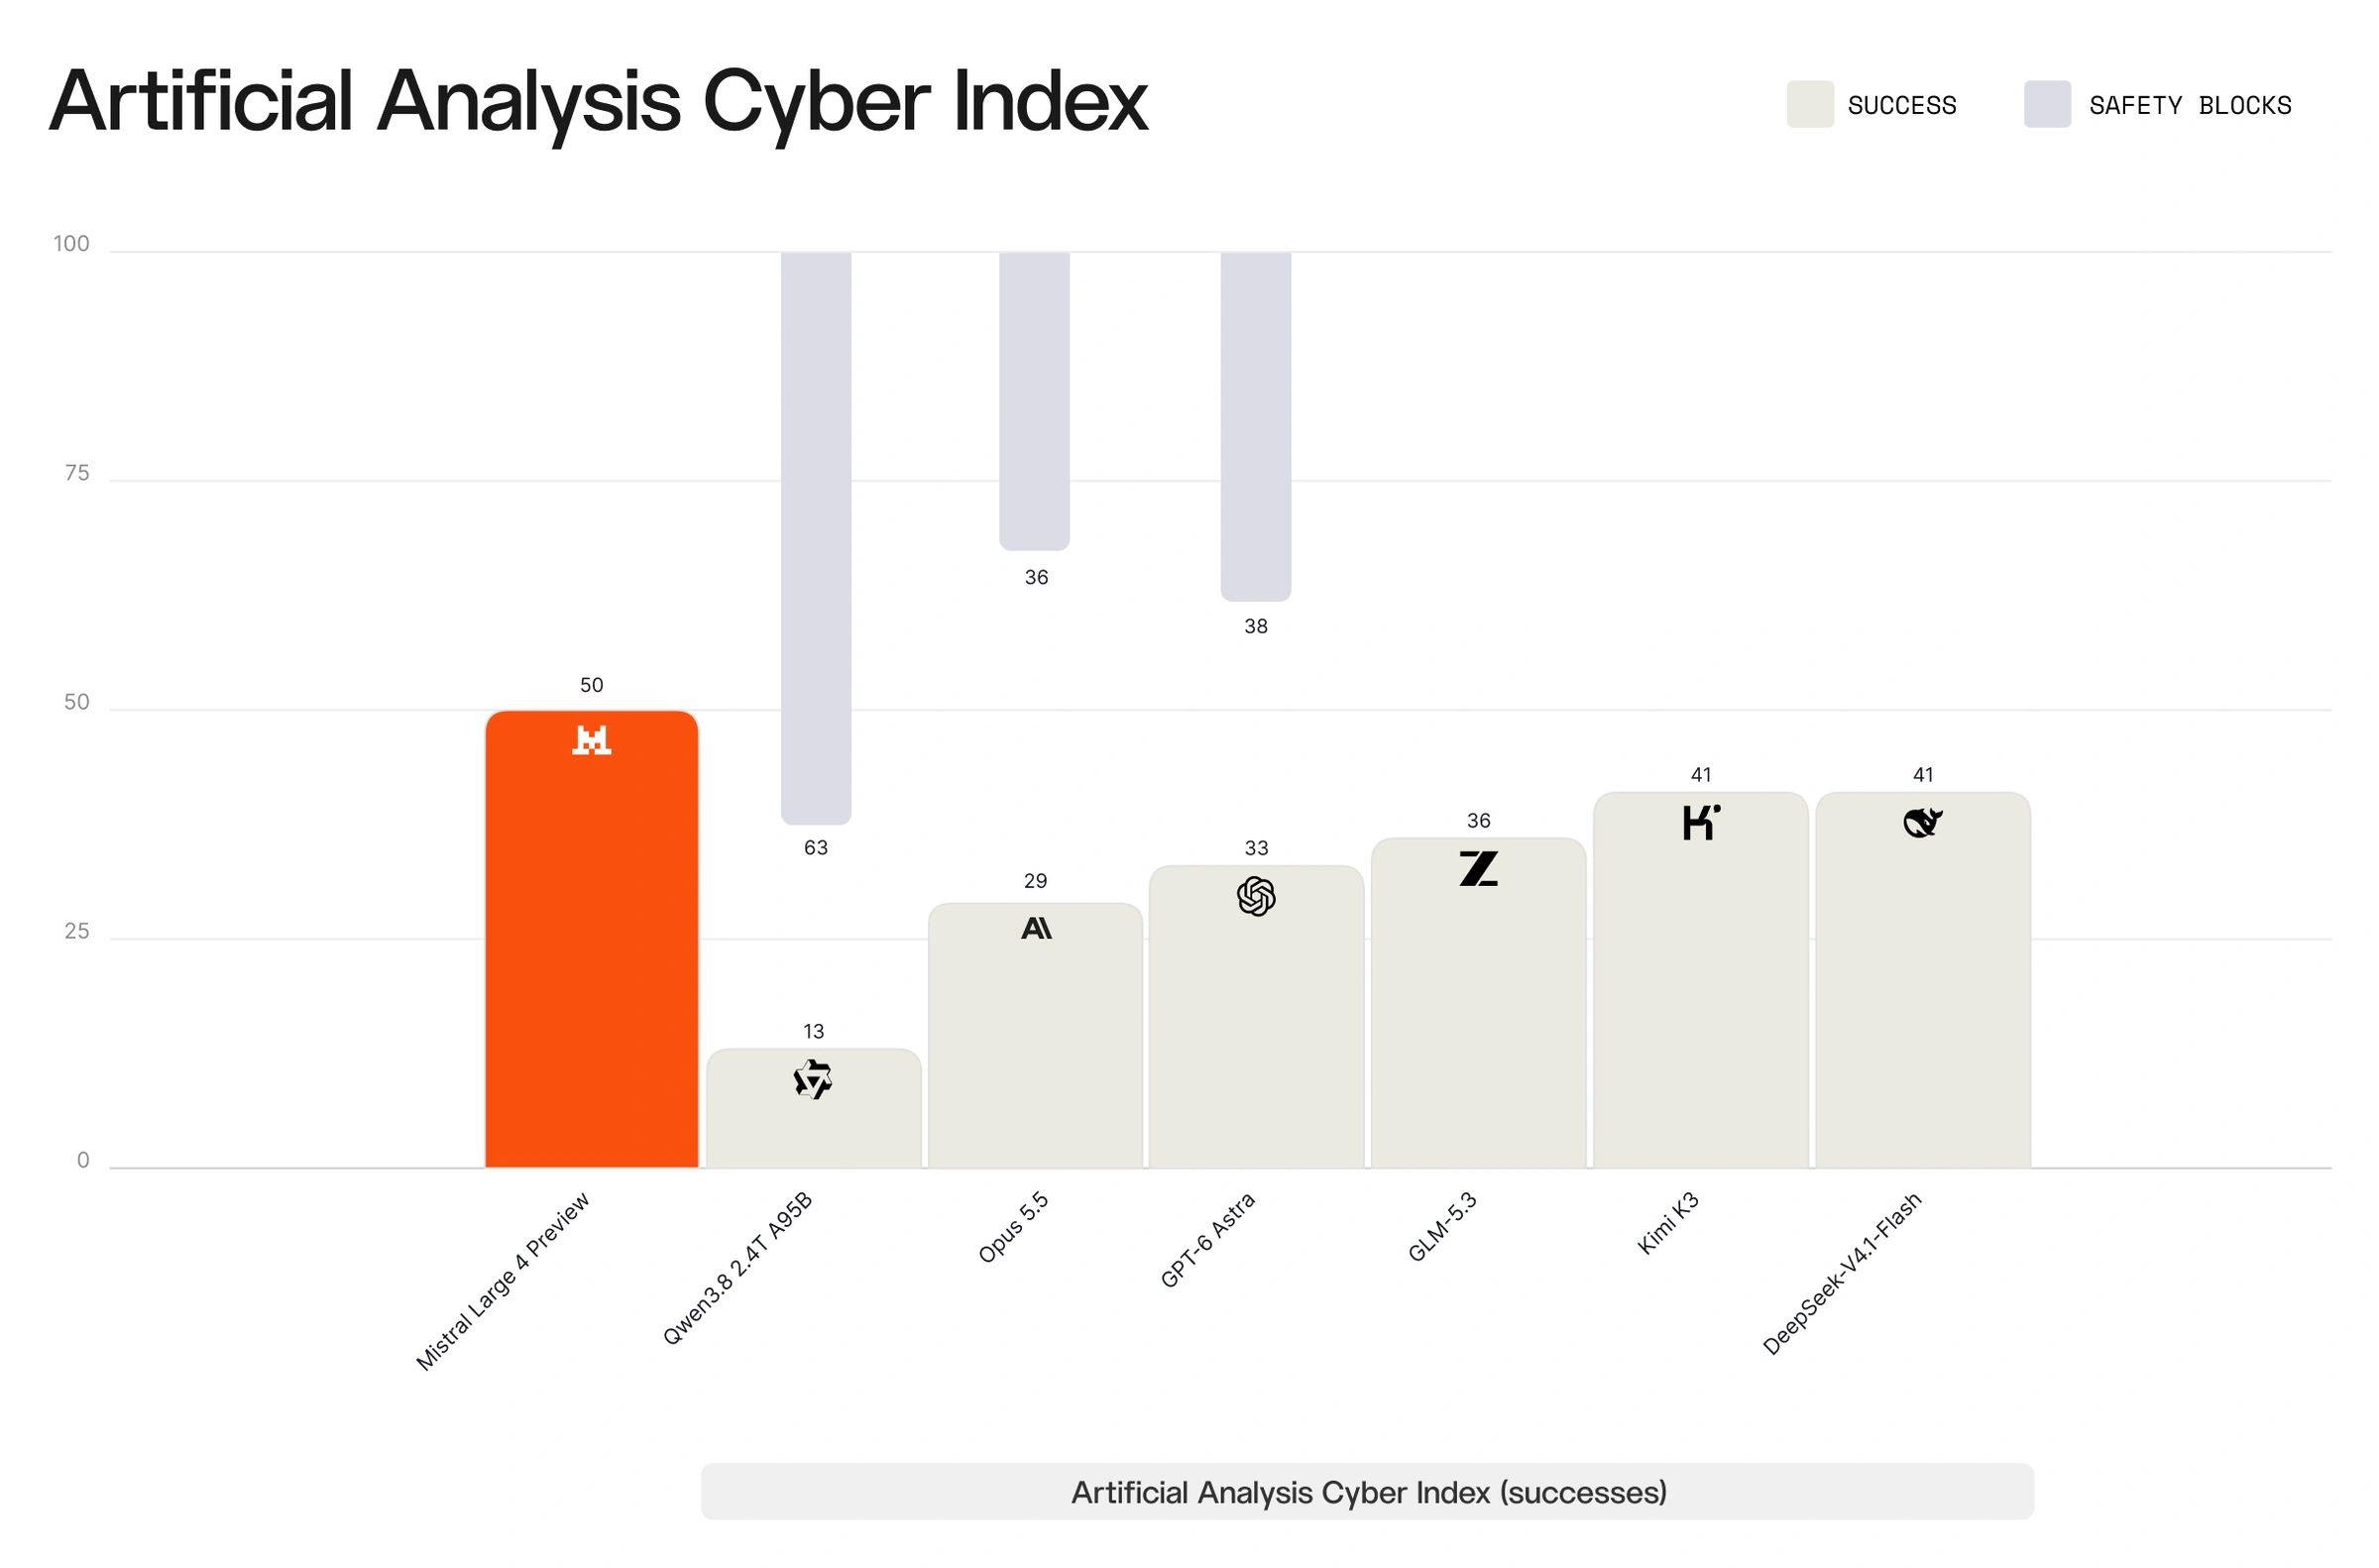
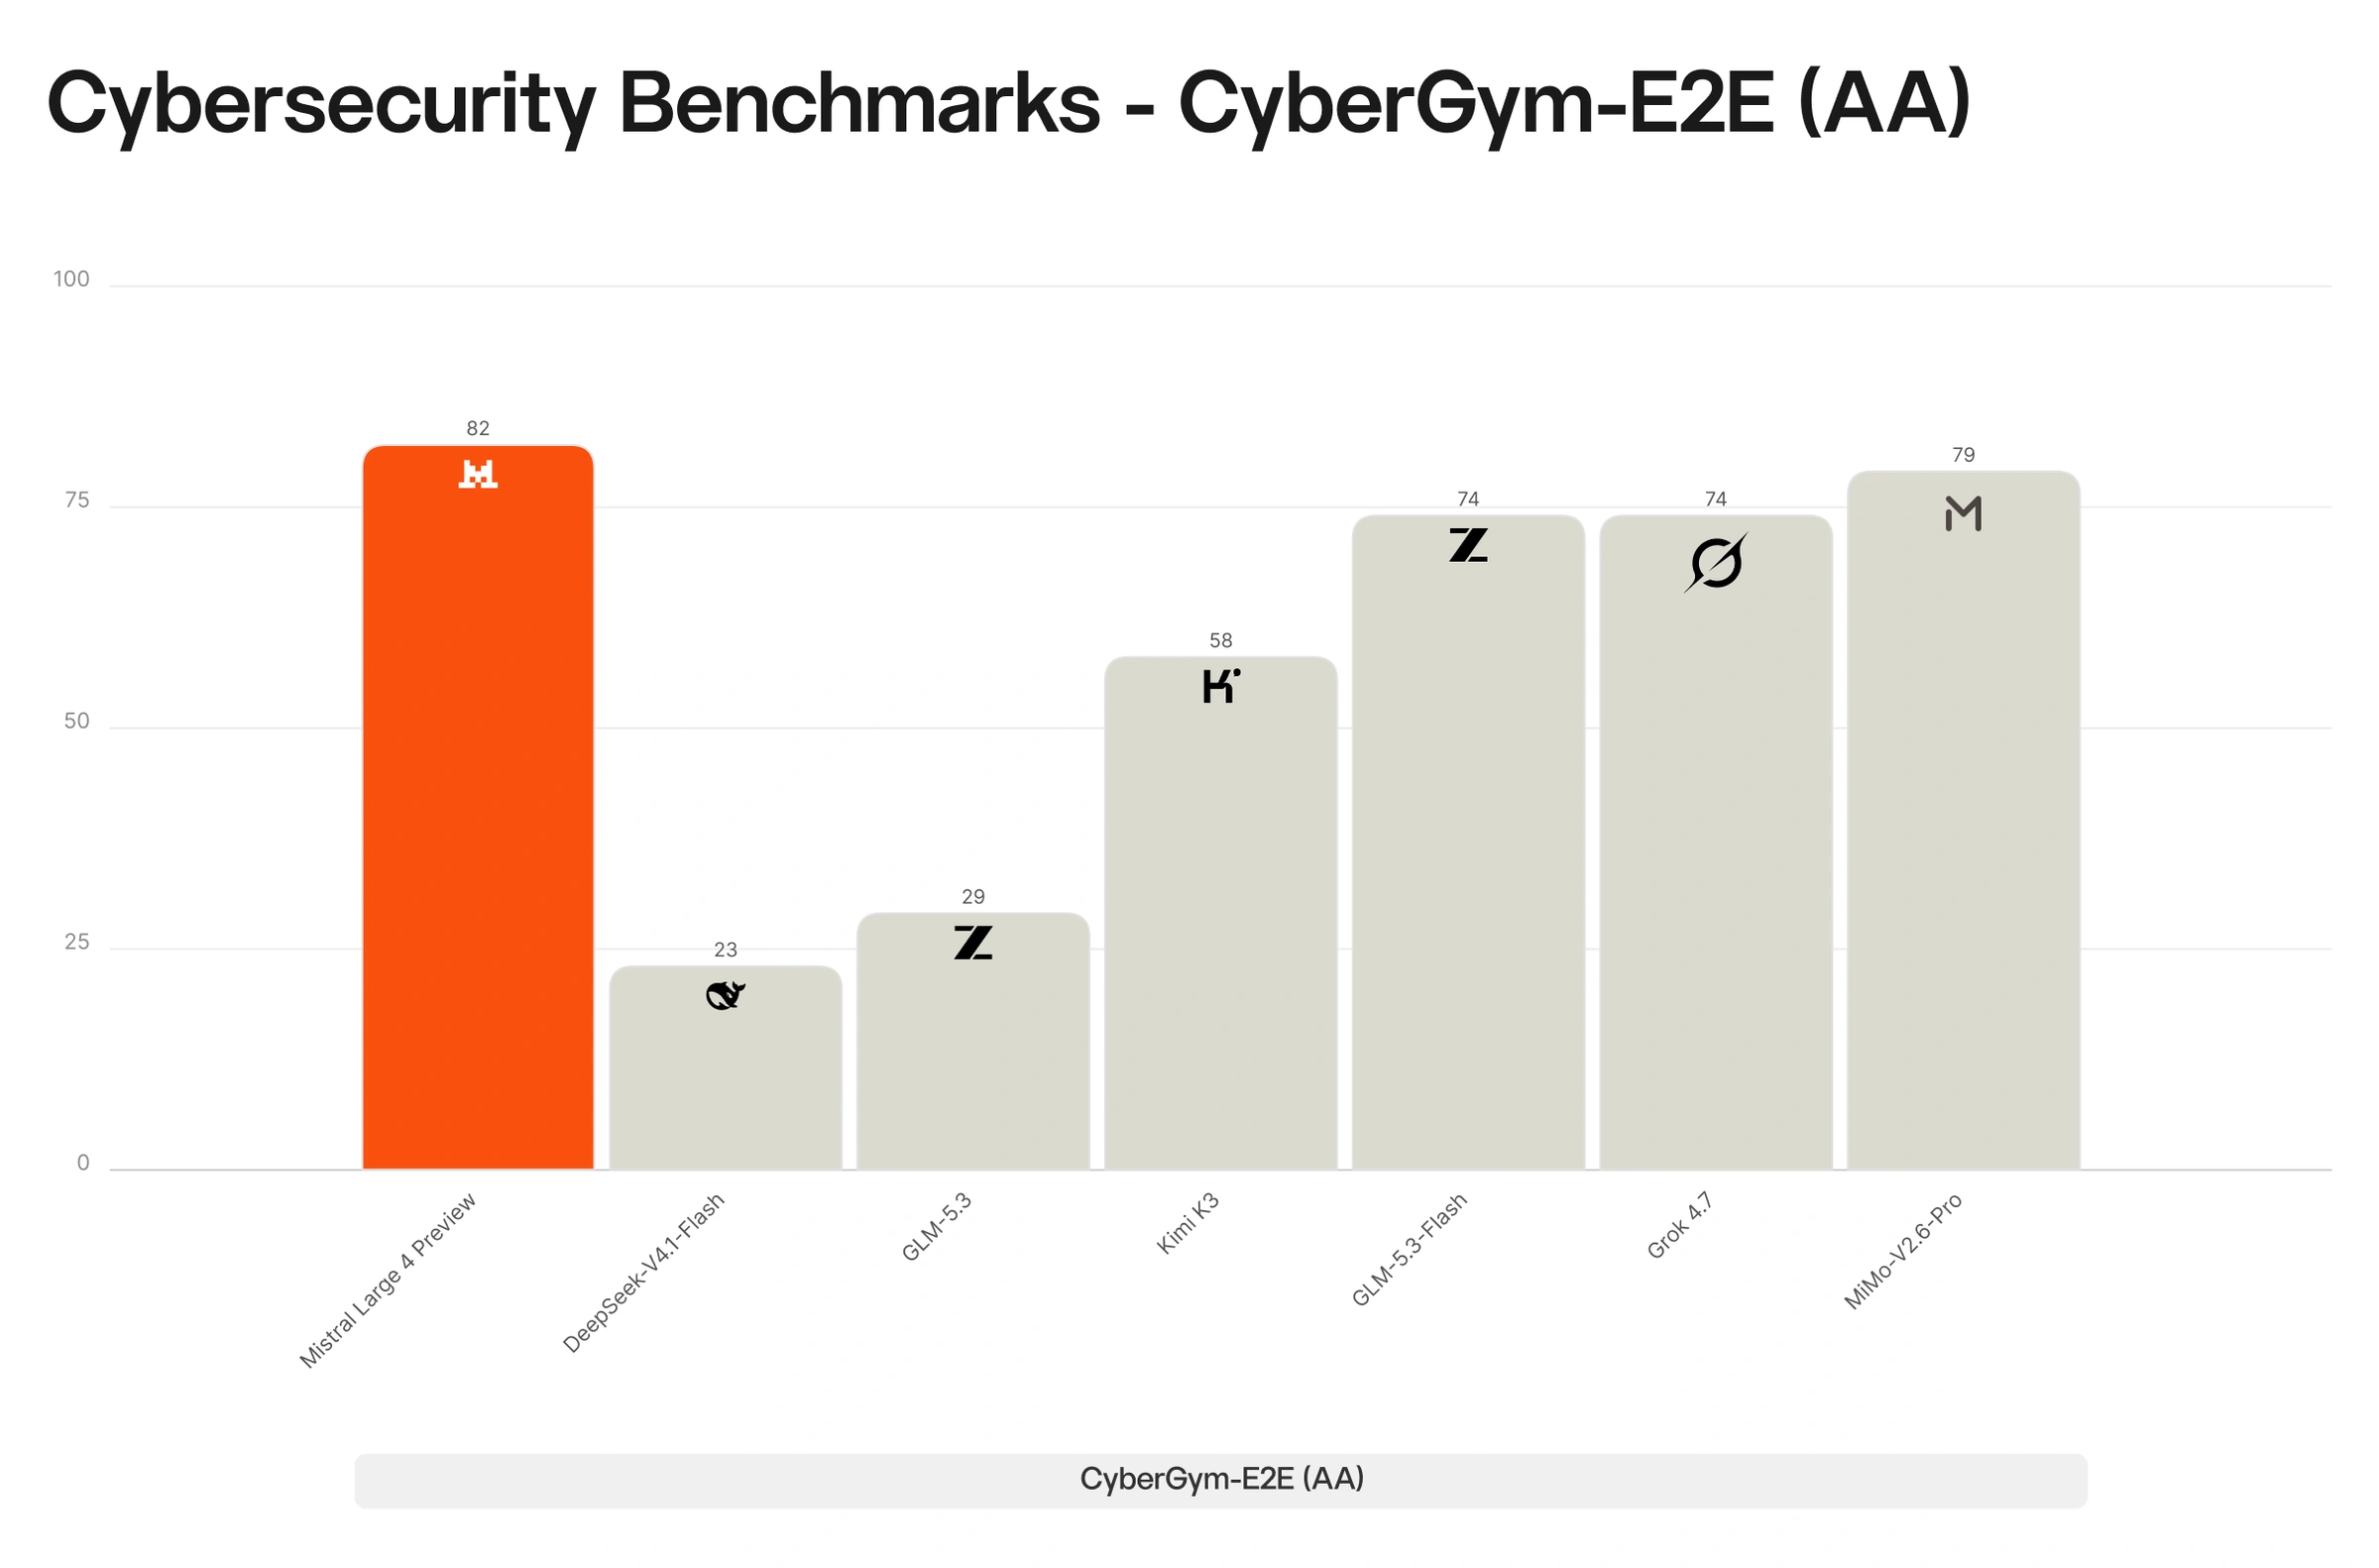
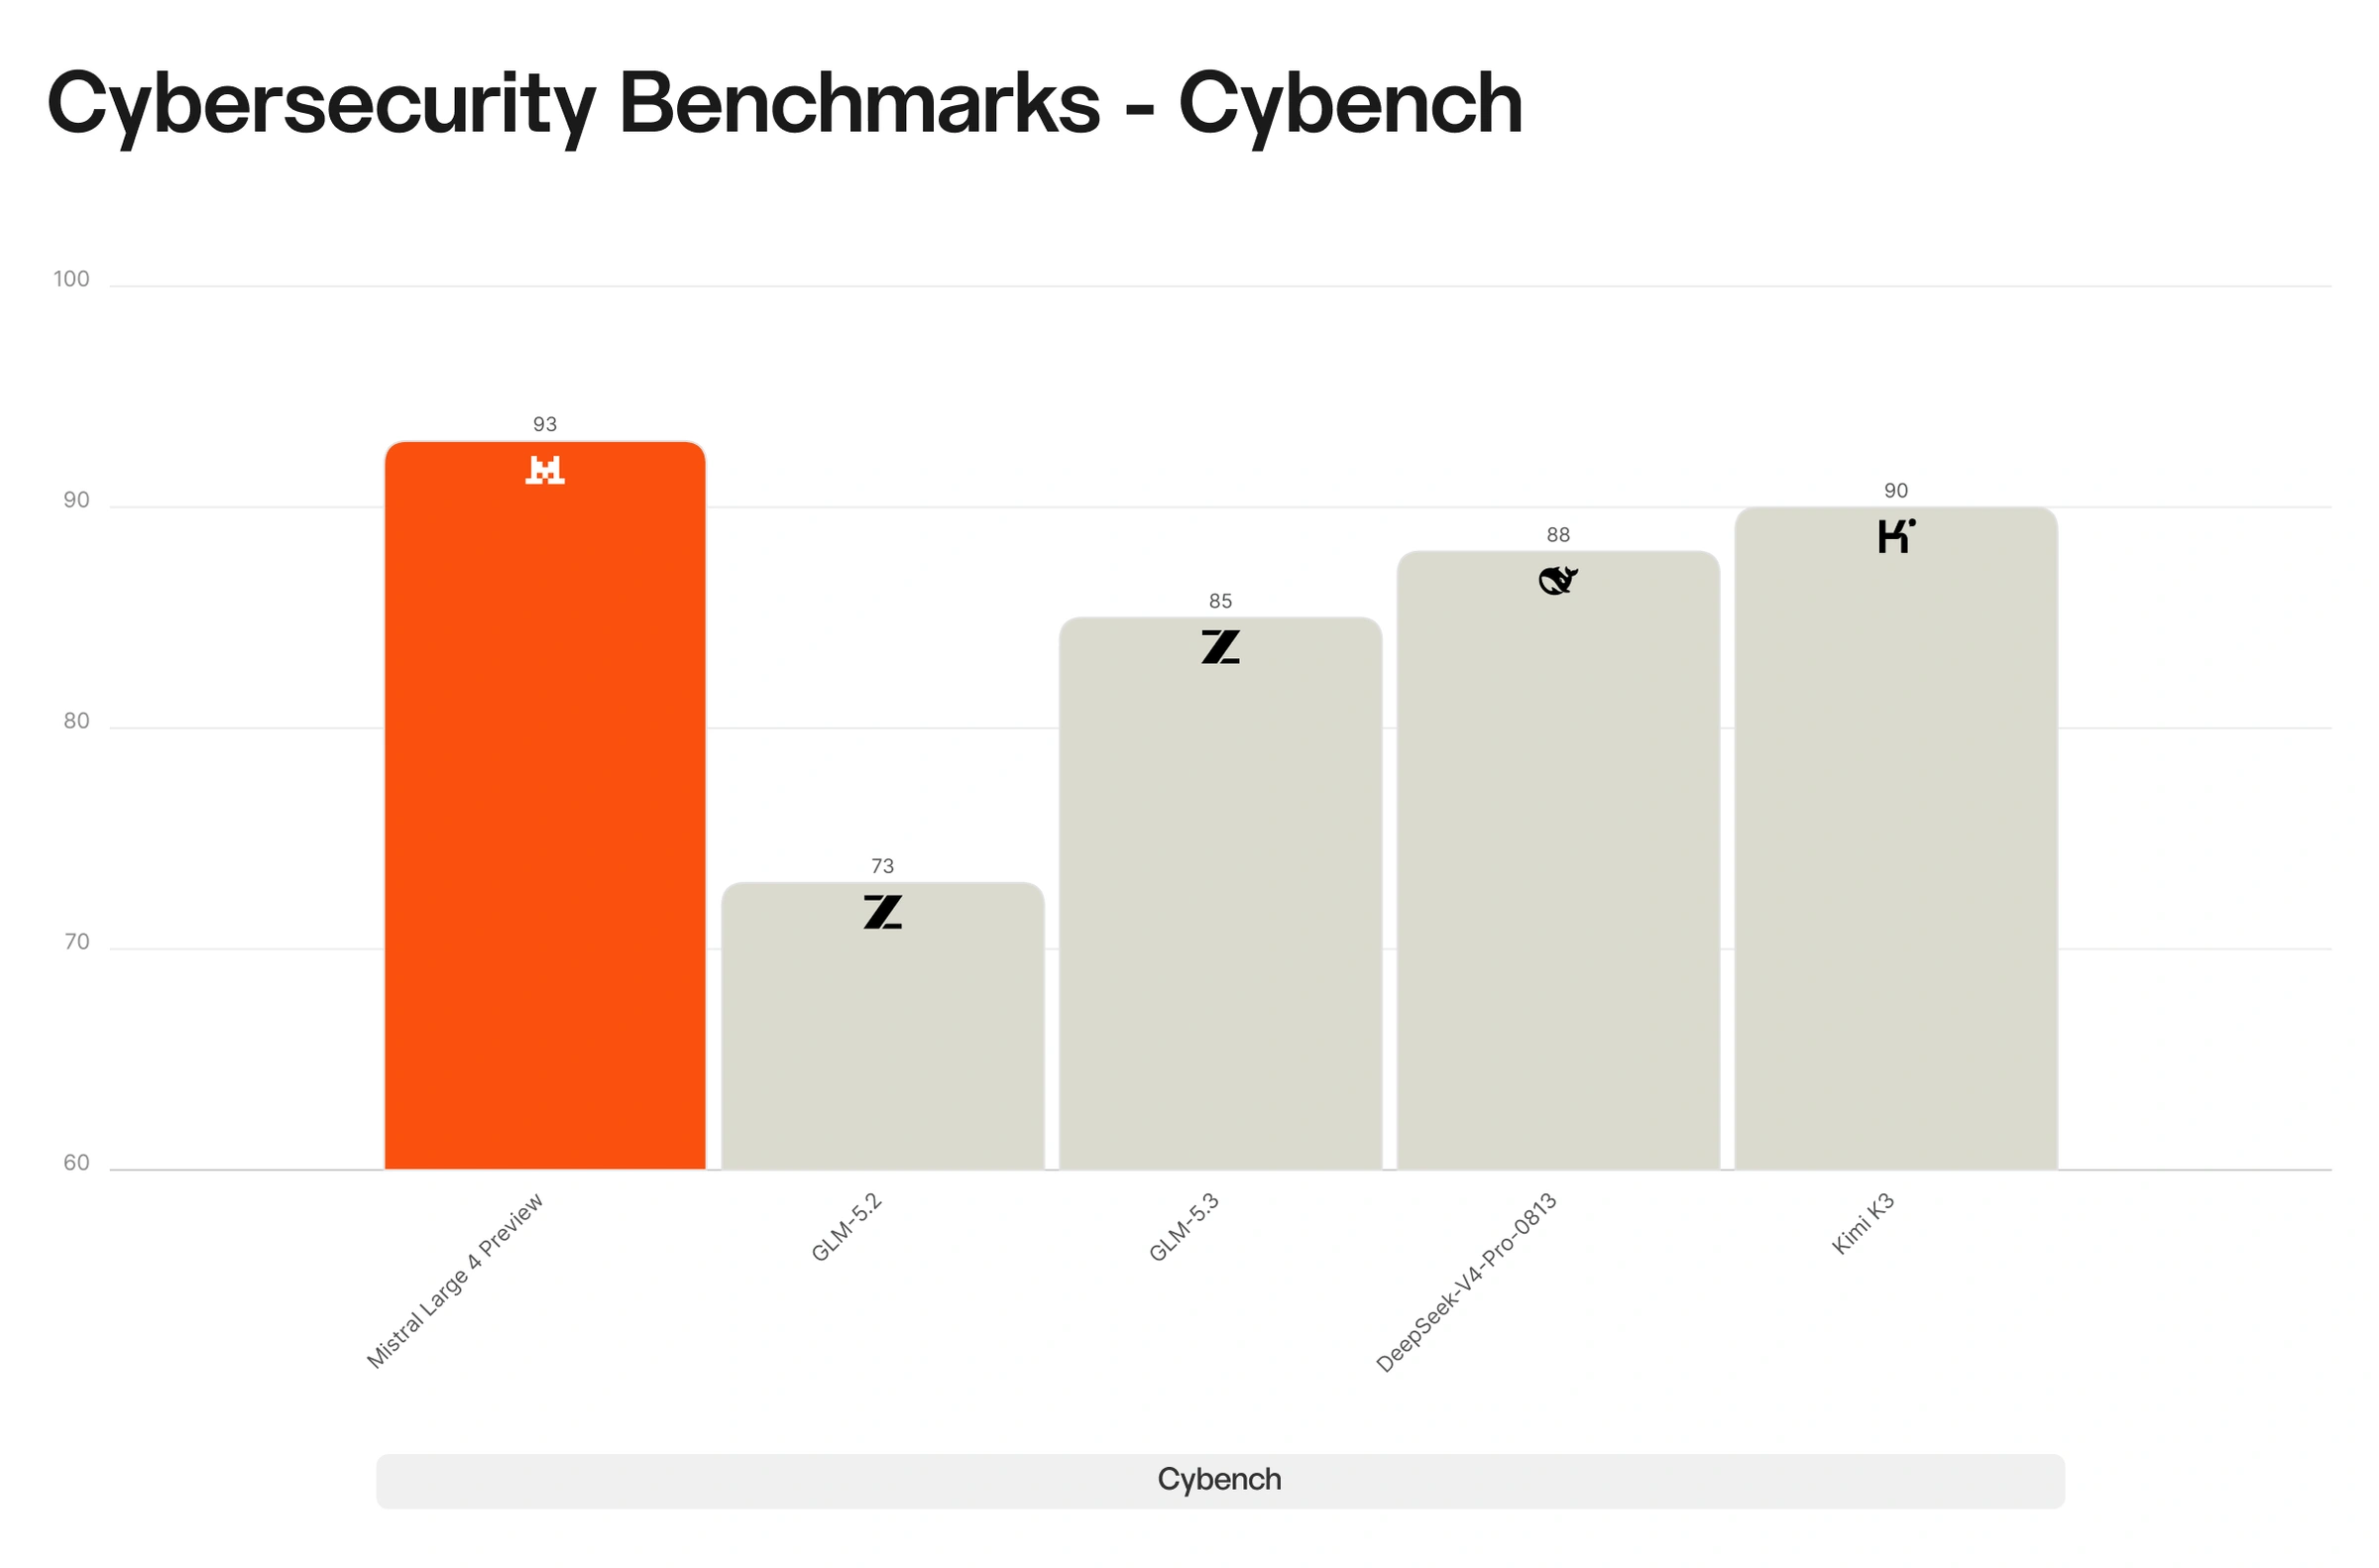
ML4 è uno dei modelli di IA più avanzati al mondo per la sicurezza informatica. Nell'Artificial Analysis Cyber Index, una valutazione indipendente della capacità dei modelli di IA di individuare e correggere falle di sicurezza in software reali, si colloca tra i primi cinque modelli a livello globale e supera con ampio margine i modelli a pesi aperti sviluppati al di fuori della Cina. In uno dei test dell'indice, che richiede al modello di riprodurre una vulnerabilità reale in un software open source e poi correggerla, ML4 ottiene l'82%, il punteggio più alto tra tutti i modelli. Risolve inoltre il 93% delle sfide di Cybench, un insieme di 40 esercizi tratti da competizioni di sicurezza informatica: uno dei punteggi più alti registrati per un modello a pesi aperti.
Questo primato si traduce in un vantaggio concreto. Diversi modelli chiusi di punta, tra cui Claude Opus 5.5 e GPT-6 Astra, ottengono punteggi prossimi allo zero nello stesso test perché rifiutano di svolgere il compito. Eppure, proteggere un software inizia spesso dal dimostrare che una falla è reale: proprio il tipo di attività che i filtri di sicurezza dei modelli chiusi possono bloccare. Questo aspetto è ancora più importante ora che gli attori malevoli ricorrono sempre più al jailbreak di quegli stessi modelli per supportare attività informatiche offensive: chi difende i sistemi ha bisogno di strumenti con capacità equivalenti, senza essere vincolato dagli stessi rifiuti. ML4 può svolgere queste attività e le sue capacità vanno oltre quelle per cui è stato esplicitamente addestrato: nei test interni si è dimostrato utile per analizzare malware, definire le priorità delle vulnerabilità e scrivere regole di rilevamento. Le organizzazioni che necessitano di un'IA sovrana e verificabile per le operazioni di sicurezza potranno eseguirlo su cloud privato o on-premise.
ML4 a confronto con gli altri modelli: ragionamento efficiente su sfide complesse e diversificate
Reverse engineering del malware: risoluzione di un compito di analisi fuori distribuzione
Sviluppo con agenti IA
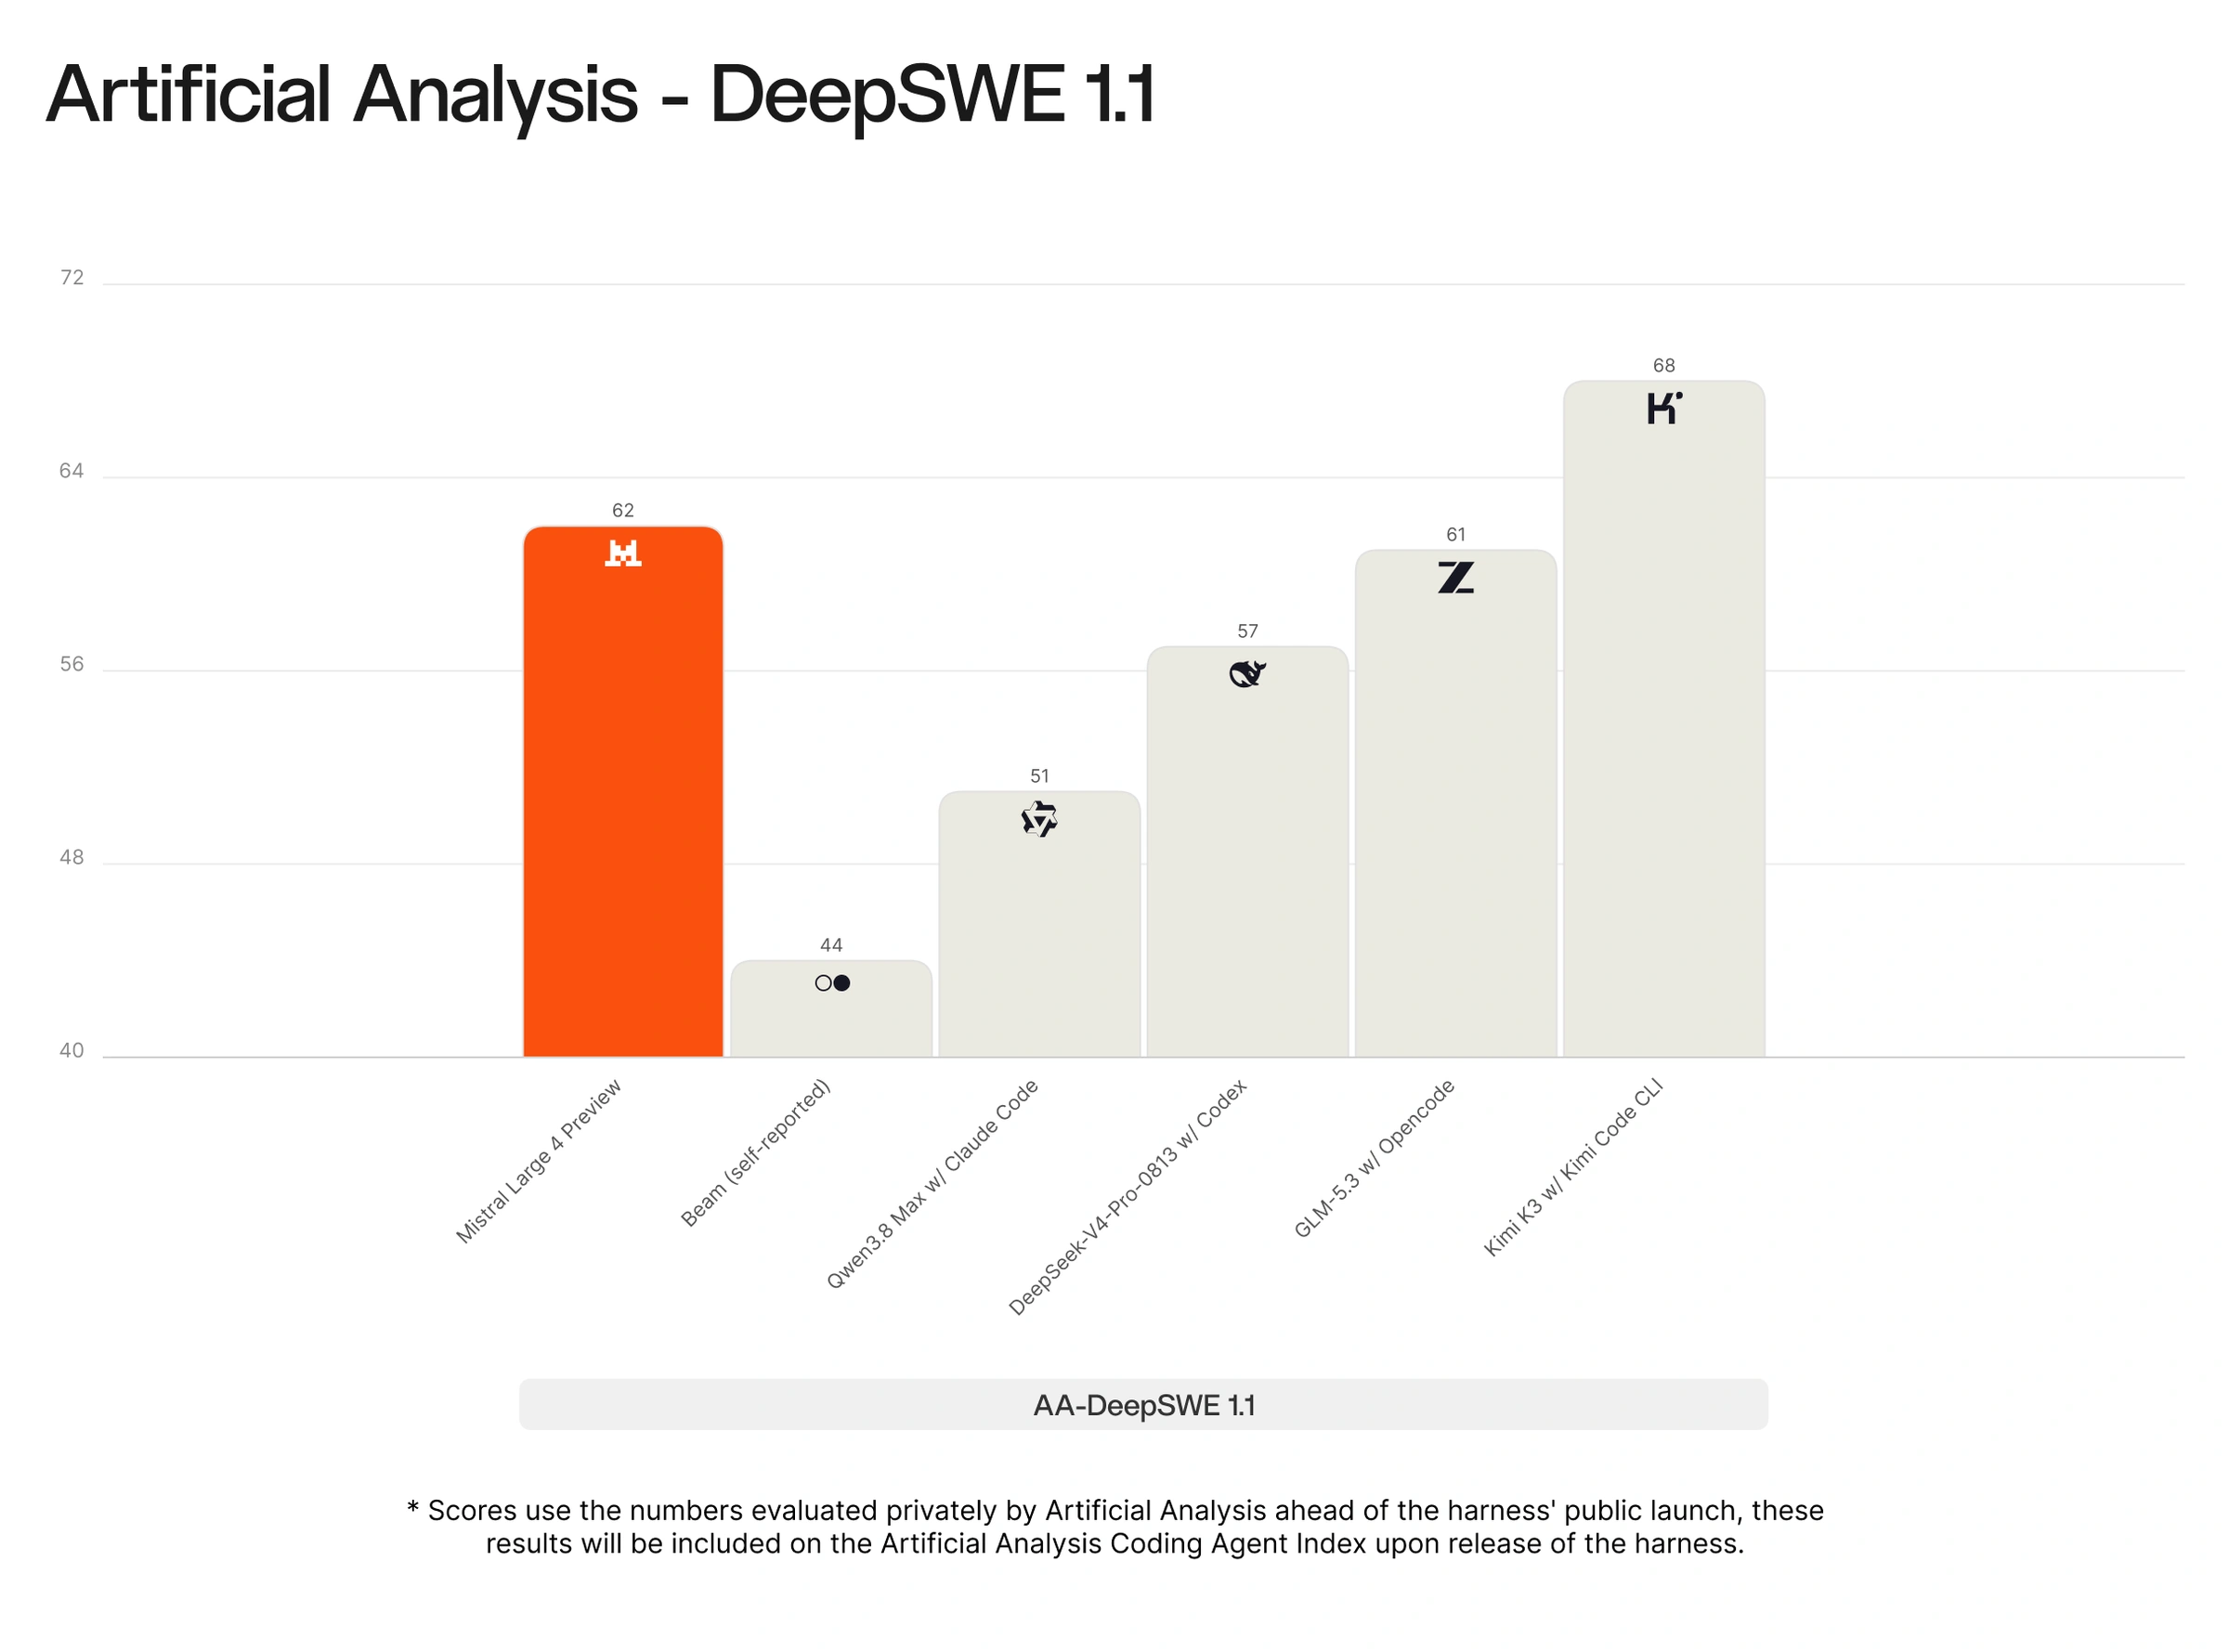
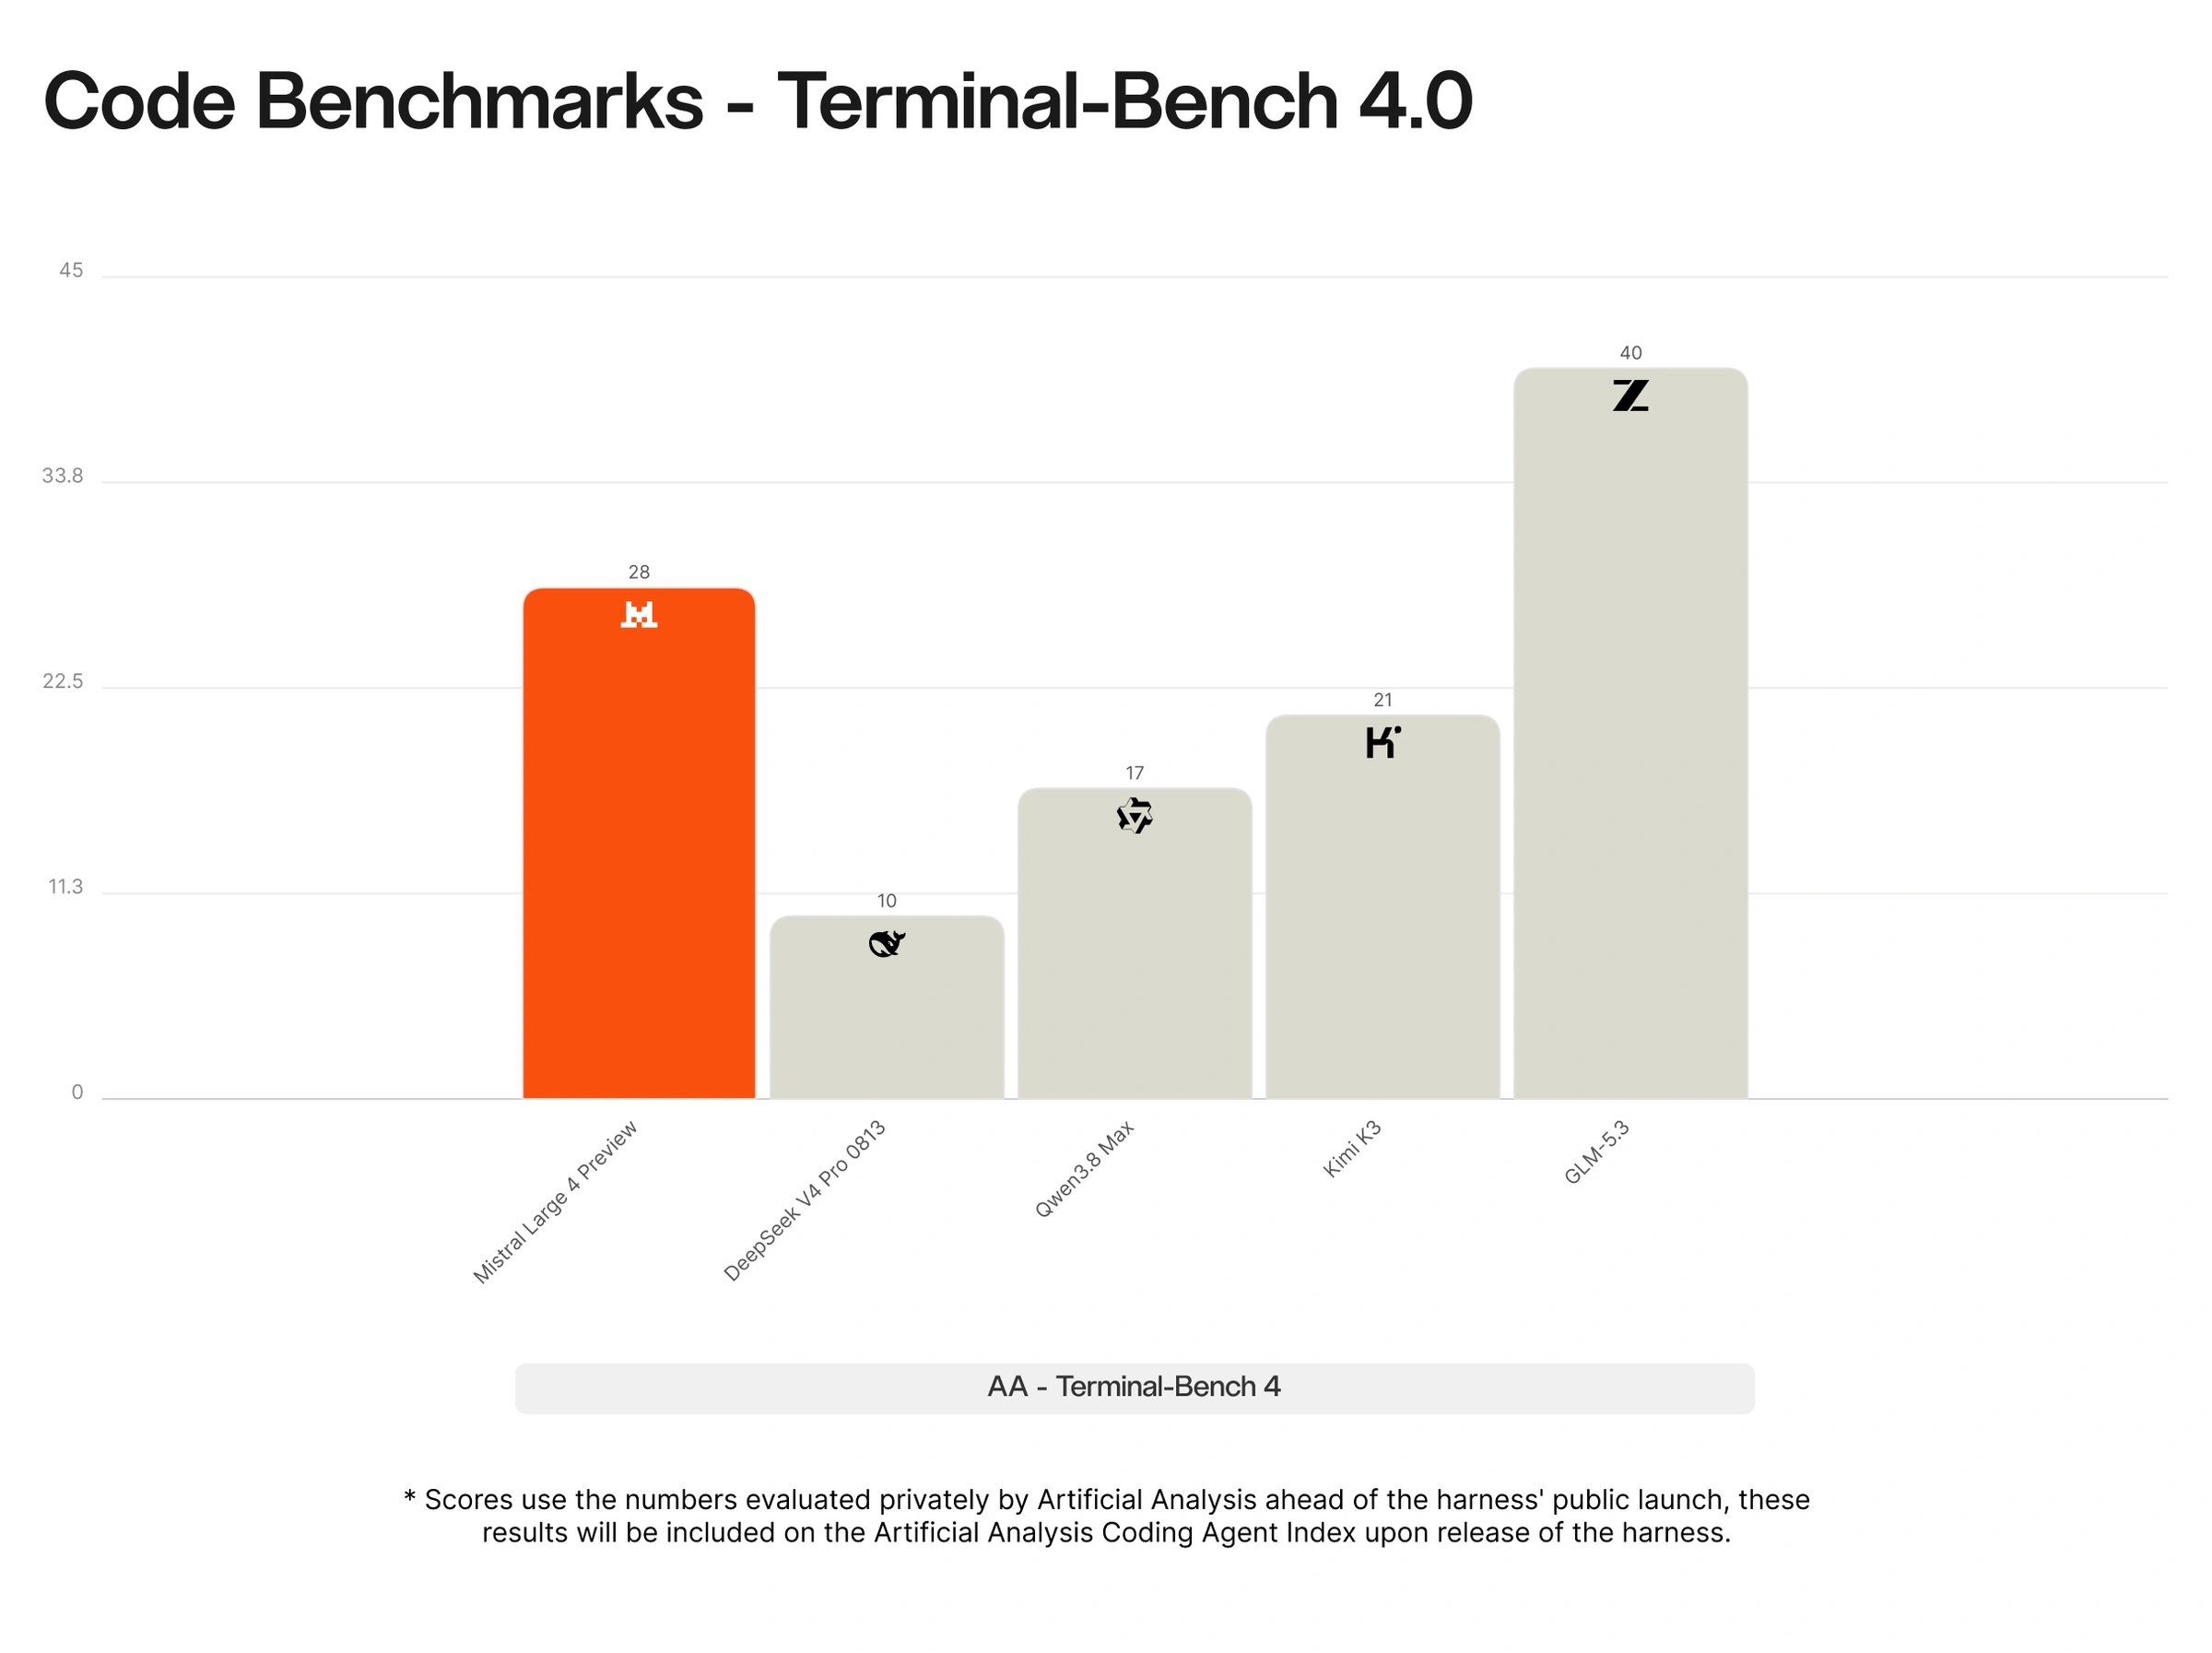
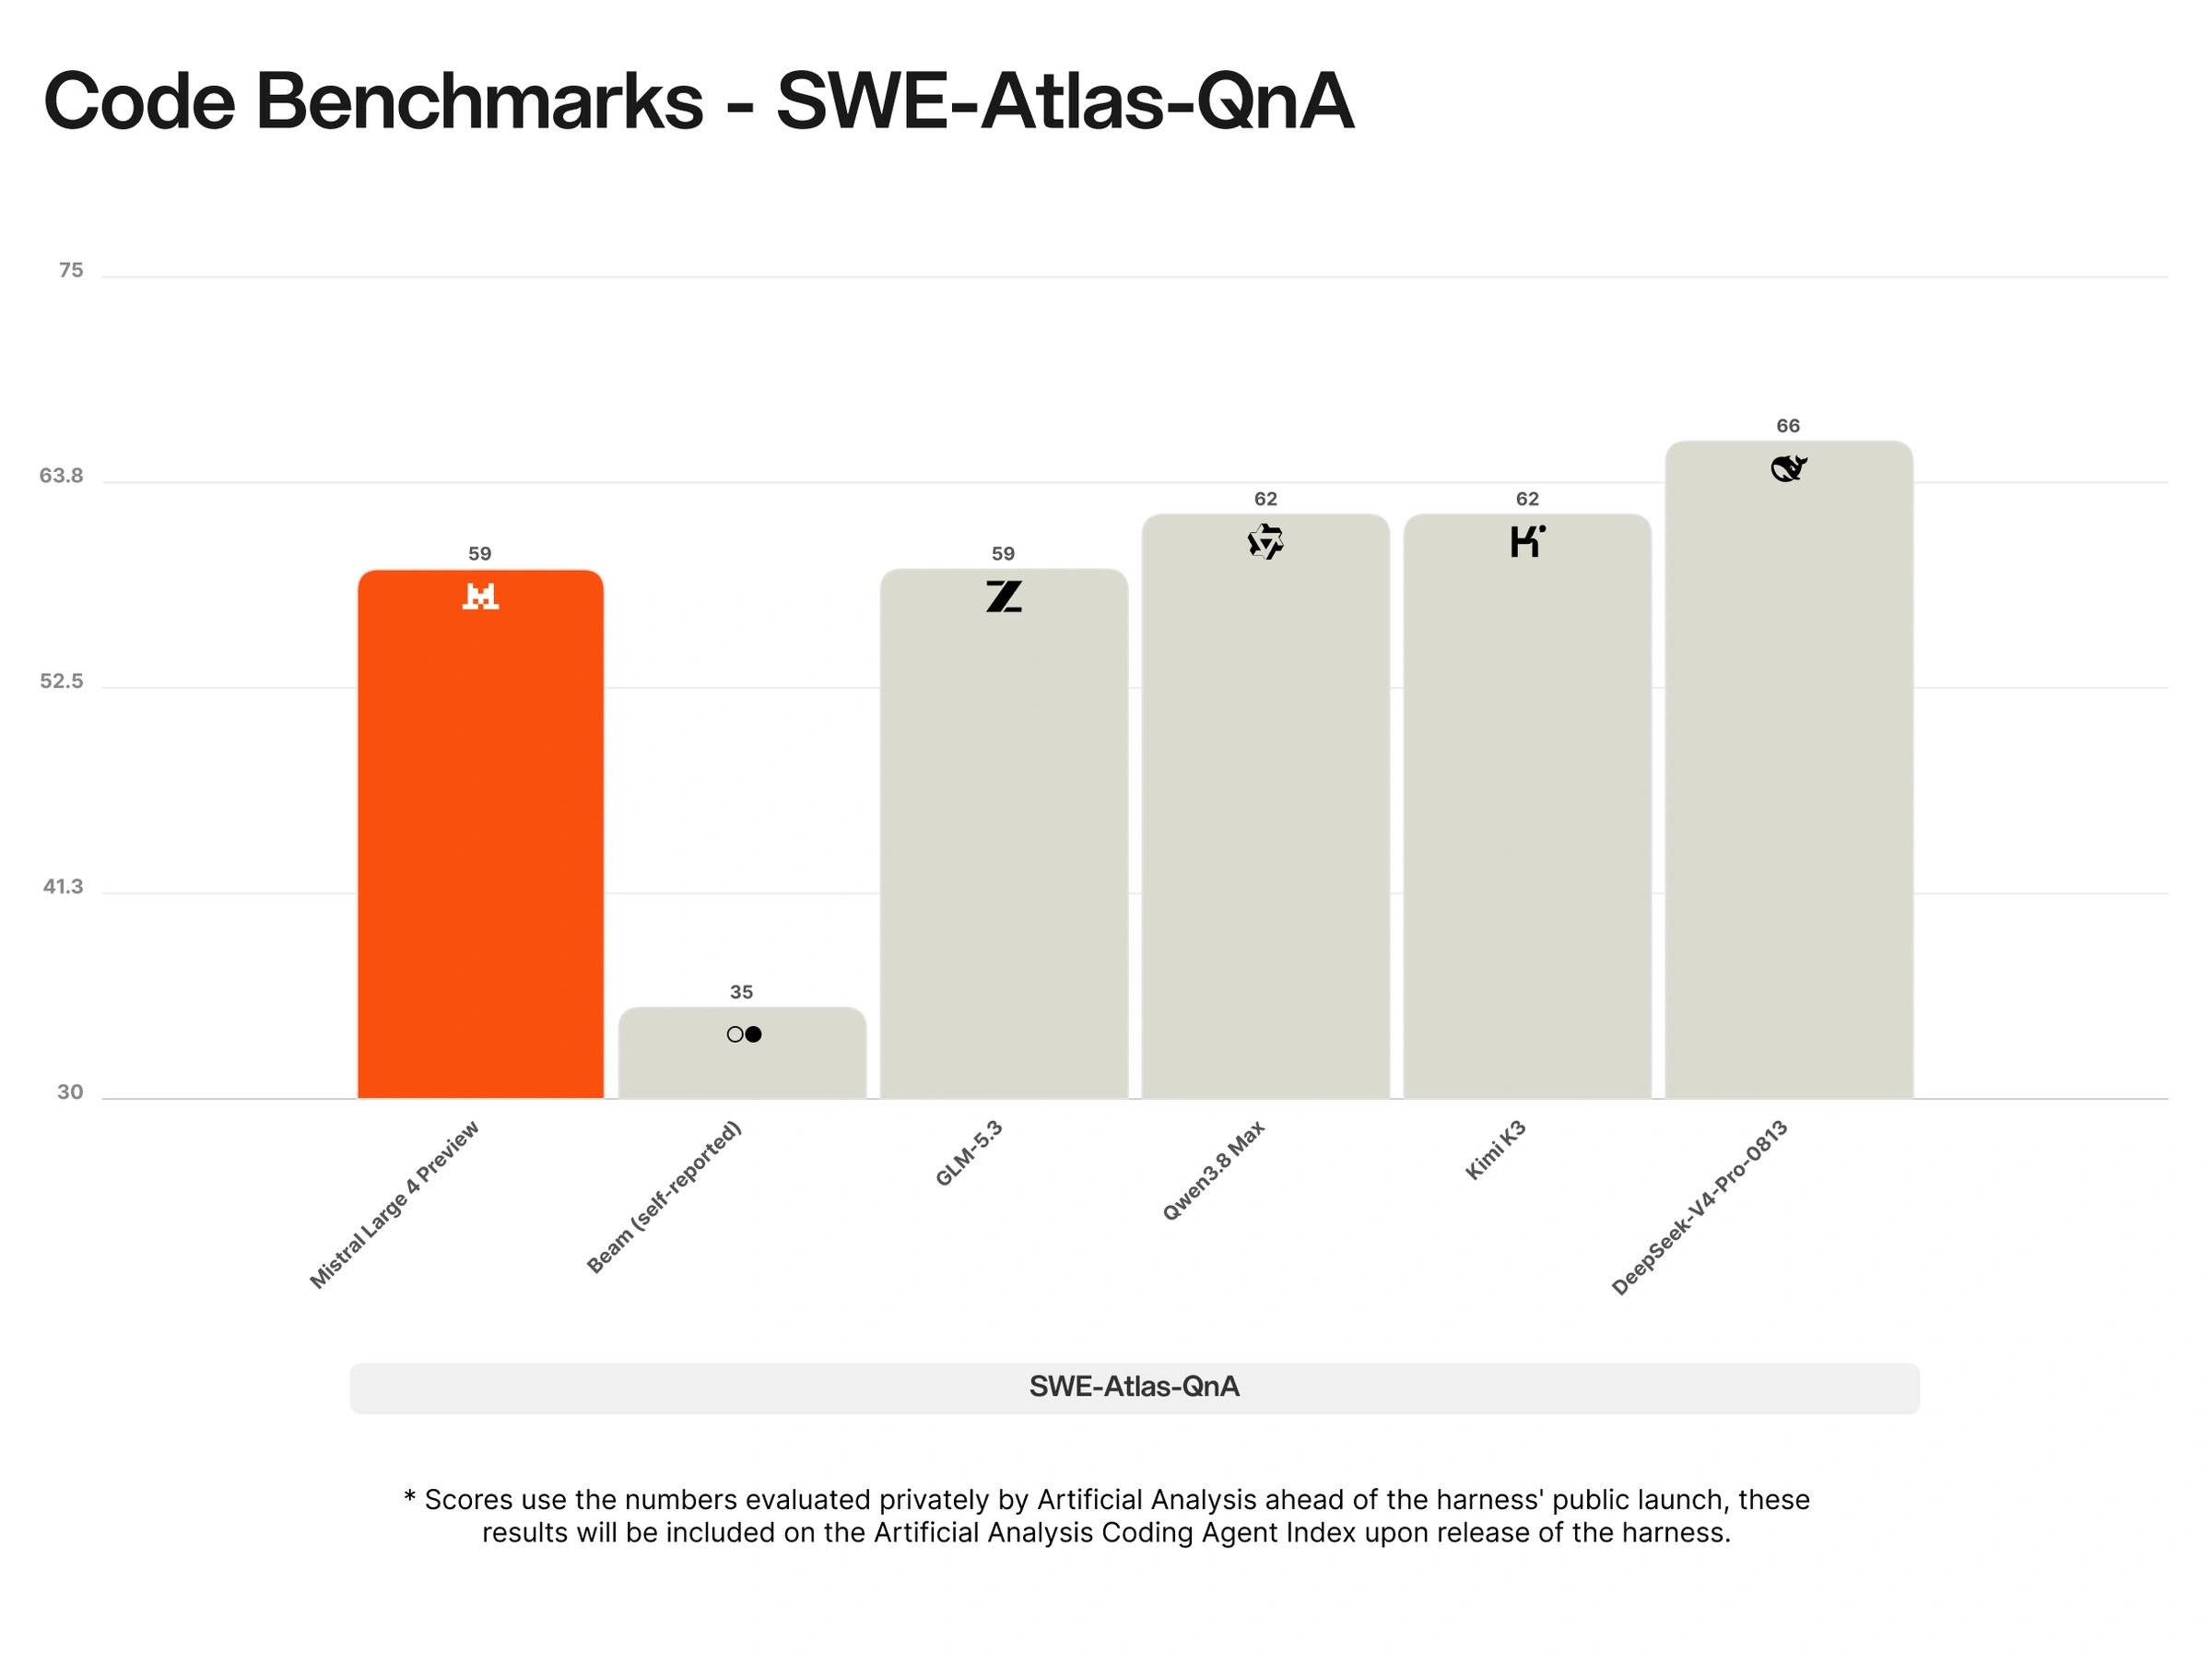
ML4 eccelle nell'ingegneria del software, nella comprensione dei repository e nei flussi di lavoro complessi da terminale, ottenendo il 61,7% su DeepSWE v1.1, il 59,4% su SWE-Atlas-QnA e il 28,3% su Terminal-Bench 4. Il suo punteggio complessivo del 49,8% nel Coding Agent Index lo colloca davanti a DeepSeek V4 Pro 0813 e Qwen3.8 Max.
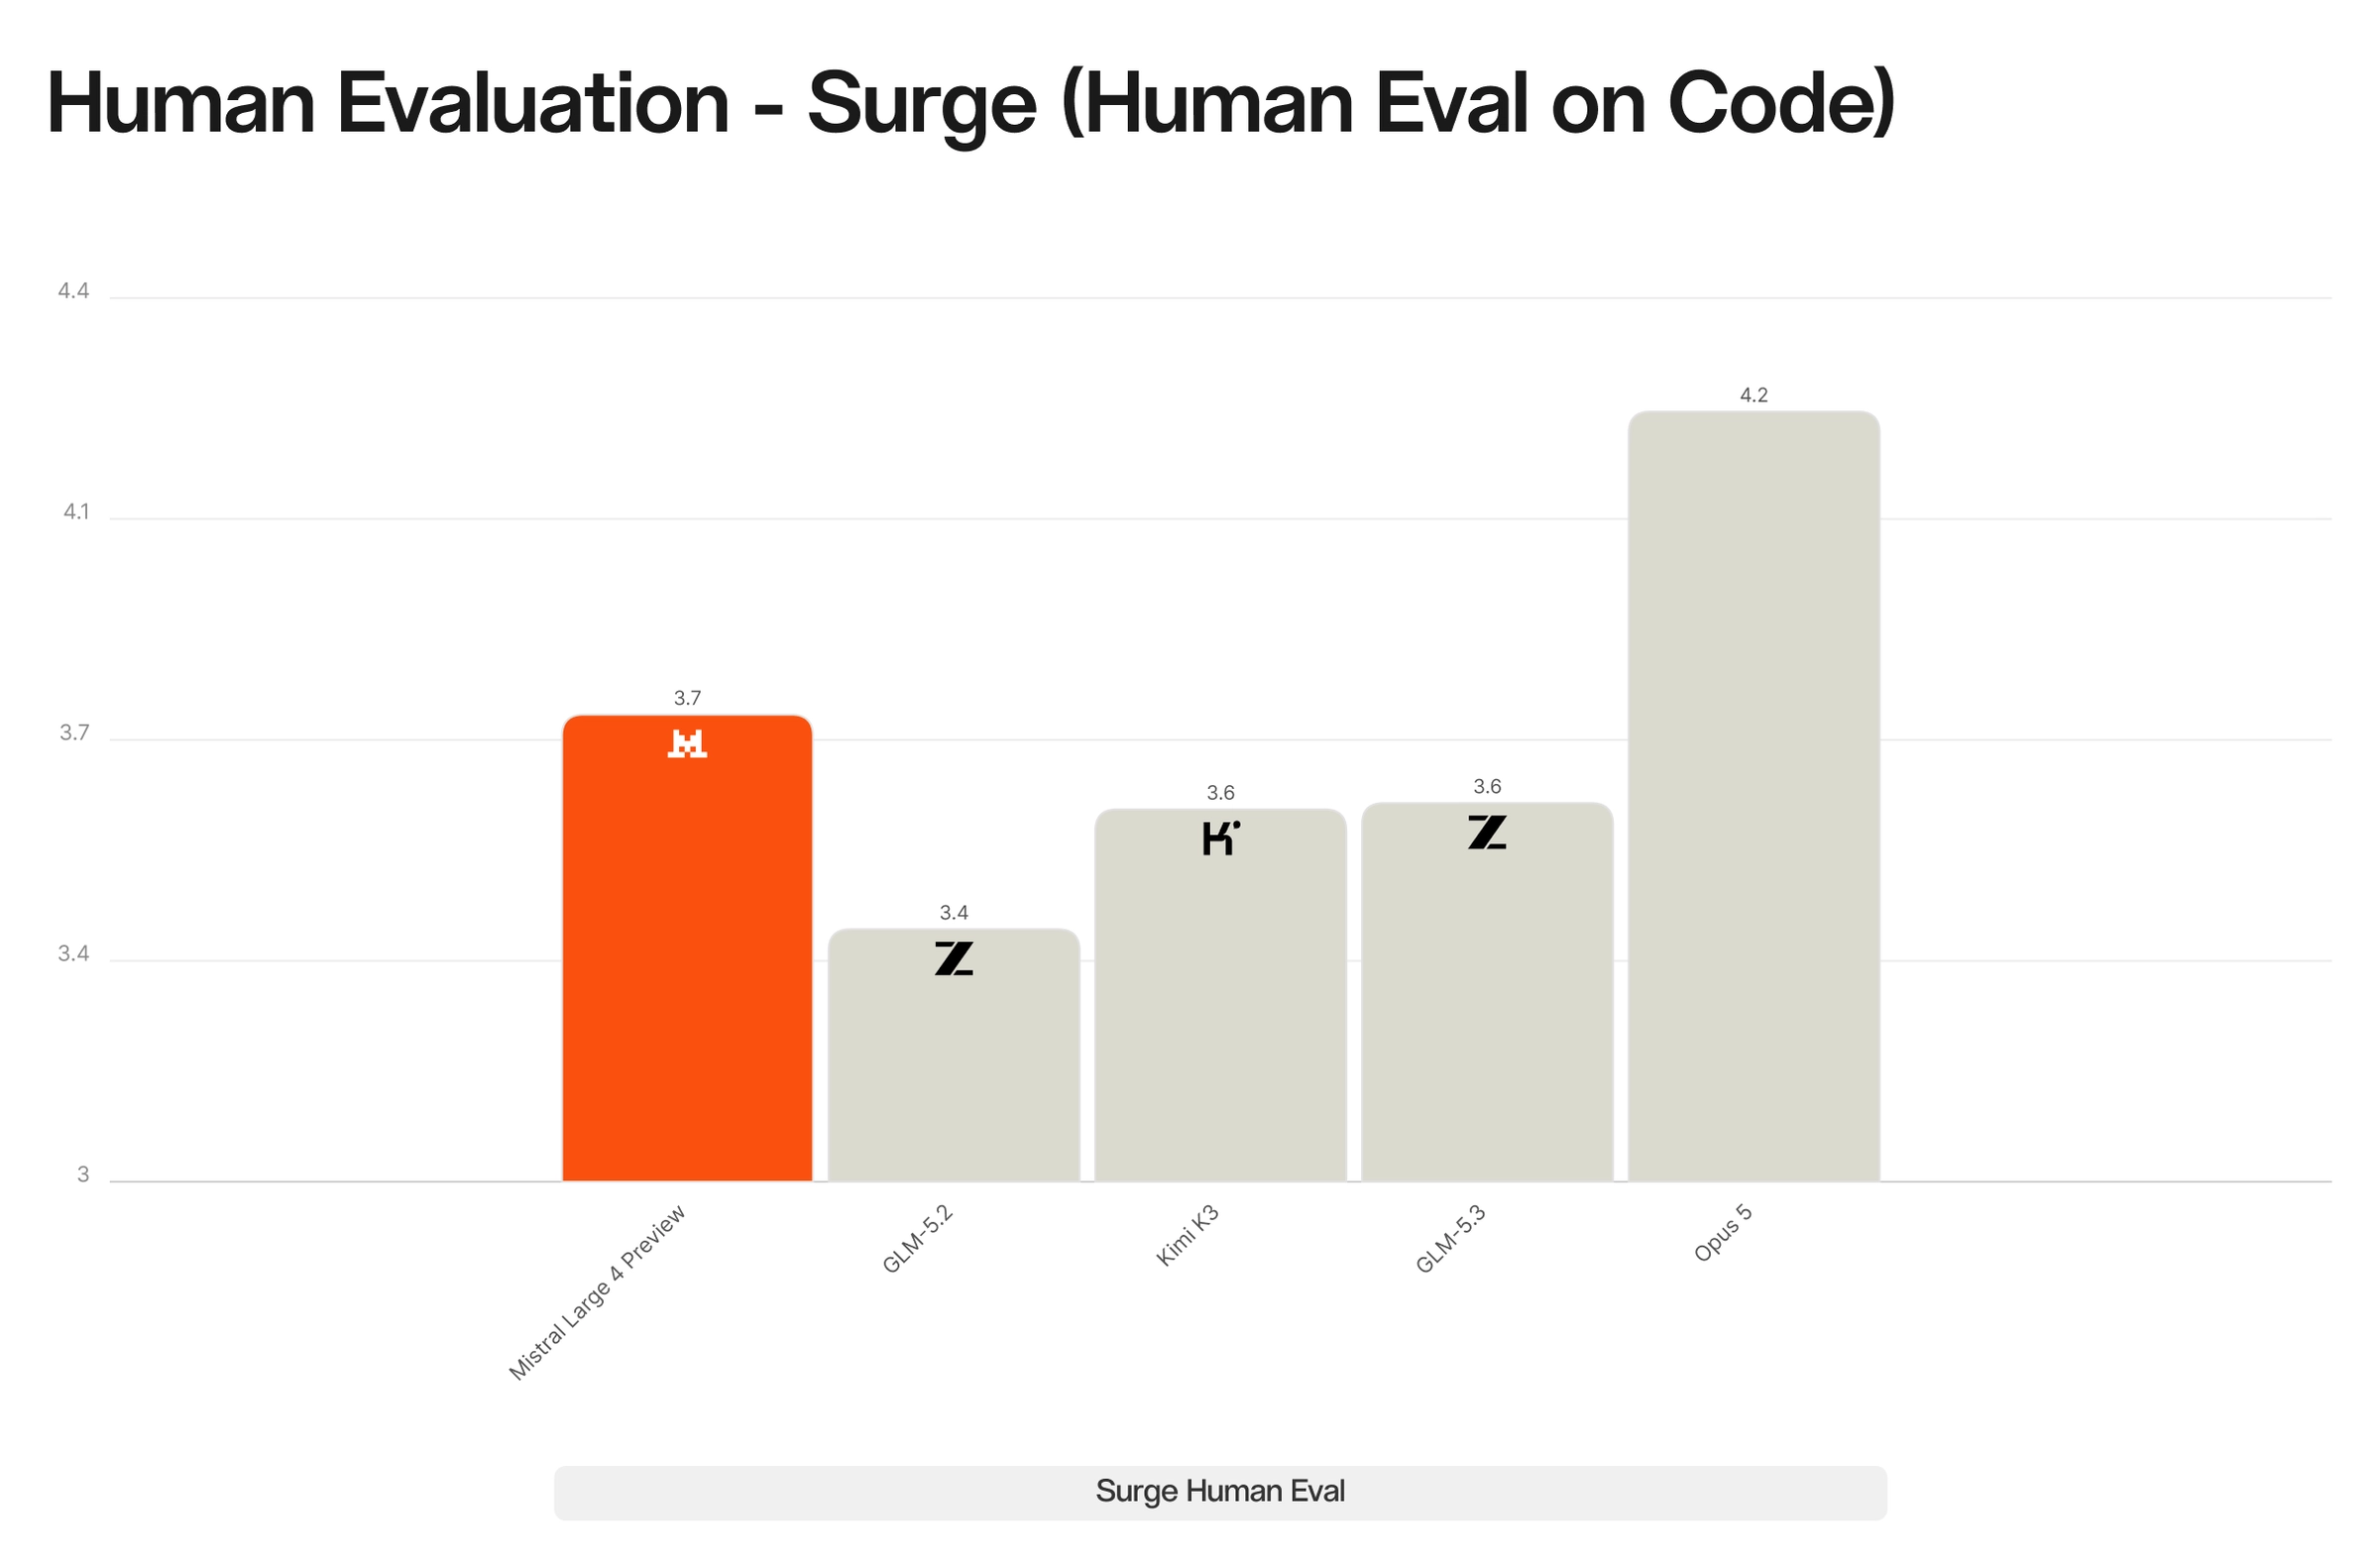
Abbiamo inoltre condotto con Surge AI una valutazione umana in cieco sulla qualità della codifica: annotatori professionisti hanno valutato gli output dei modelli su una scala da 1 a 5, senza conoscerne l'identità. ML4 Preview si è classificato secondo su cinque modelli (3,74), davanti a Kimi K3 (3,59), GLM-5.3 (3,60) e GLM-5.2 (3,40), e dietro soltanto a Claude Opus 5 (4,22).
Flussi di lavoro agentici
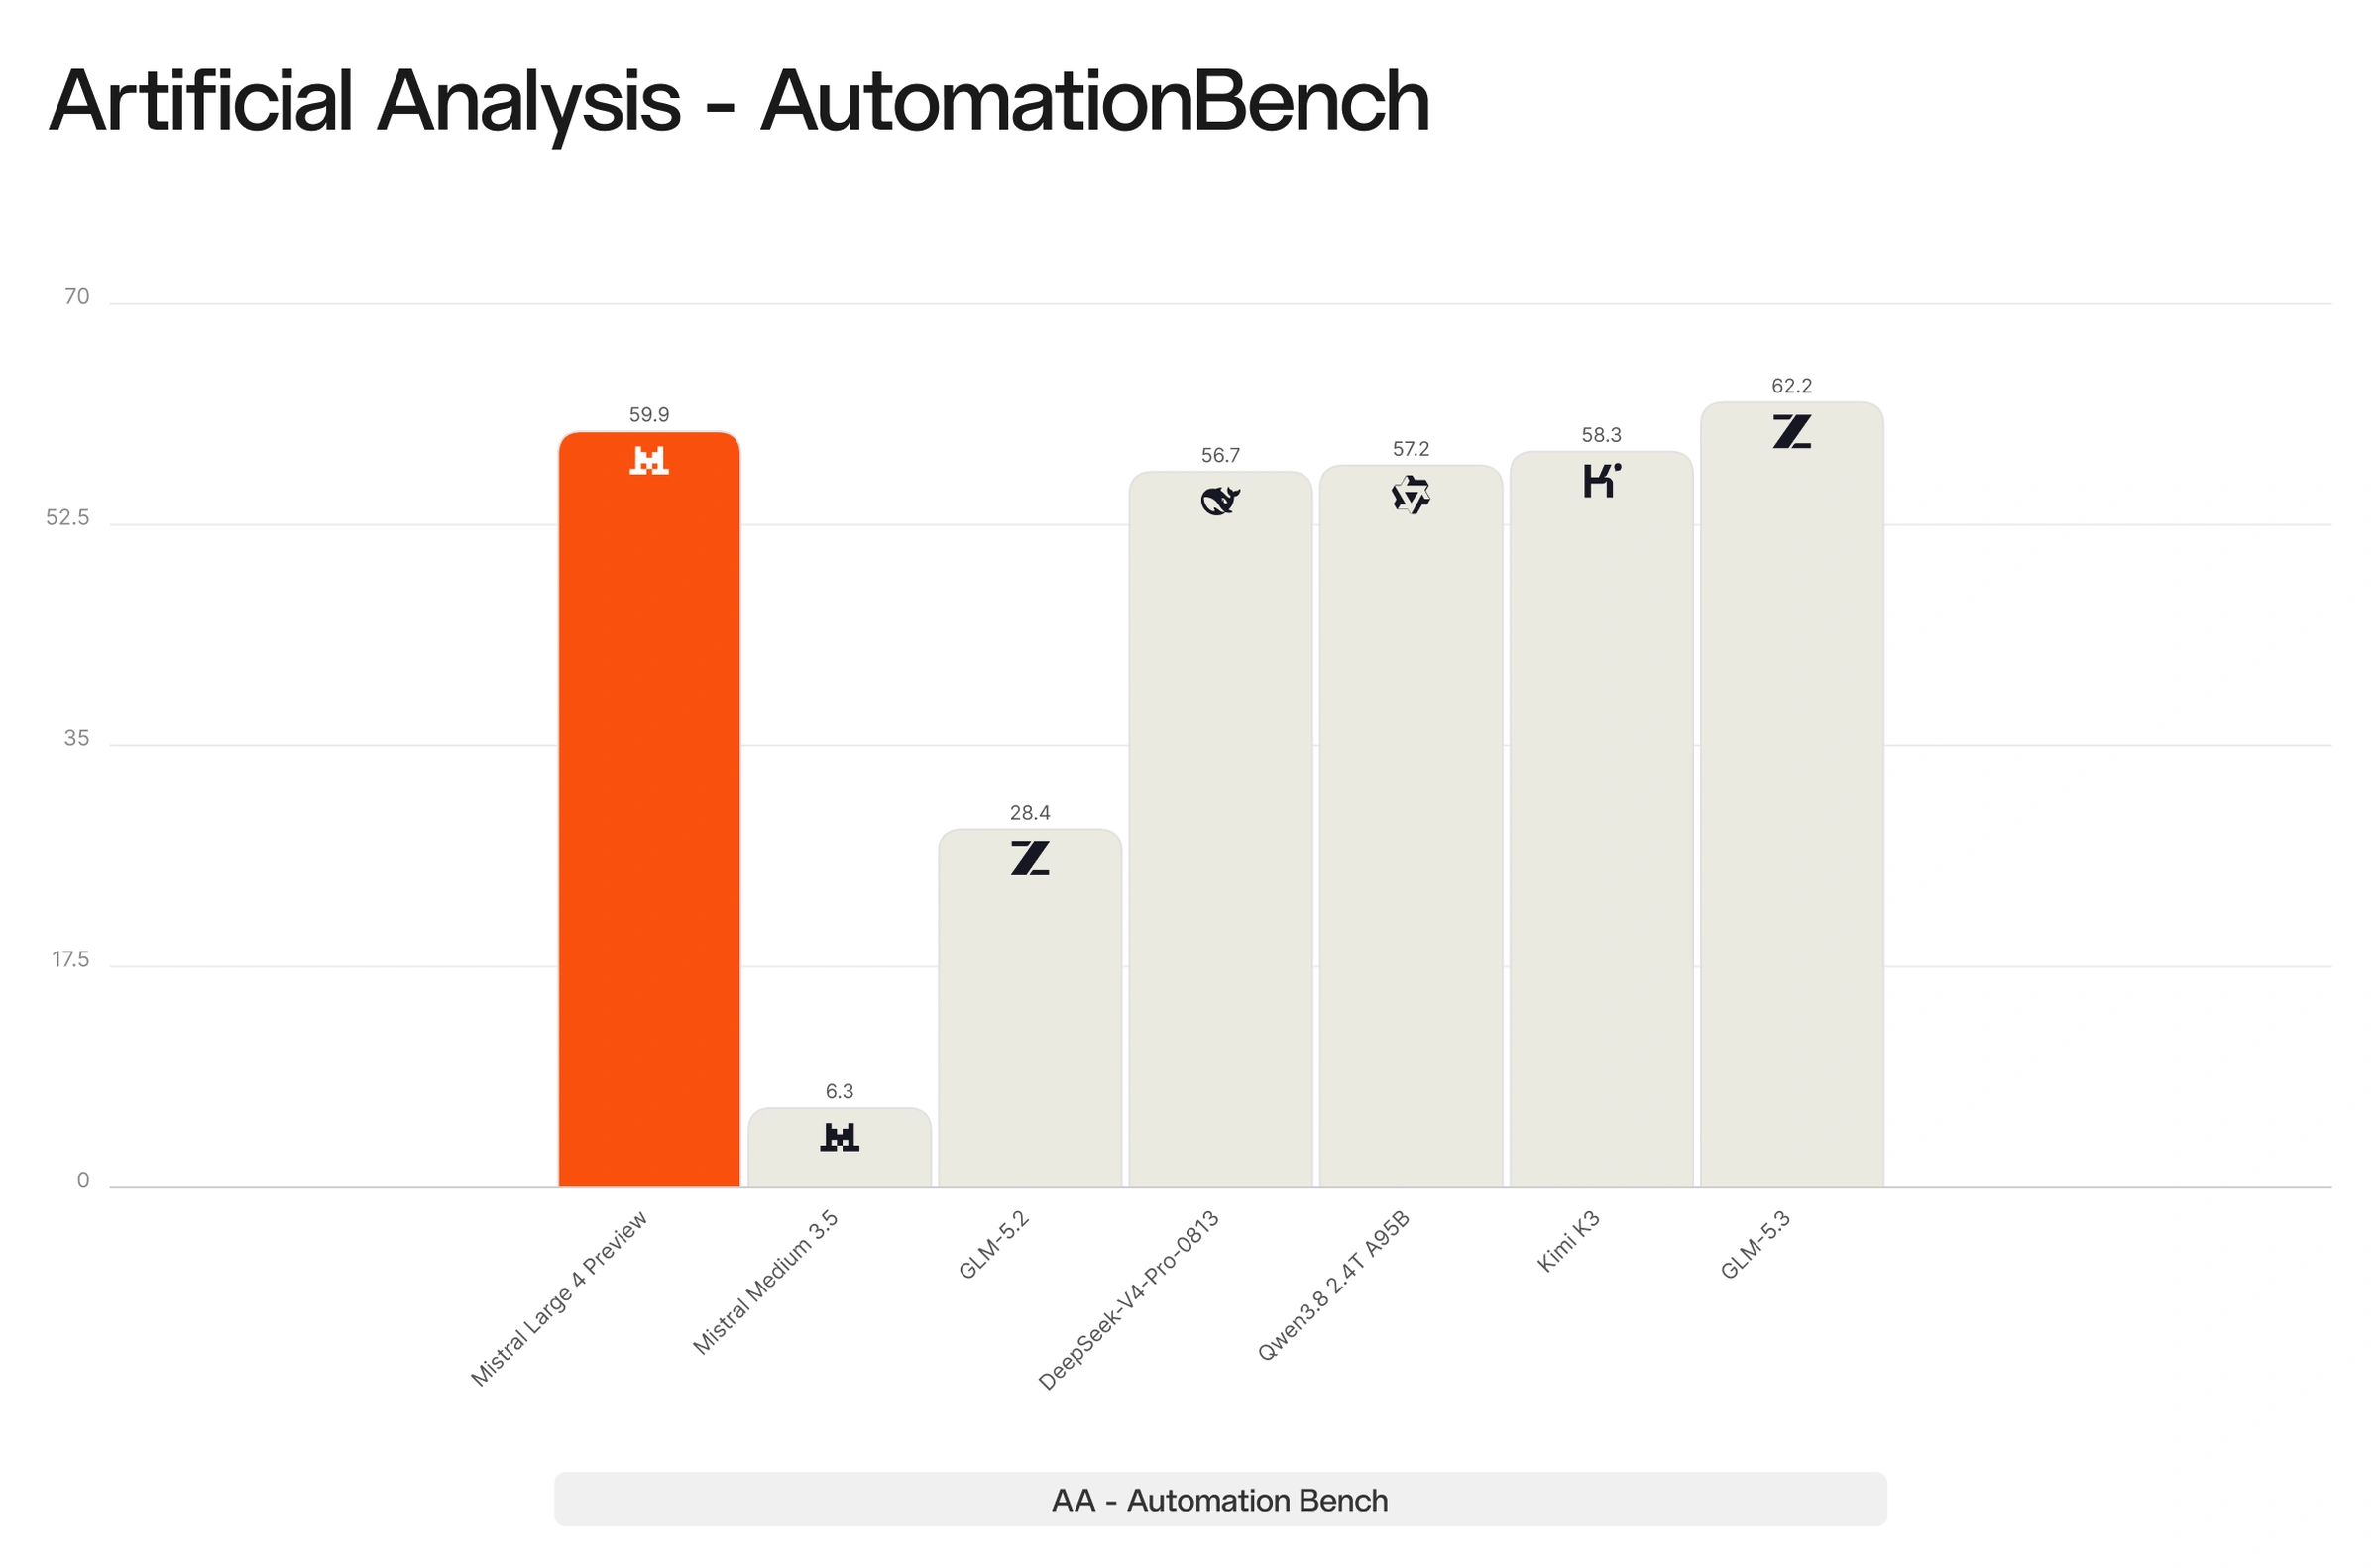
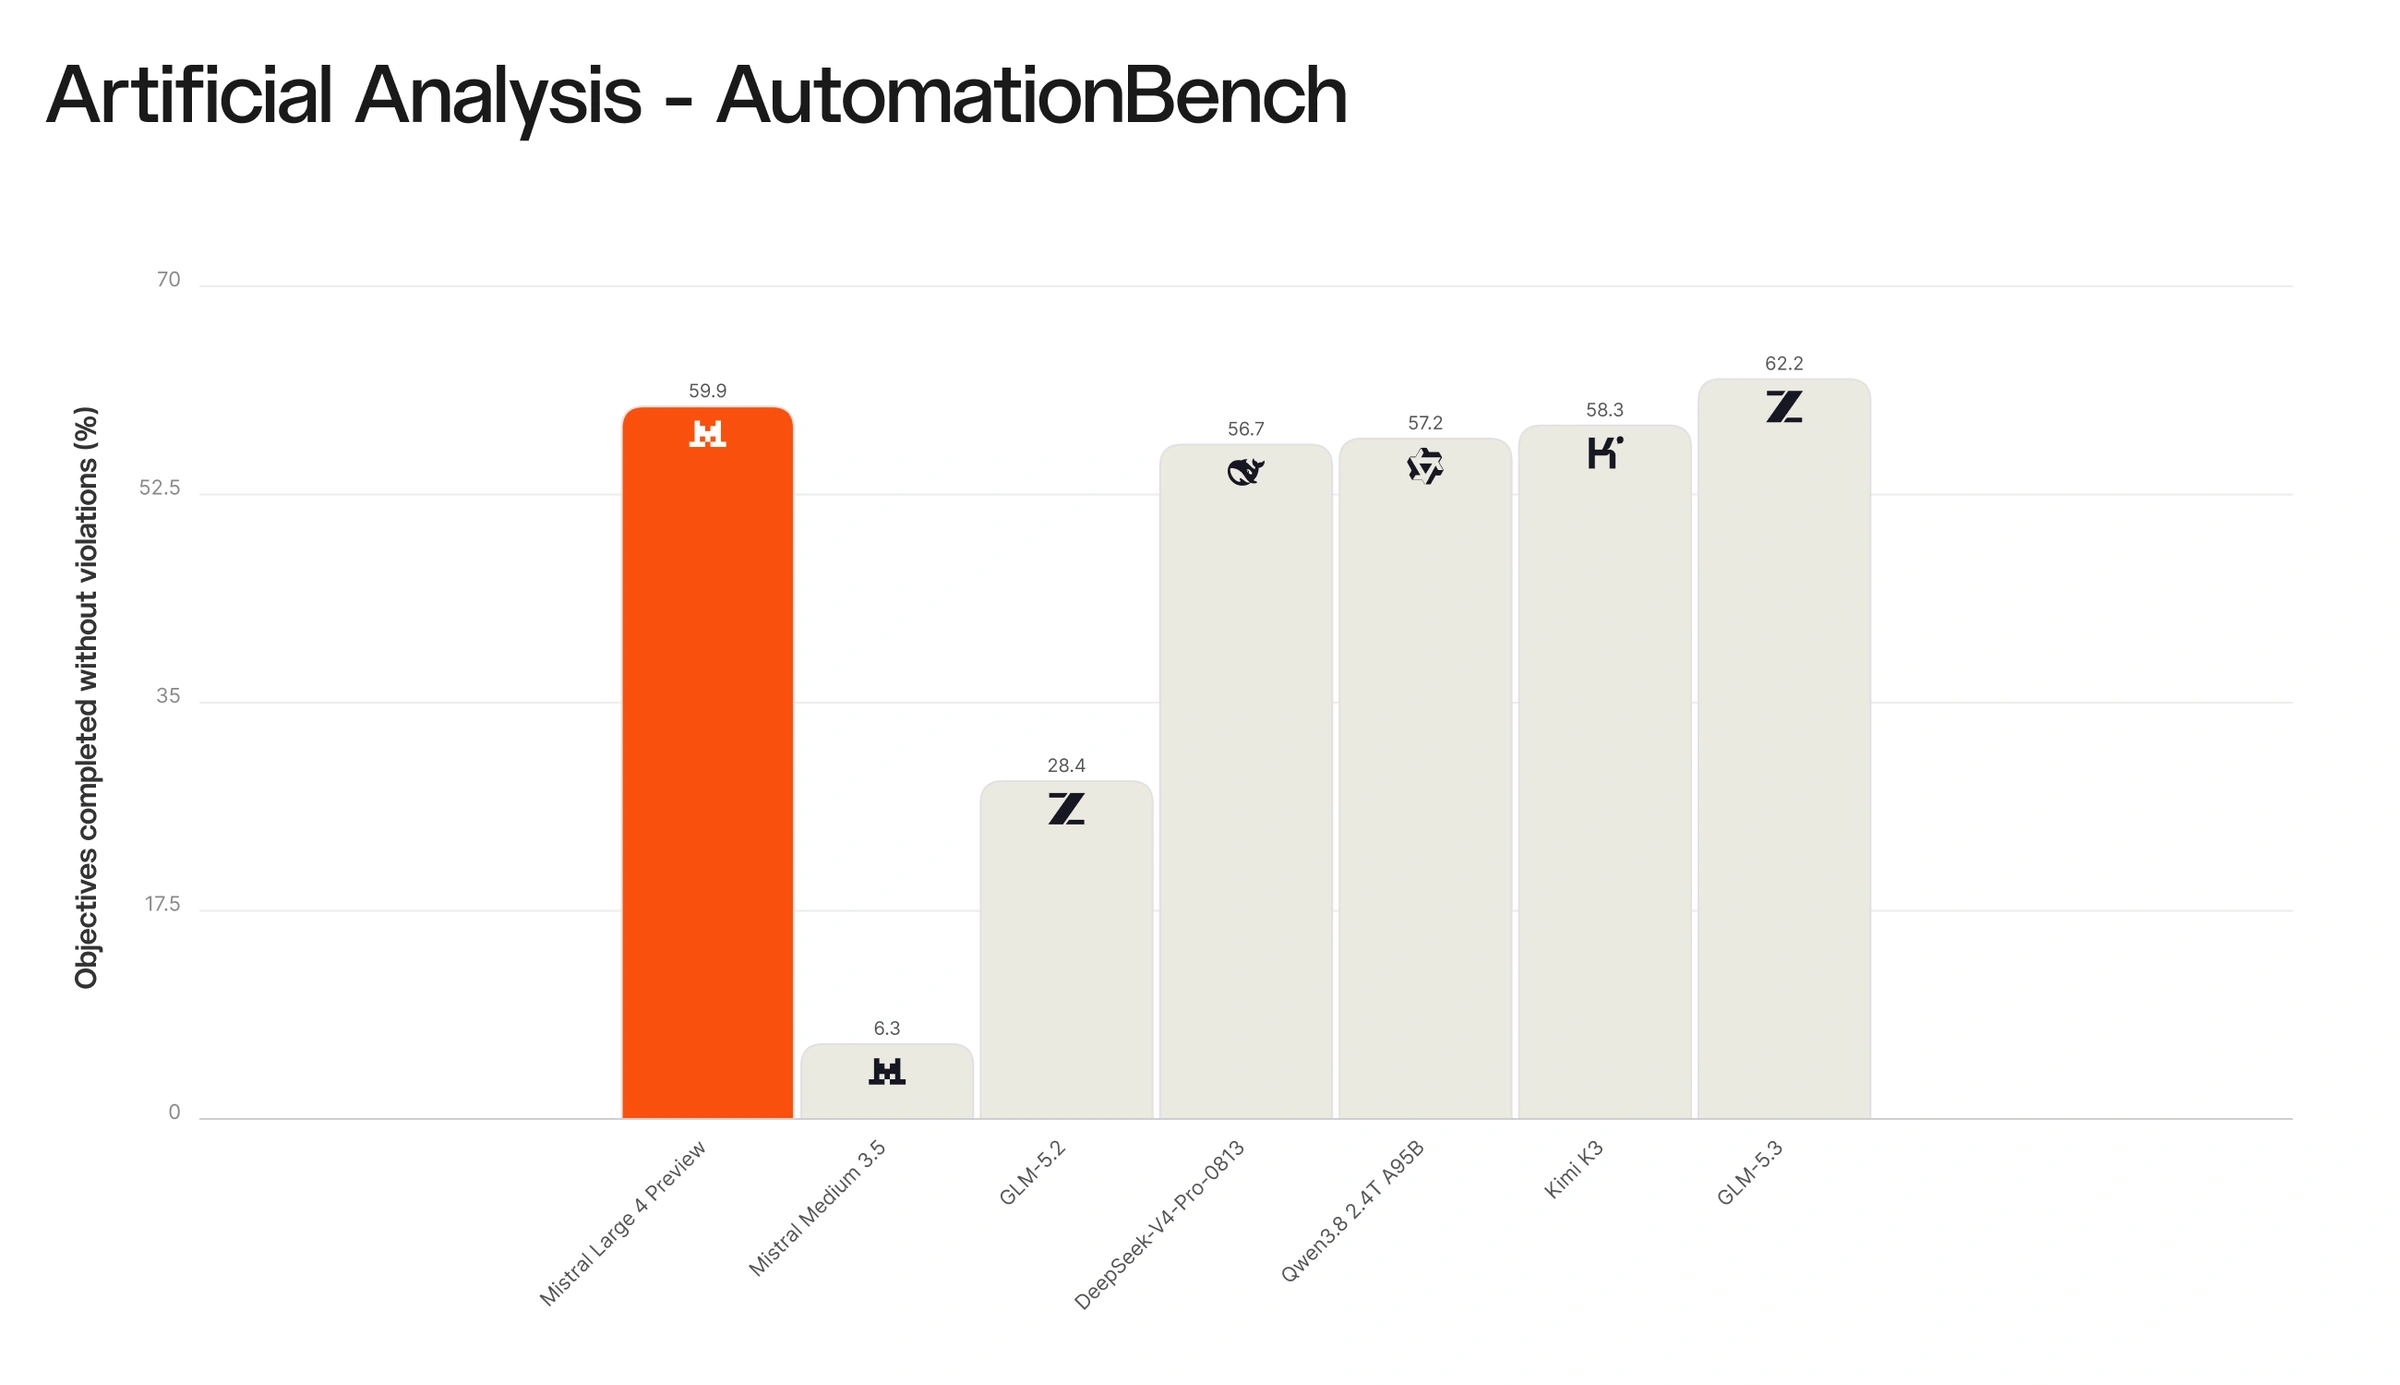
ML4 esegue agenti generalisti che raccolgono informazioni, utilizzano strumenti e producono risultati pronti all'uso nell'ambito di flussi di lavoro complessi. Su AutomationBench, che comprende 657 flussi di lavoro aziendali su app come Gmail, Google Sheets, Slack e Salesforce, ottiene il 59,9%, davanti a Kimi K3, MiMo-V2.6-Pro e DeepSeek V4 Pro.
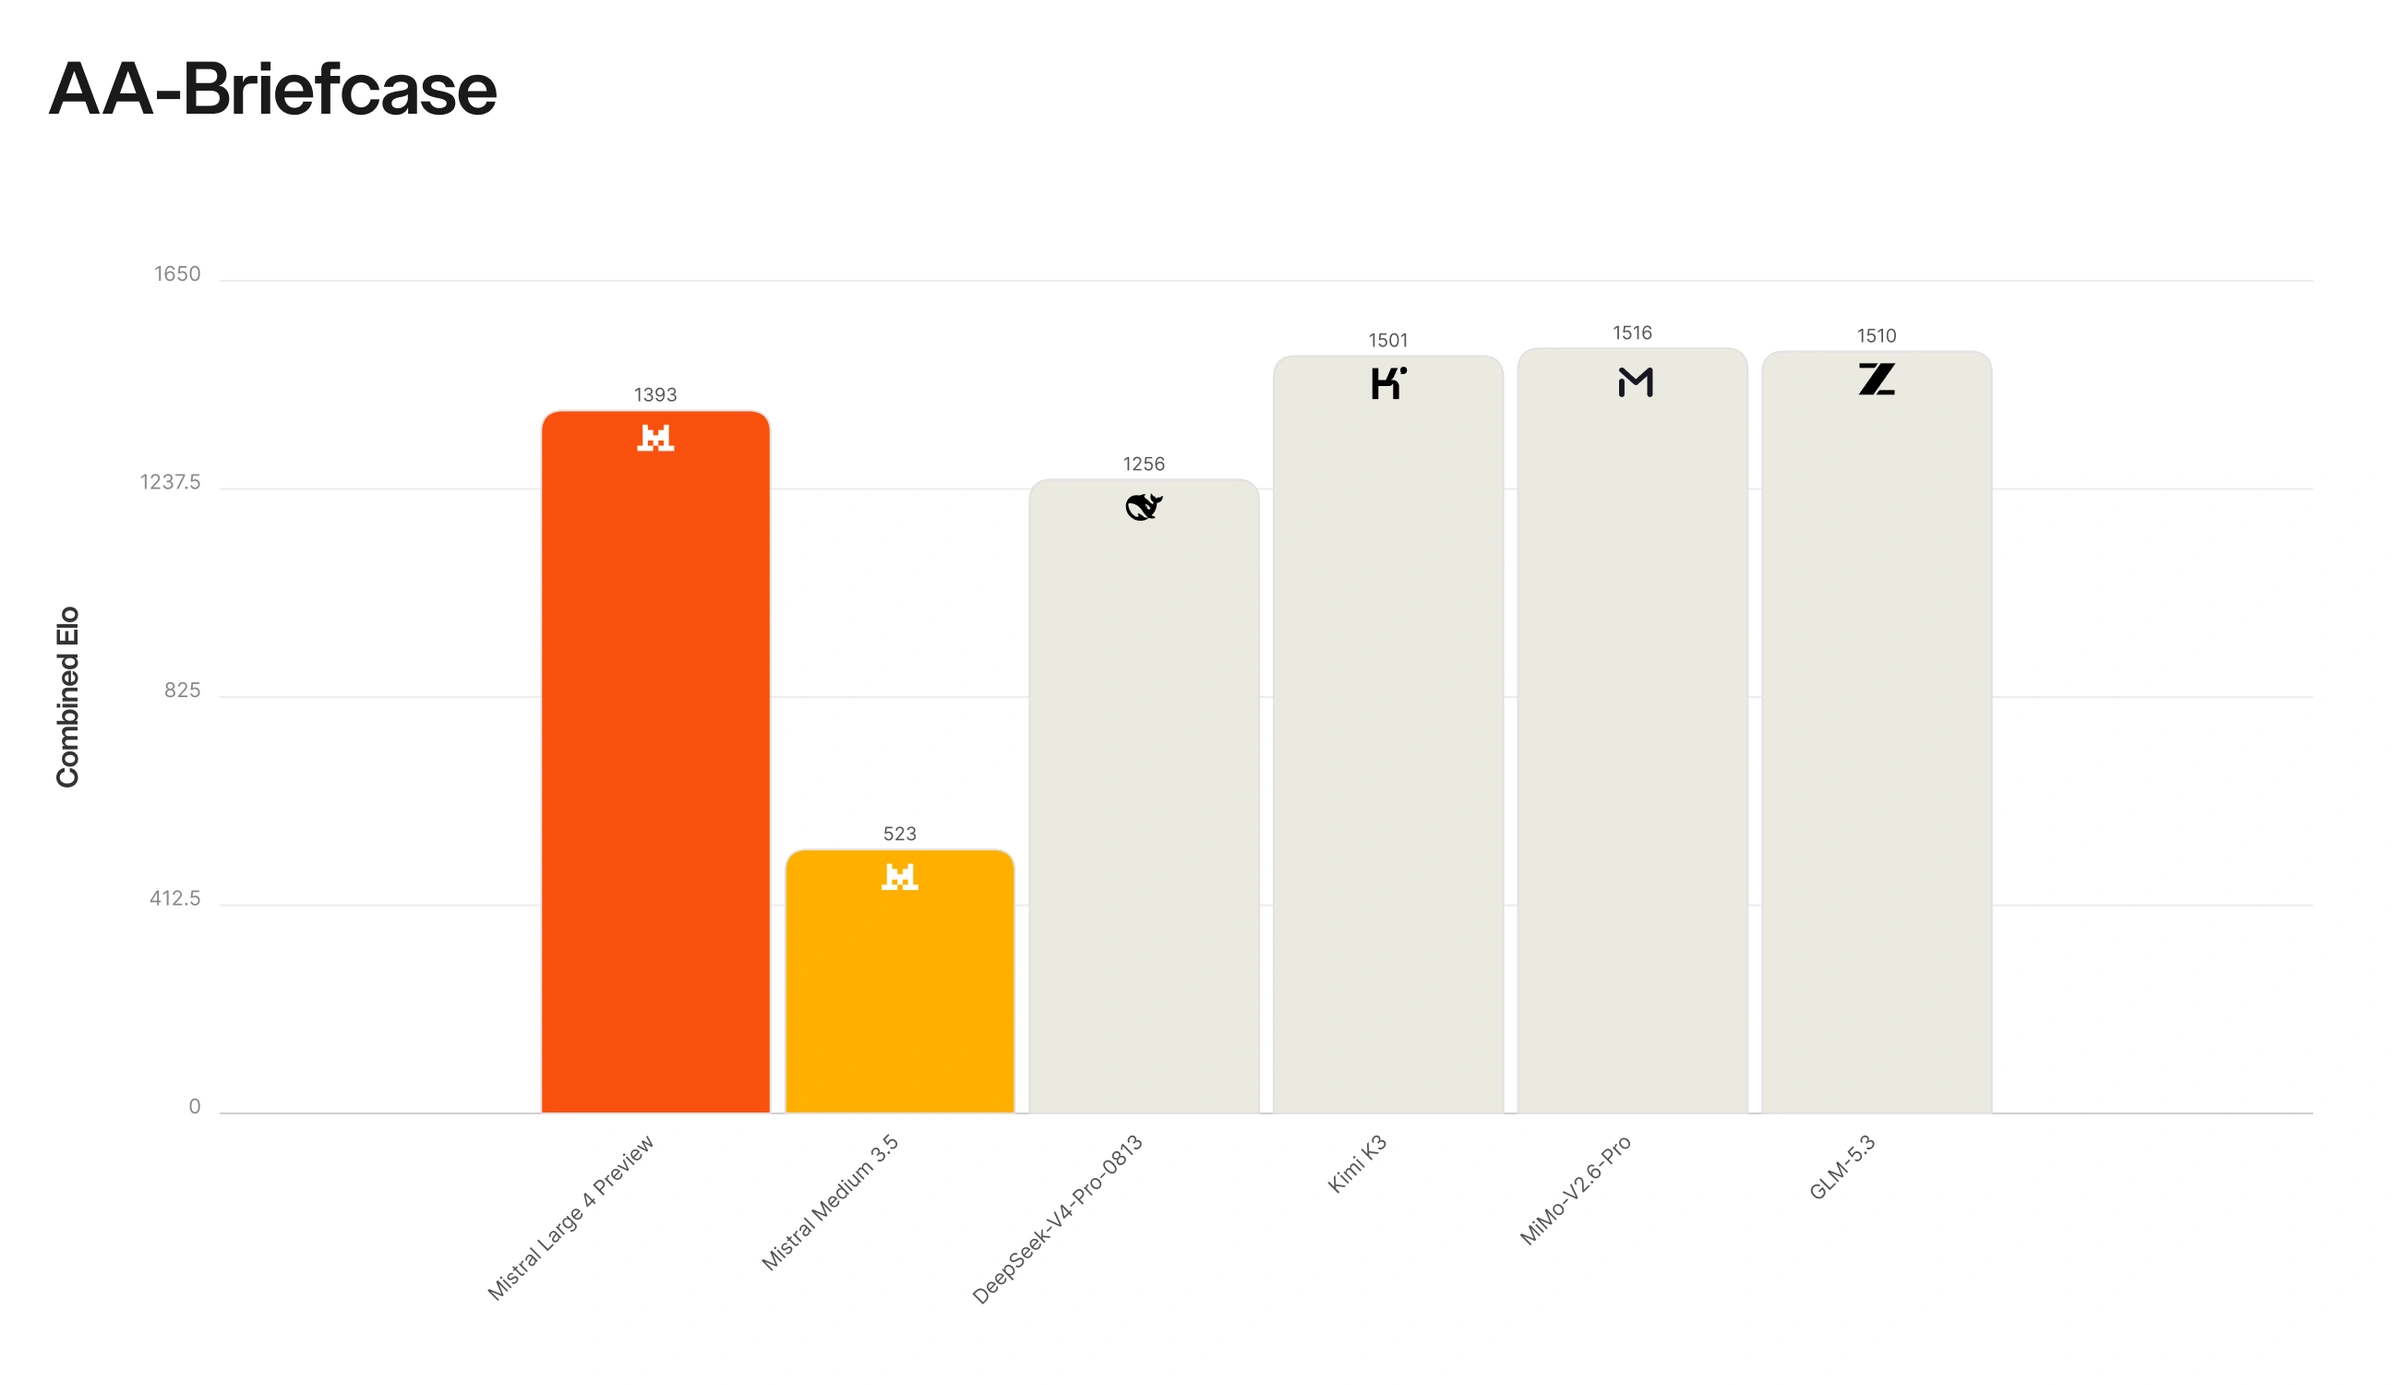
È altrettanto efficace nel produrre i materiali professionali tipici del lavoro intellettuale: fogli di calcolo, presentazioni e PDF. Su AA-Briefcase, che valuta attività di lavoro intellettuale su orizzonti temporali lunghi, raggiunge un punteggio Elo di 1.393, davanti a DeepSeek V4 Pro.
Multimodale
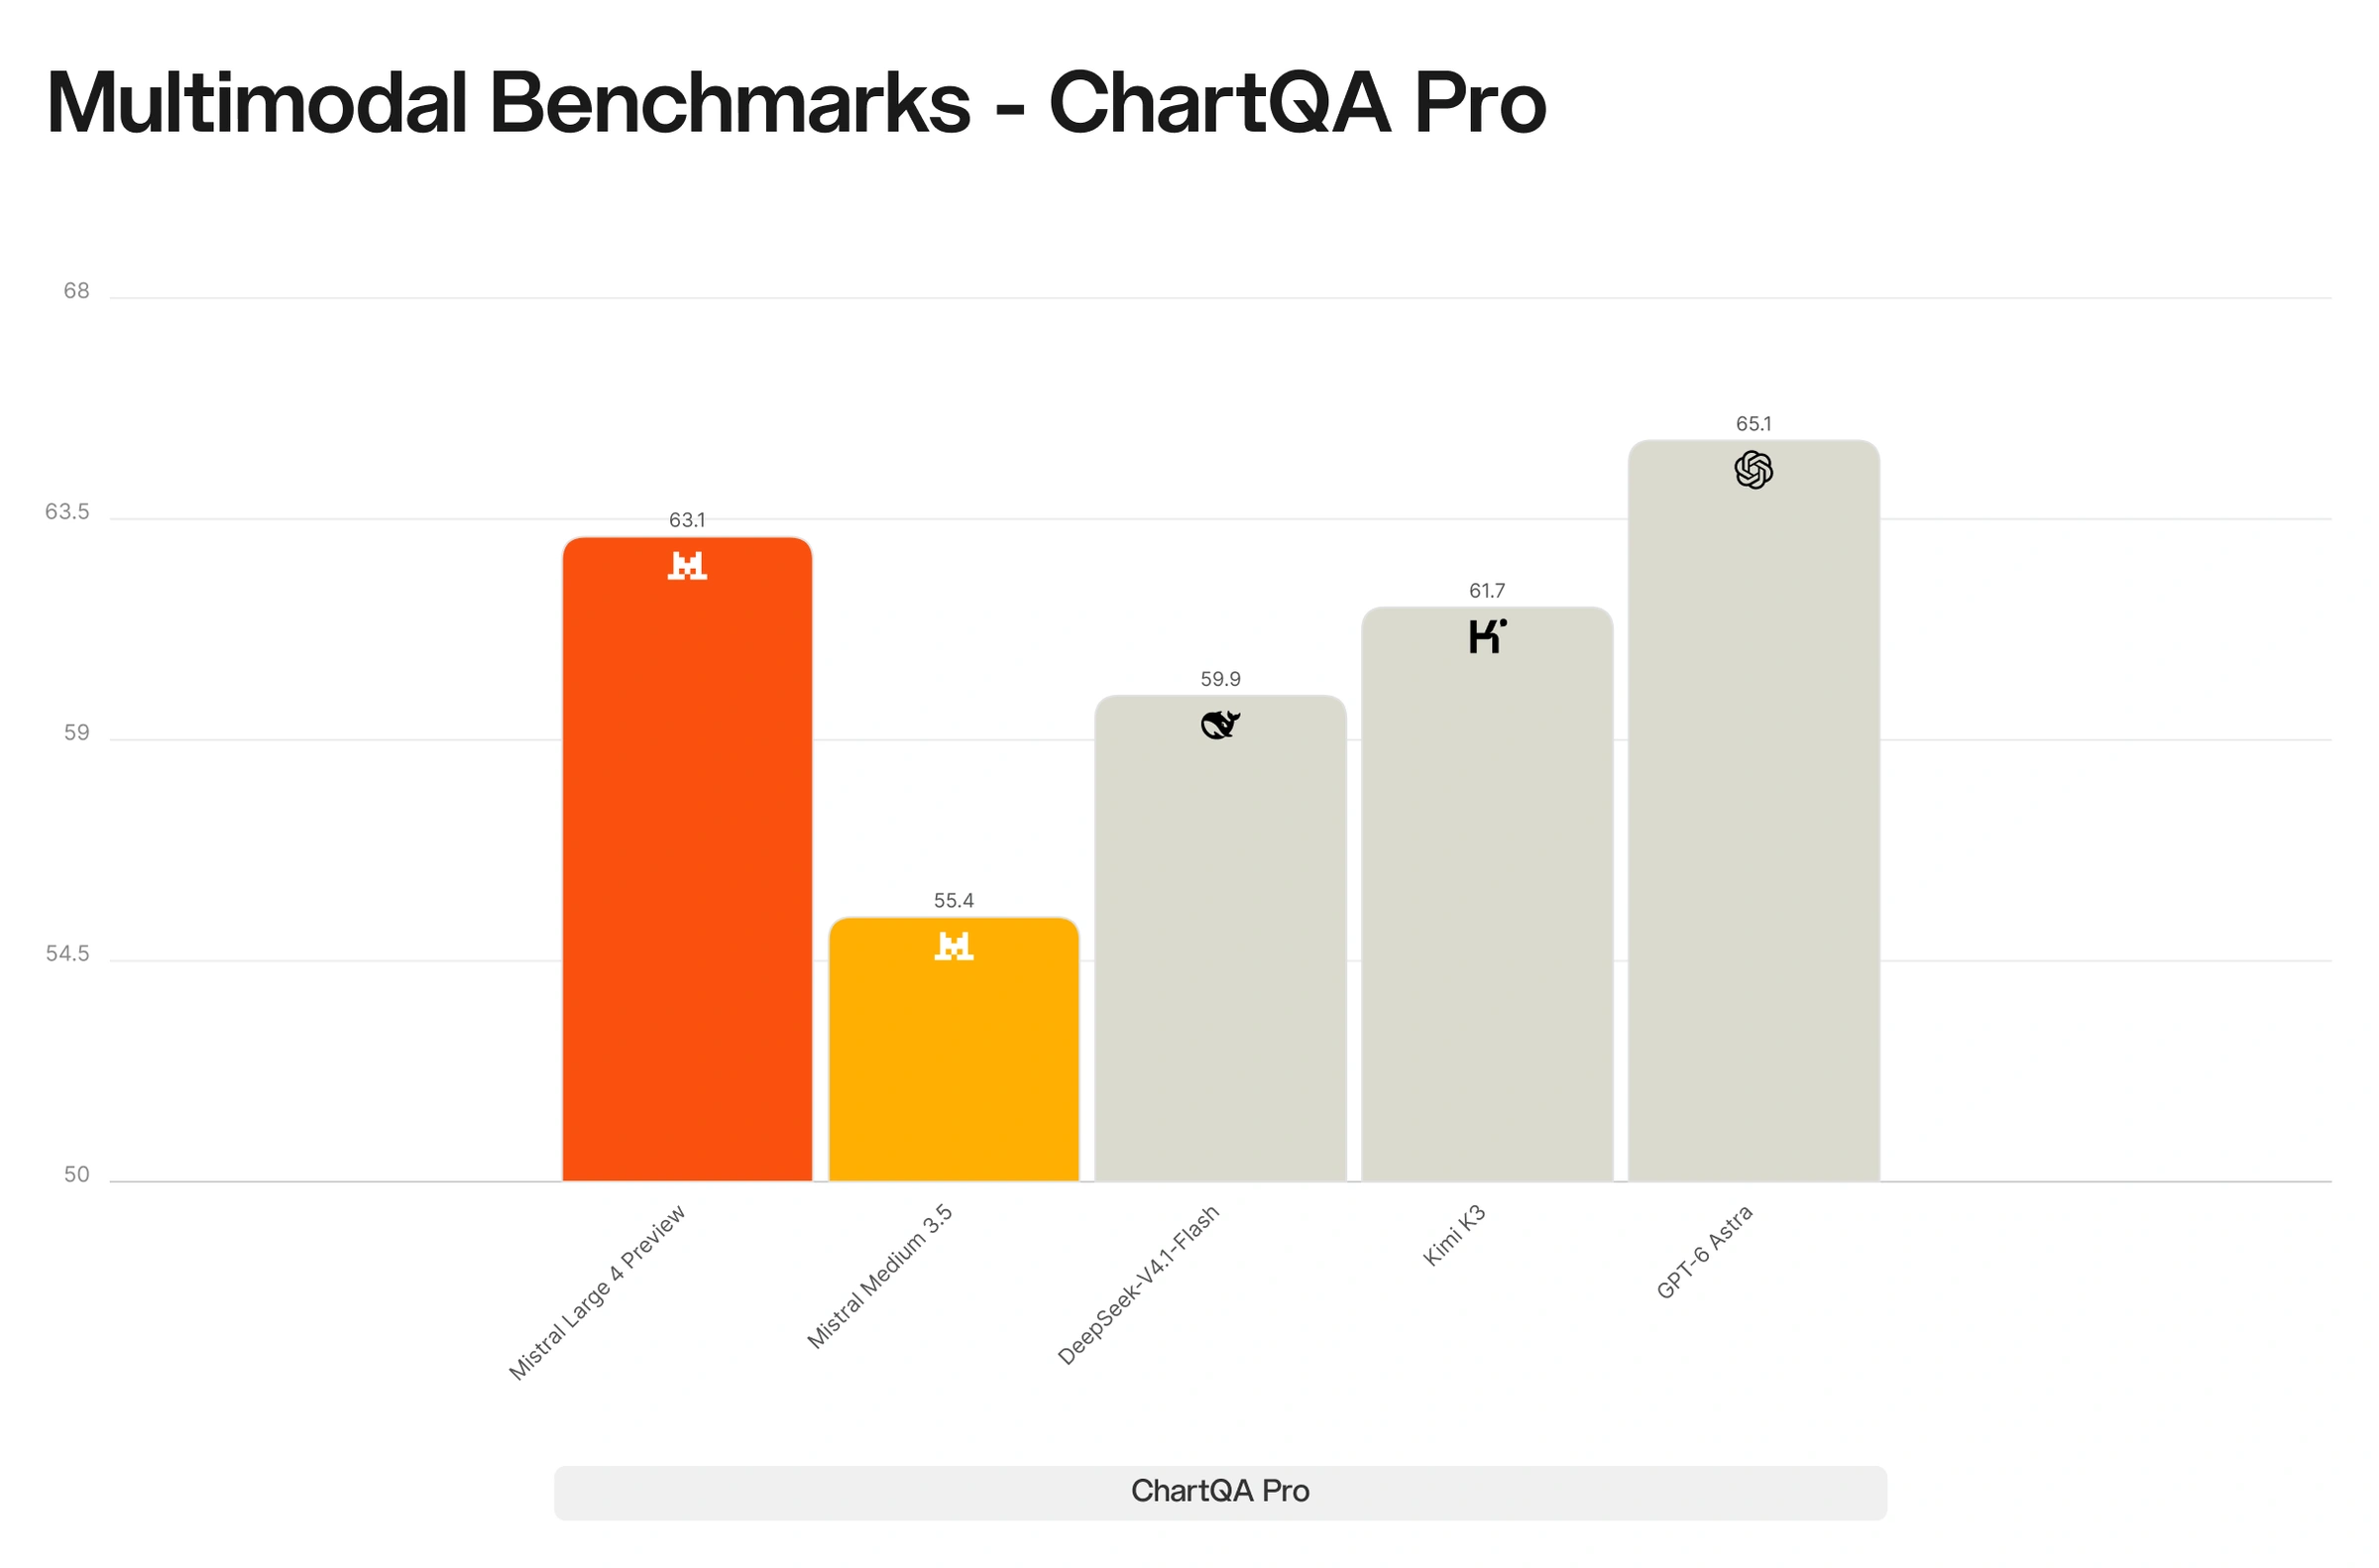
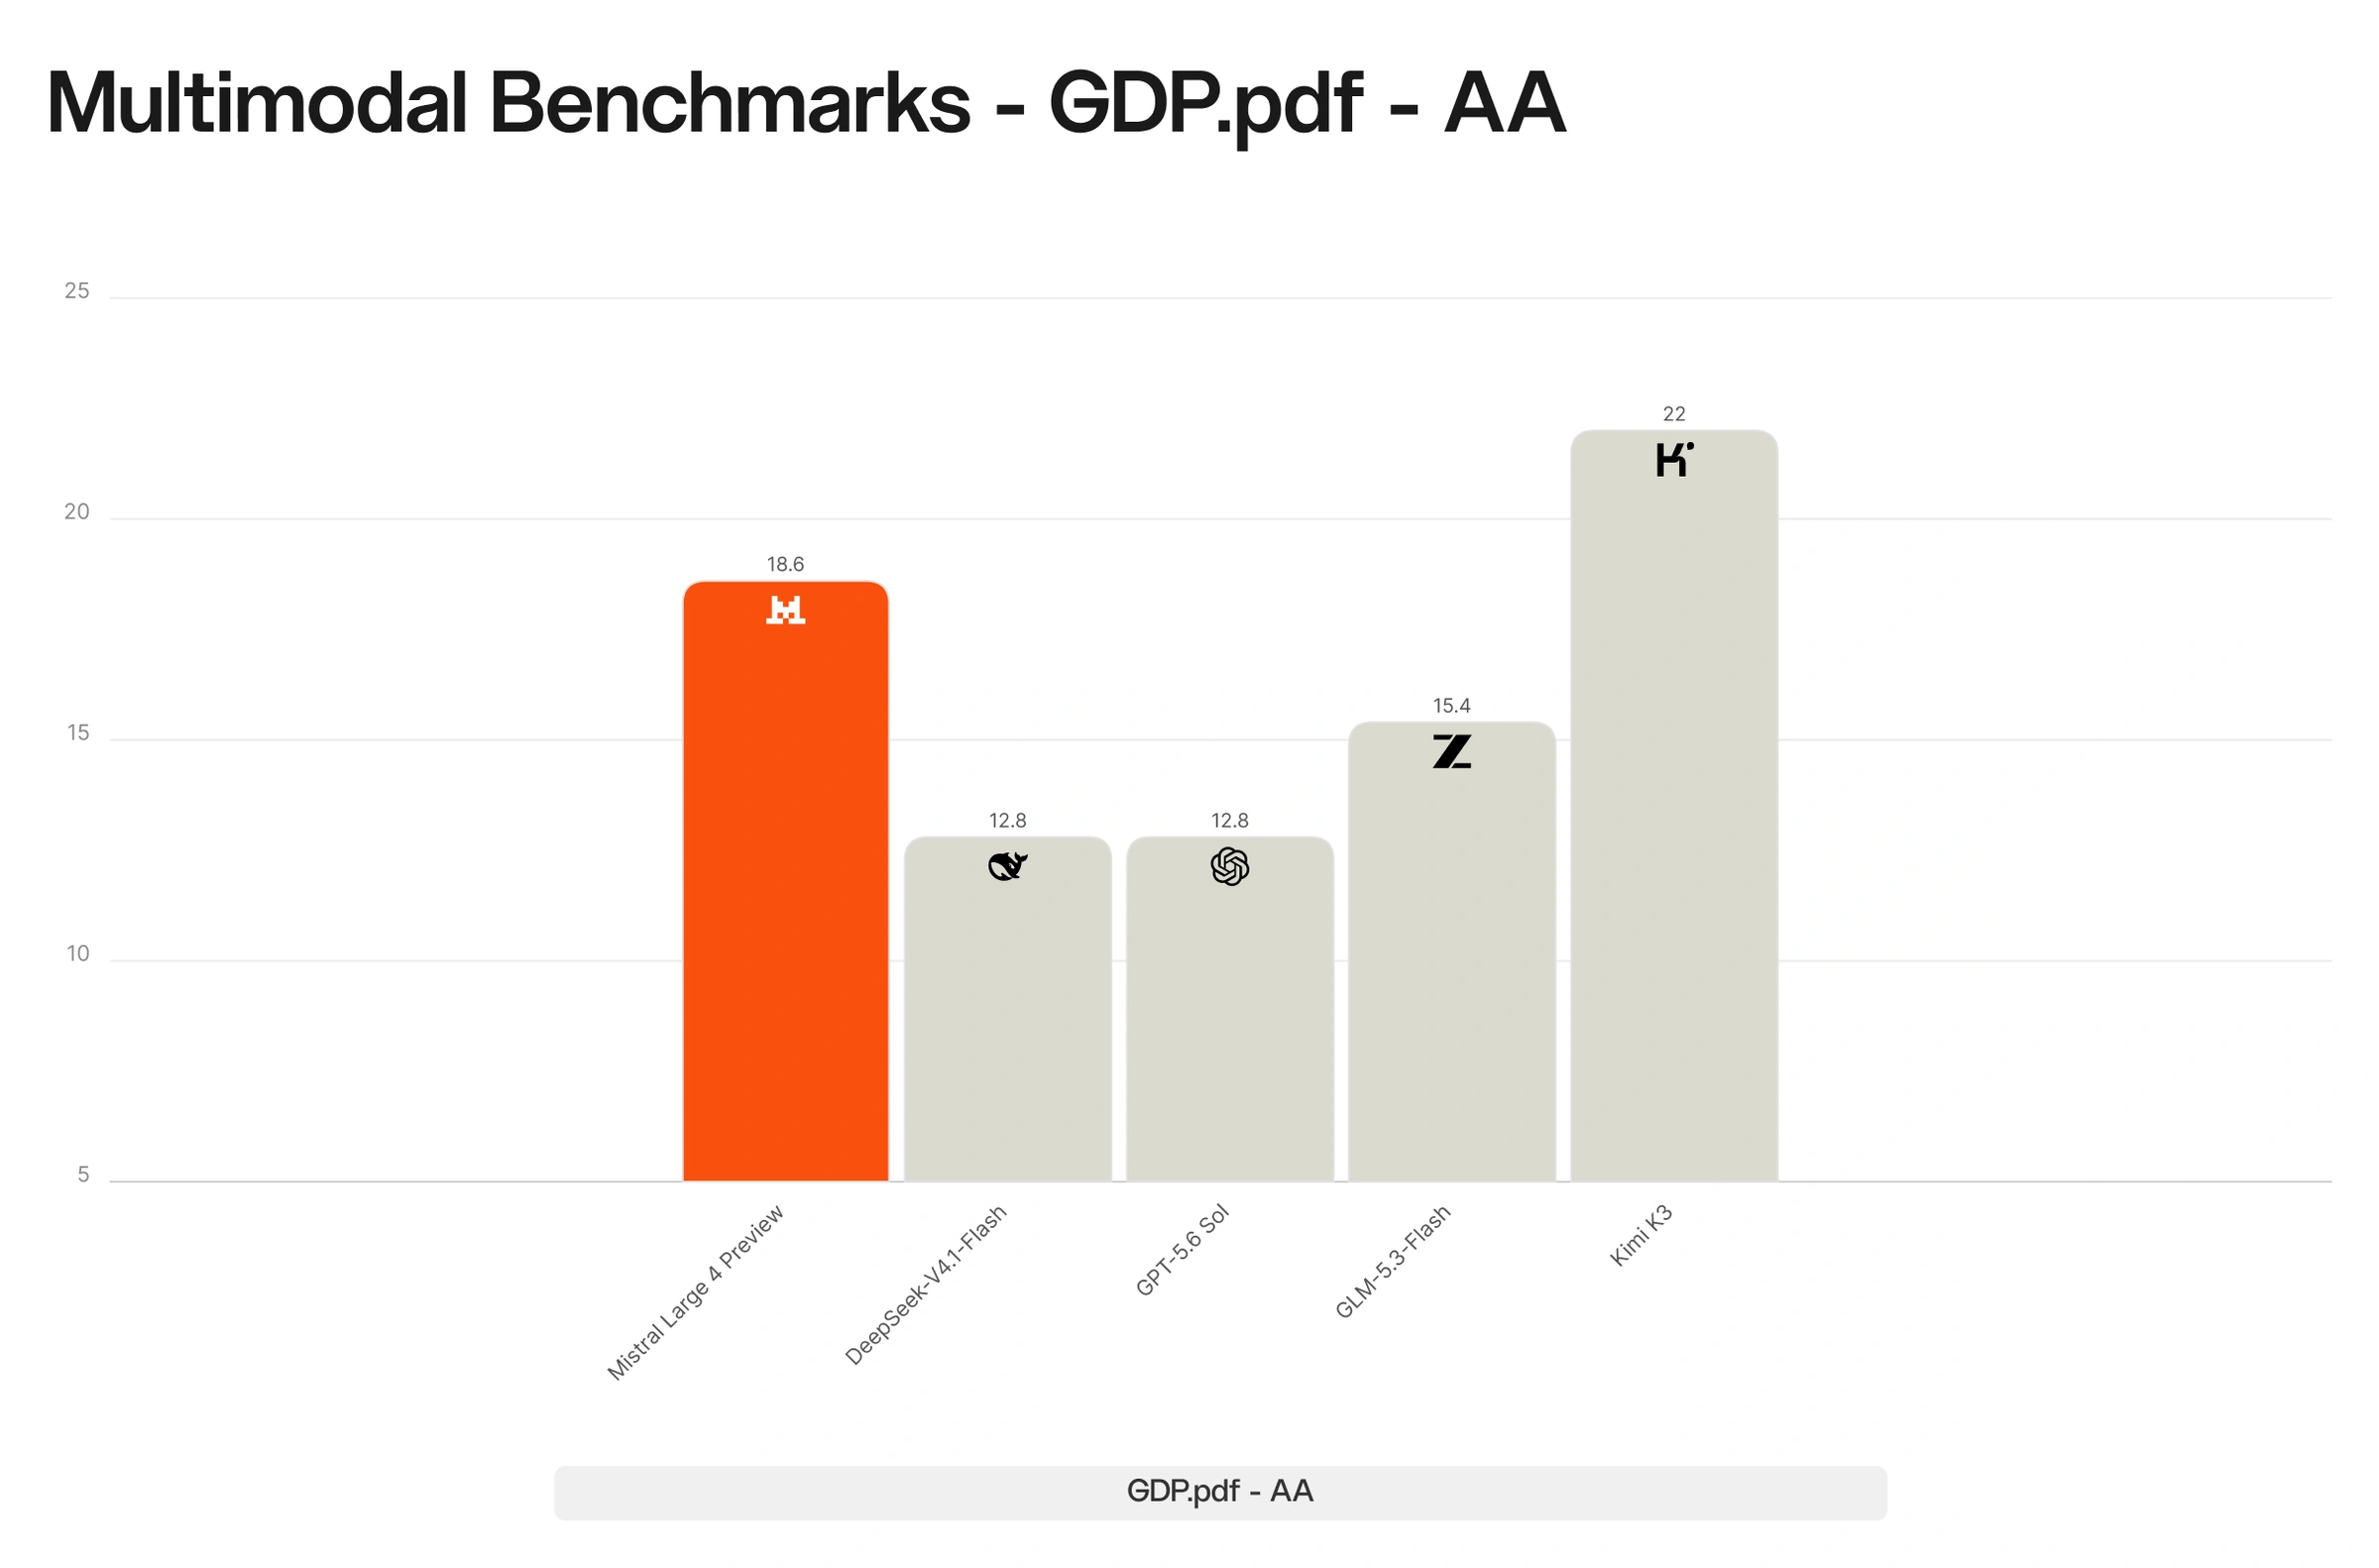
ML4 segna un salto di qualità nella capacità dei nostri modelli di comprendere le immagini. Offre un ragionamento avanzato su documenti complessi, grafici e immagini del mondo reale, e porta la visione nei settori in cui la percezione è fondamentale, come la progettazione, la produzione e l'osservazione della Terra.
Il modello può inoltre combinare il grounding visivo con capacità agentiche: dall'analisi di immagini satellitari da gigapixel — aiutando i team di risposta alle catastrofi ad agire quando il tempo è decisivo — all'analisi di disegni tecnici, ingrandendo, esaminando e verificando fino a ottenere una risposta esatta. Nelle demo riportate sopra, ML4 localizza elementi in scene naturali dense, verifica componenti meccanici nei disegni tecnici, recupera evidenze dai PDF e analizza enormi immagini geospaziali per individuare gli oggetti più difficili da trovare.
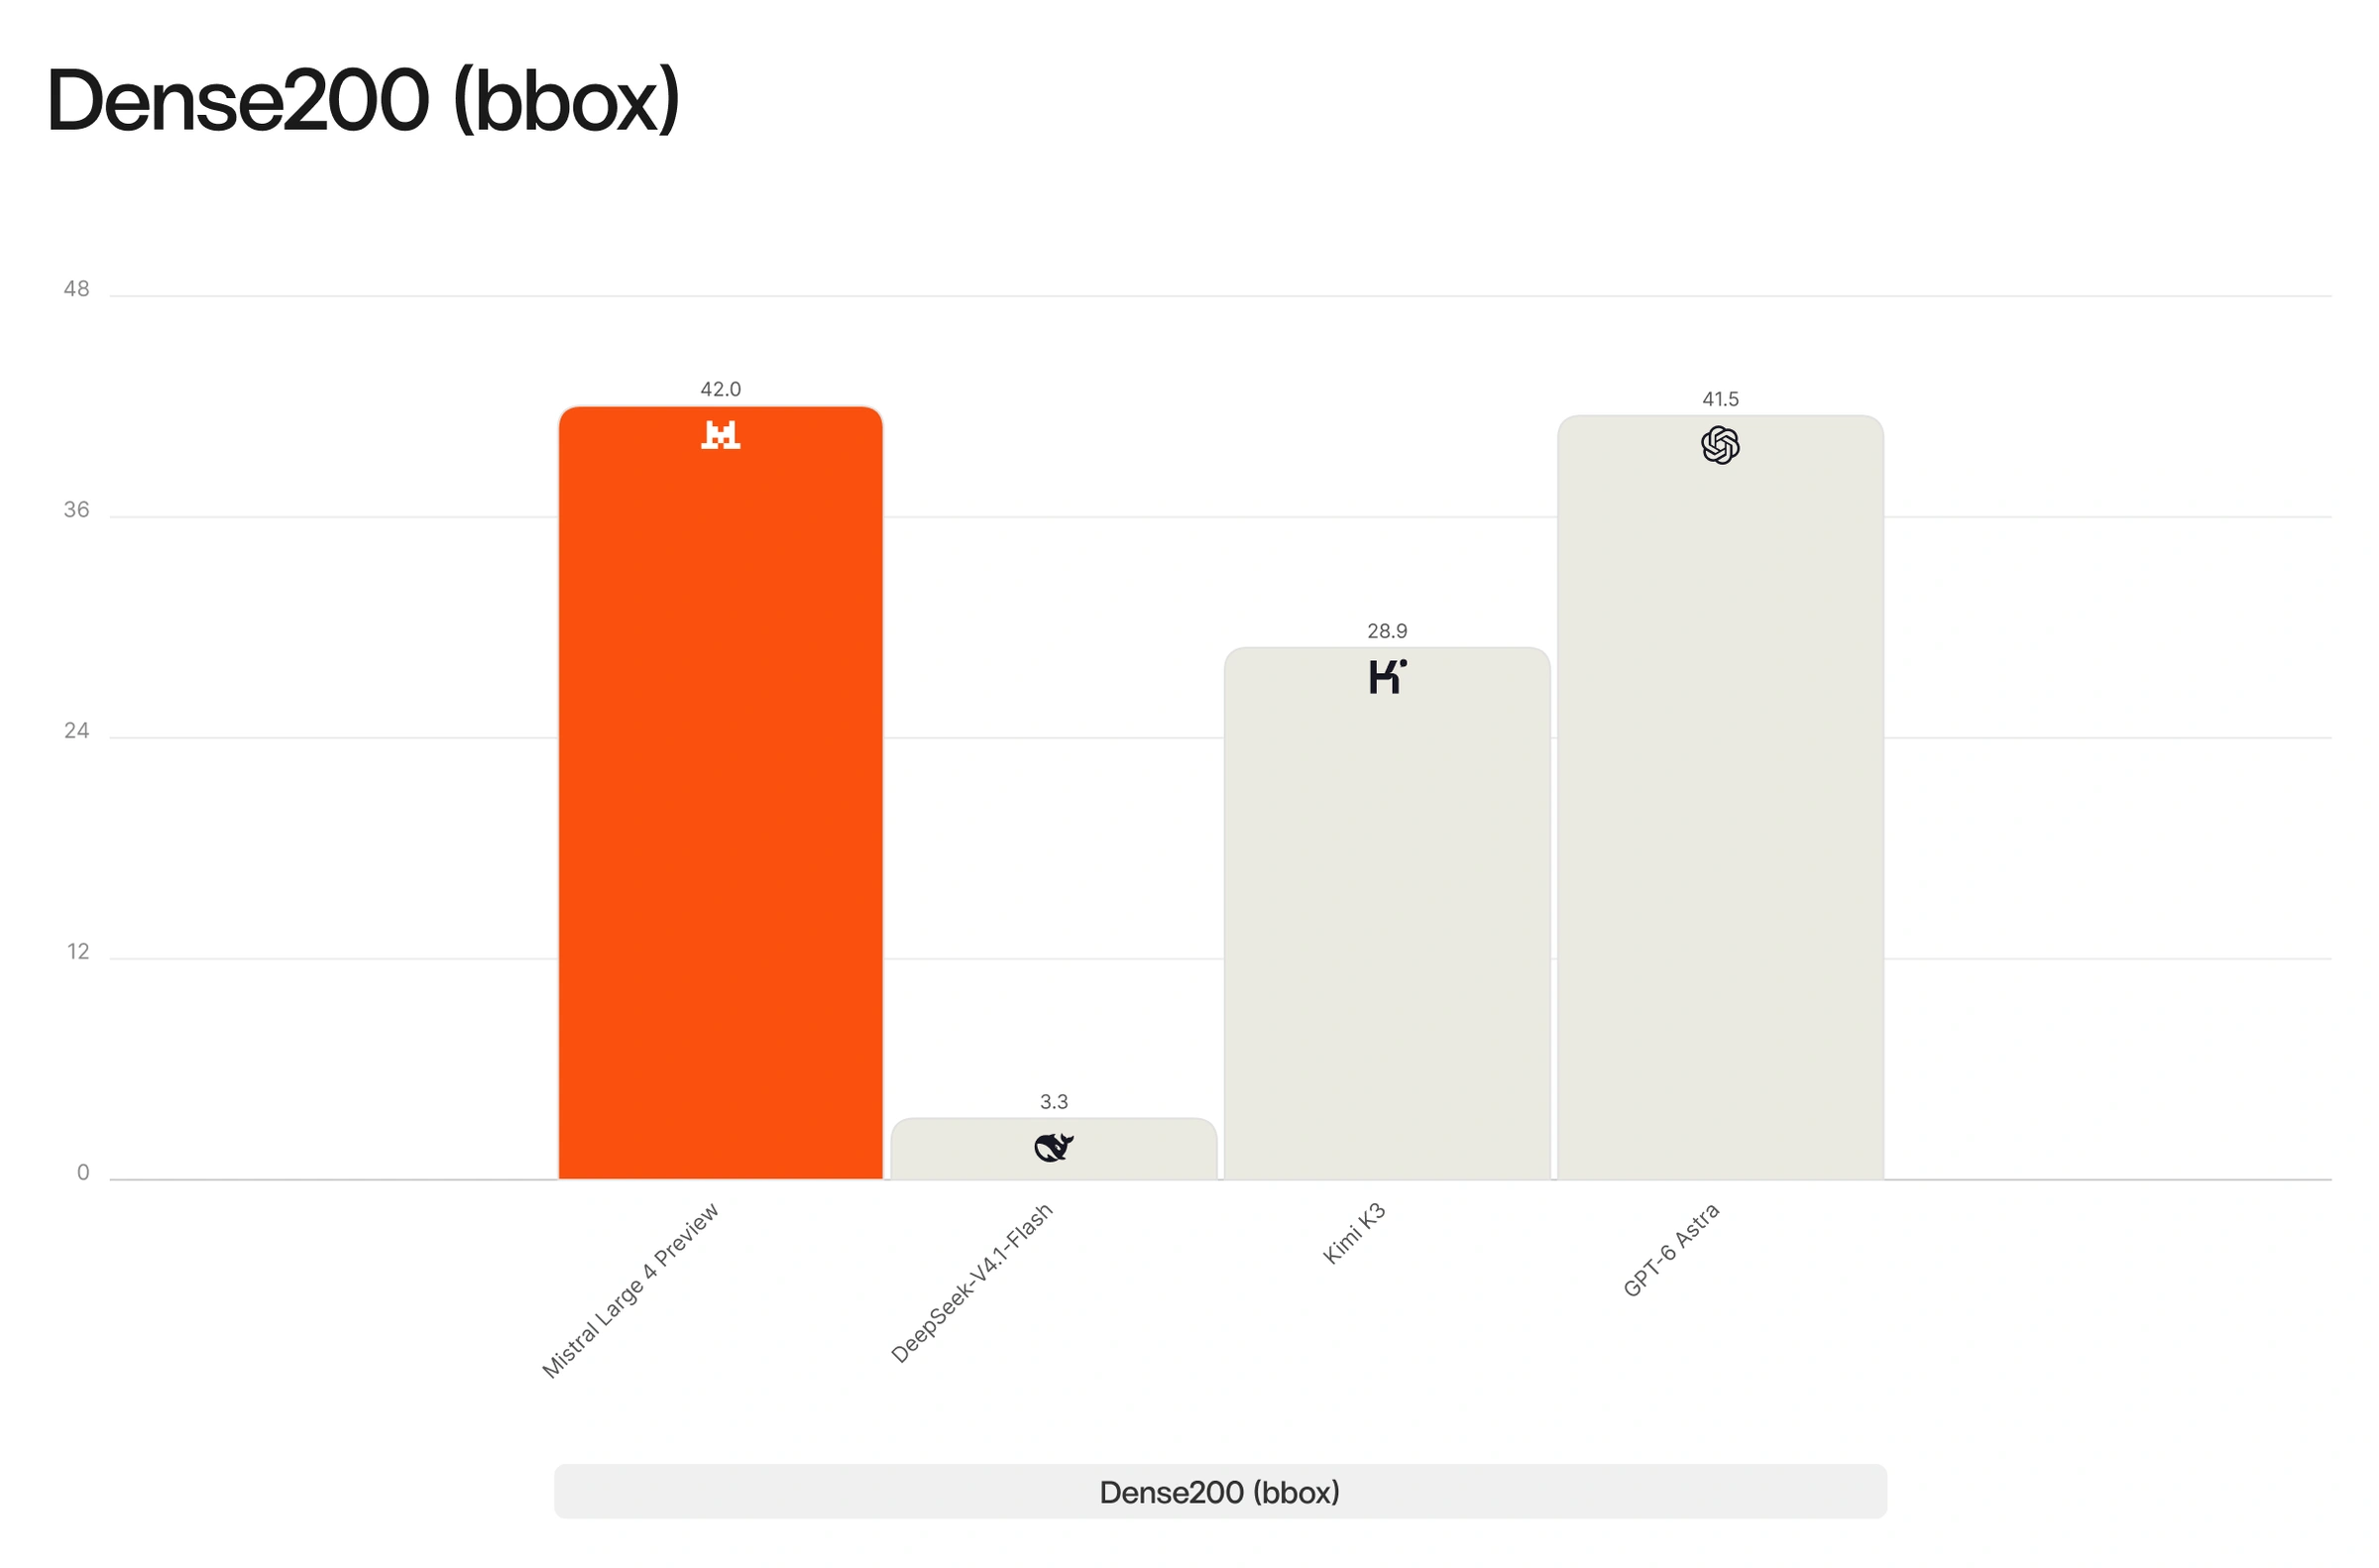
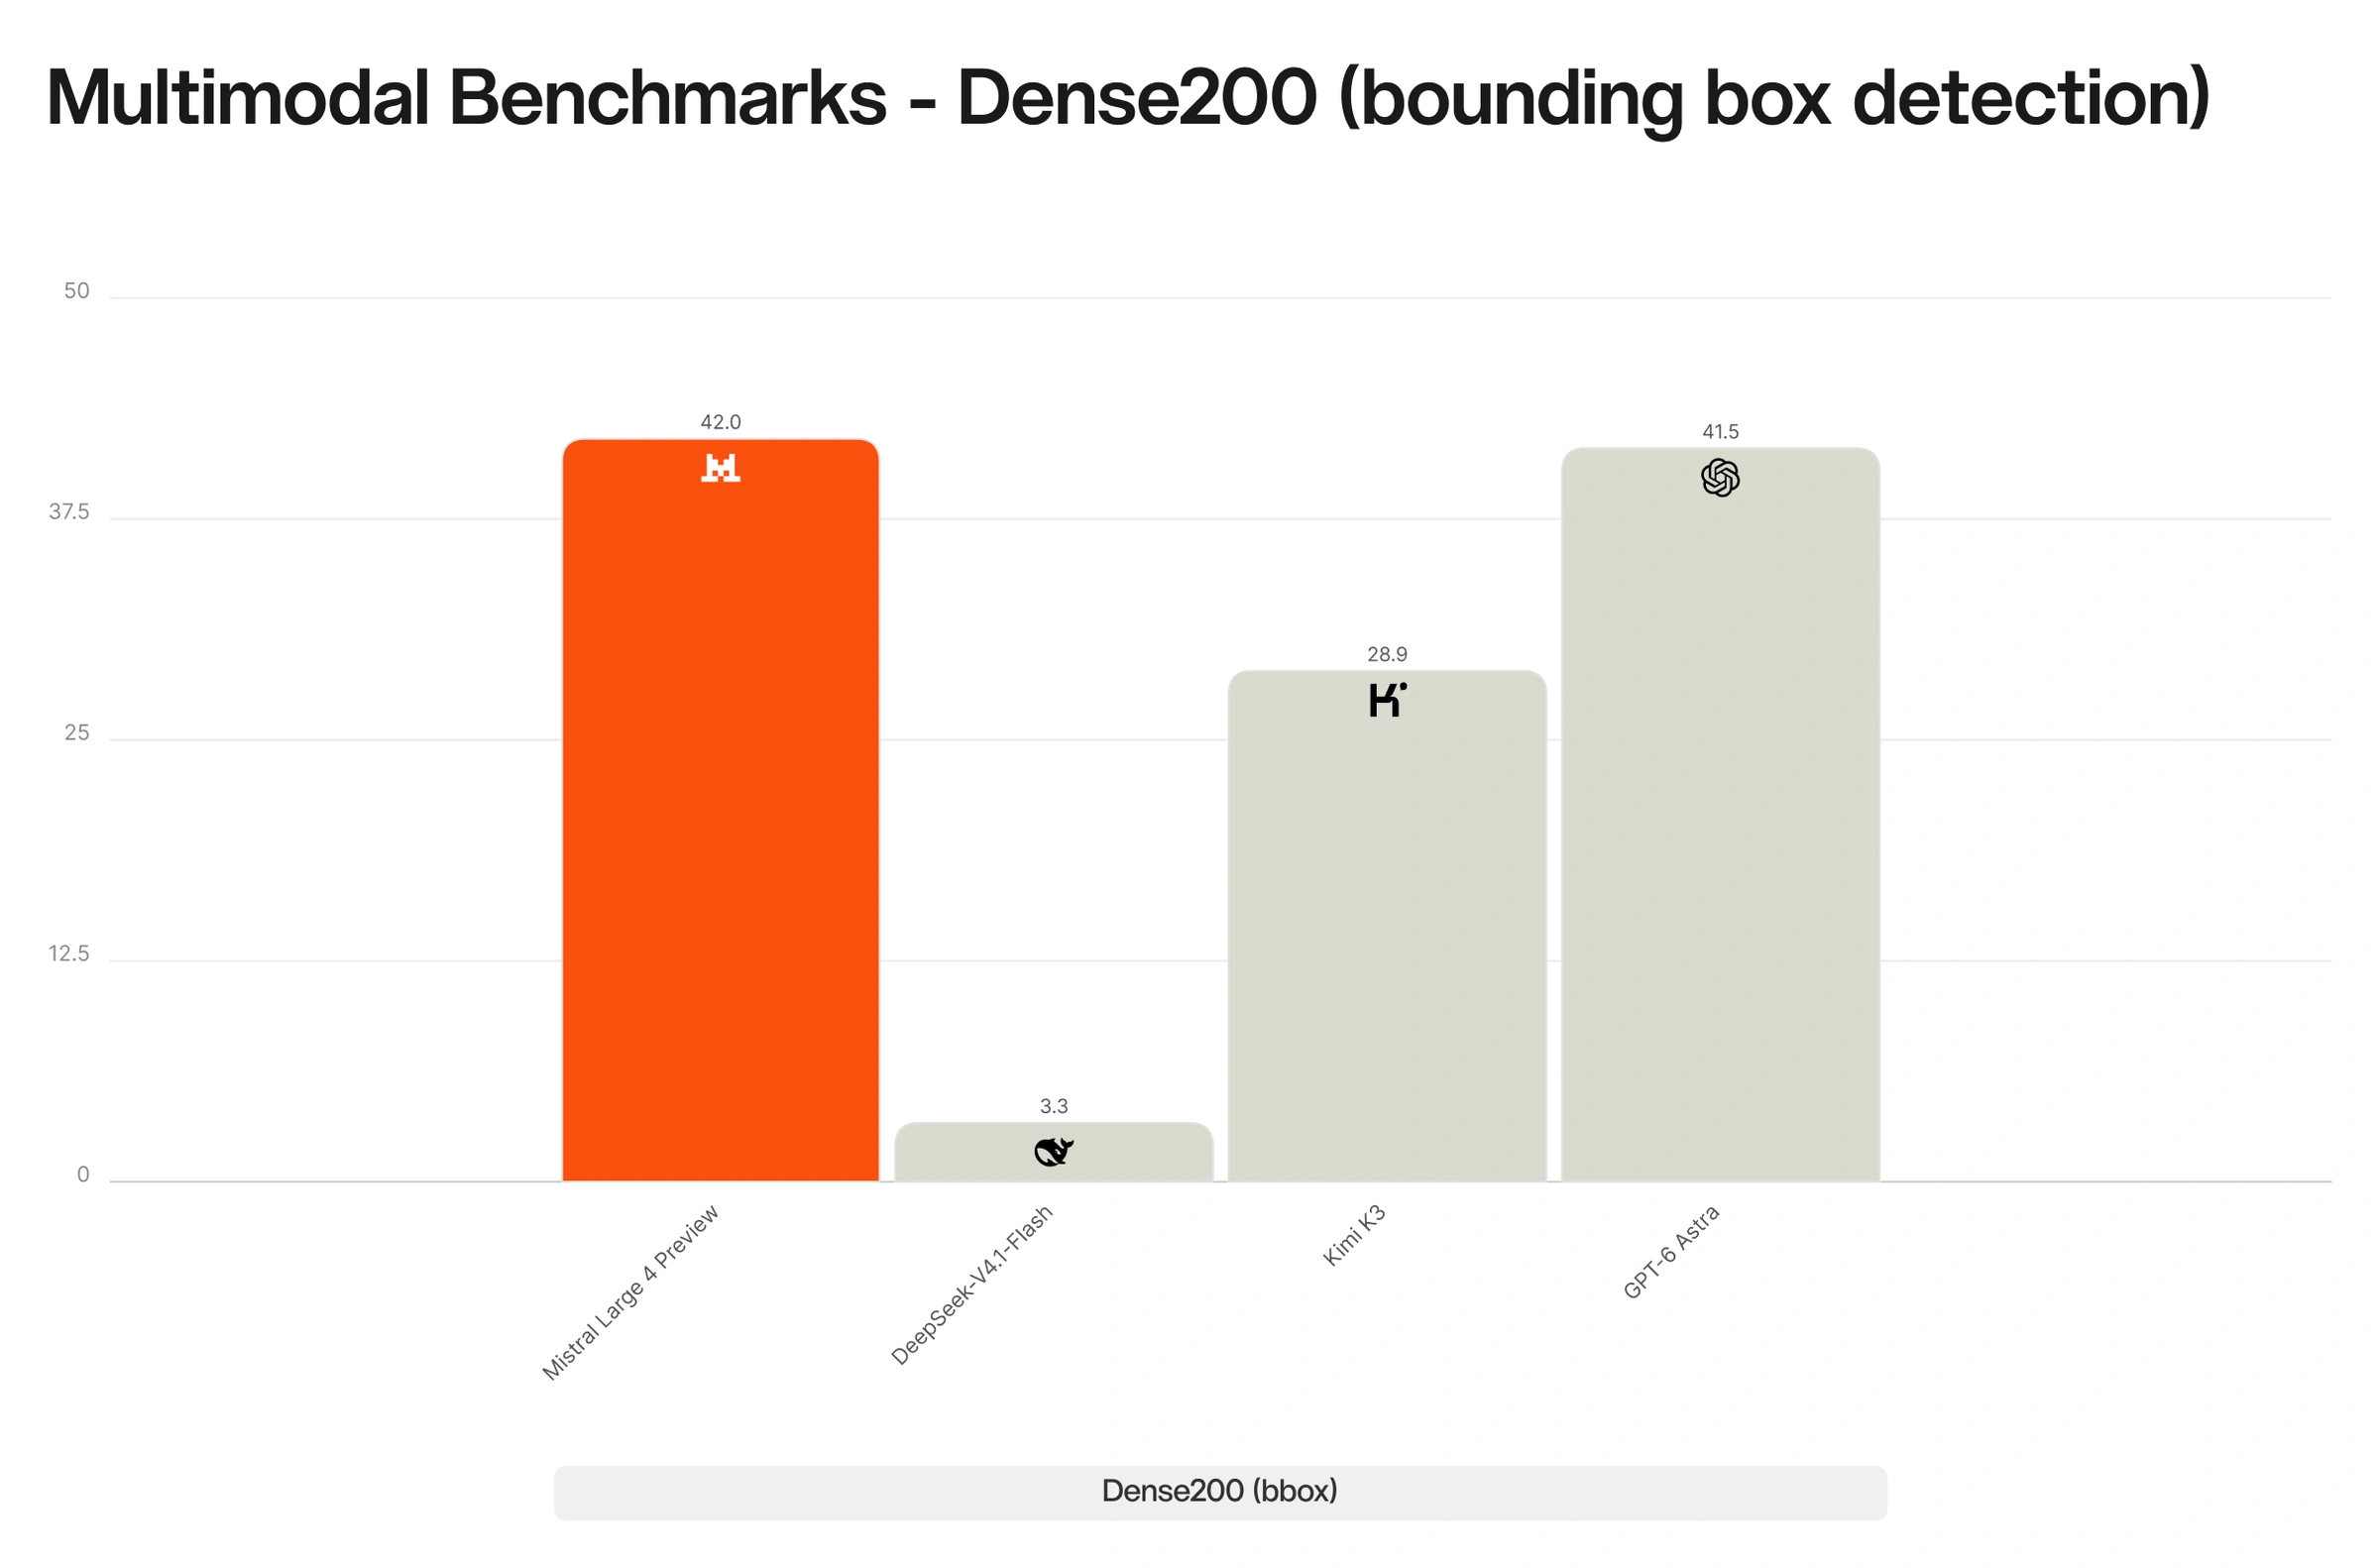
In particolare, nel grounding visivo, ML4 risulta tra i modelli più capaci che abbiamo testato, superando ad esempio GPT-6-Astra su Dense 200 (42% contro 41%).
Ricerca e matematica
ML4 offre solide capacità scientifiche, sviluppate combinando metodi basati sull'IA con le competenze dei nostri ricercatori in matematica, fisica e chimica.
Eccelle nello sviluppo con agenti IA per attività scientifiche come l'analisi dei dati, la modellazione e la simulazione della realtà fisica, consentendo a chi fa ricerca di concentrarsi sulle domande anziché sull'infrastruttura tecnica. Nei benchmark, ML4 è allo stato dell'arte su SciCode-Verified tra i modelli a pesi aperti. In pratica, può generare un'intera simulazione Hartree–Fock in un solo passaggio: un'attività chimica complessa e articolata in più fasi, costruita a partire da una serie di routine avanzate.
ML4 è più solido anche in matematica, sia nel ragionamento formale sia nella matematica applicata. Nelle nostre valutazioni umane, ragiona con maggiore precisione e struttura rispetto a GLM-5.3, e riesce a portare avanti attività lunghe di matematica applicata specifiche di dominio, comprese quelle rilevanti per la fisica teorica d'avanguardia.
Nel loro insieme, queste capacità rendono ML4 un valido assistente di ricerca lungo l'intero workflow tecnico, dalla prima domanda al risultato finale.
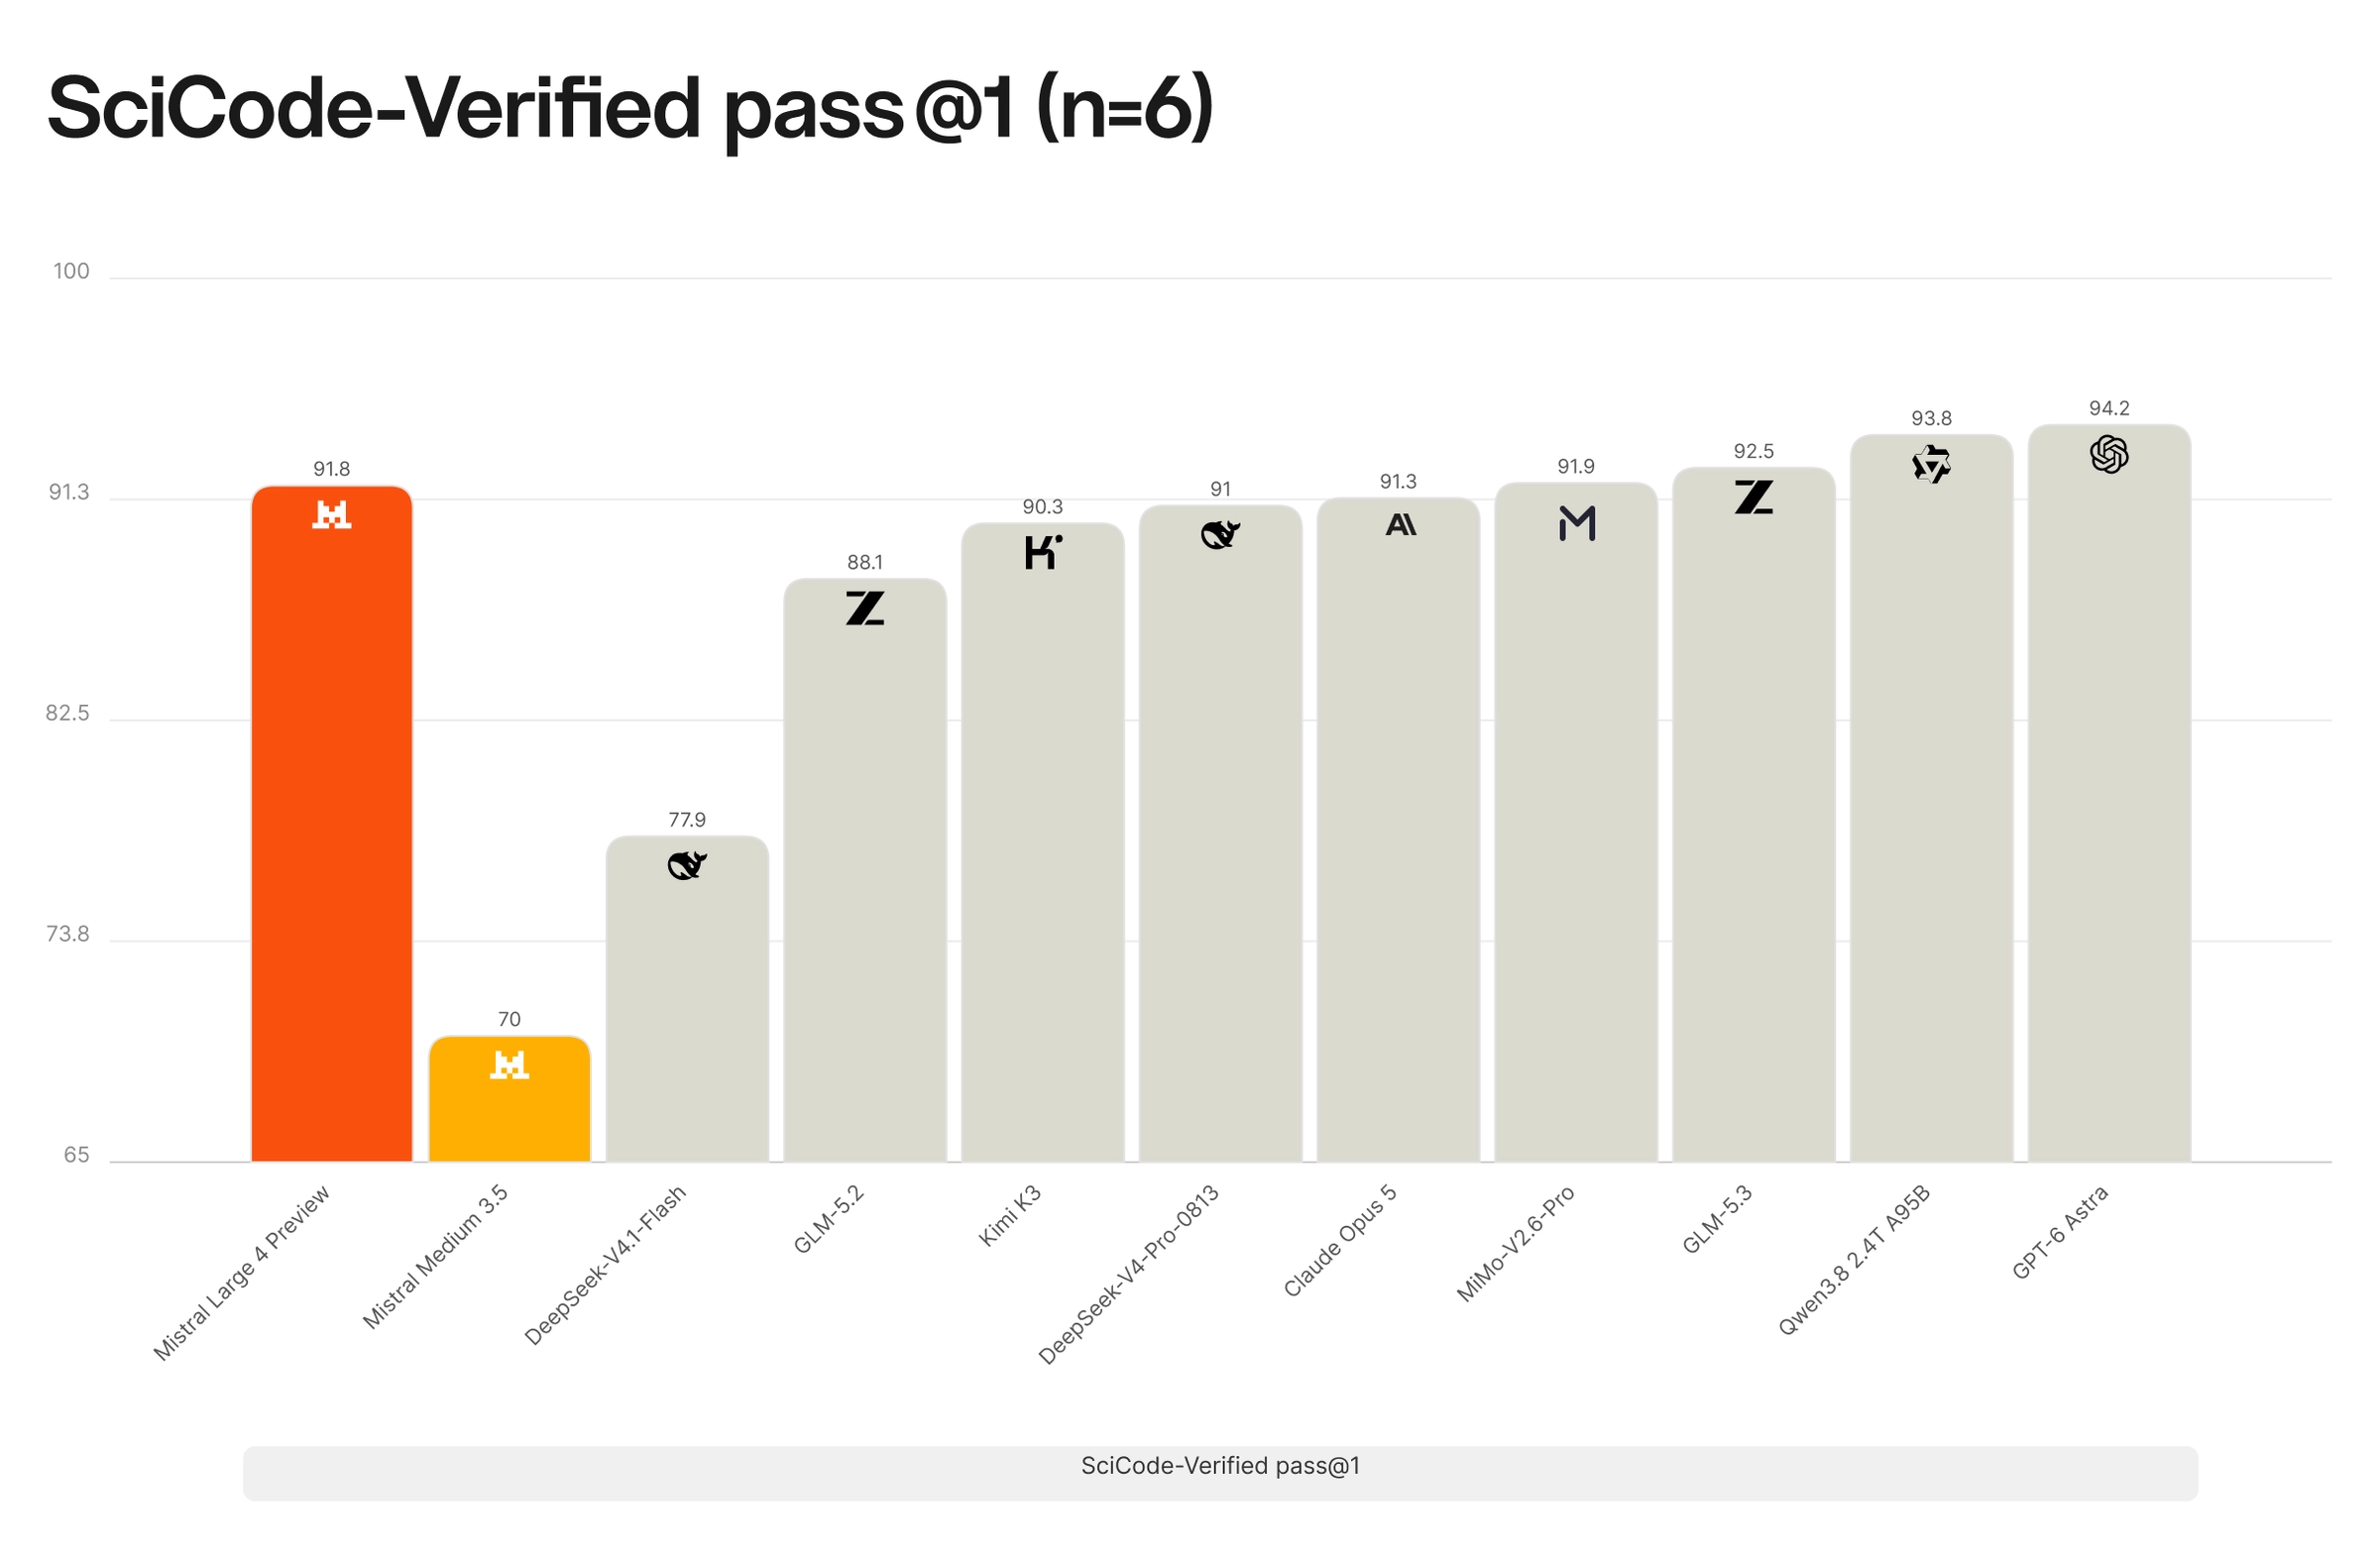
SciCode-Verified testa la capacità dei modelli di implementare in codice flussi di lavoro scientifici complessi in ambiti come fisica, matematica, scienza dei materiali e biologia.

Valutazione interna di ML4 rispetto a GLM5.3 su attività STEM (matematica e fisica)
Attività operativa intellettuale
ML4 è il nostro modello più capace per le attività concrete che i professionisti affrontano ogni giorno. Può creare, modificare e correggere fogli di calcolo e documenti complessi, mostrando prestazioni esemplari nei benchmark sia legali sia finanziari.
In particolare, abbiamo valutato ML4 tramite valutatori indipendenti (vals.ai) su attività rappresentative in ambito legale e finanziario, riscontrando che il modello supera GPT-6-Astra in entrambi i casi. Nel benchmark Legal Agent di HarveyAI, ML4 supera tutti i modelli open source.
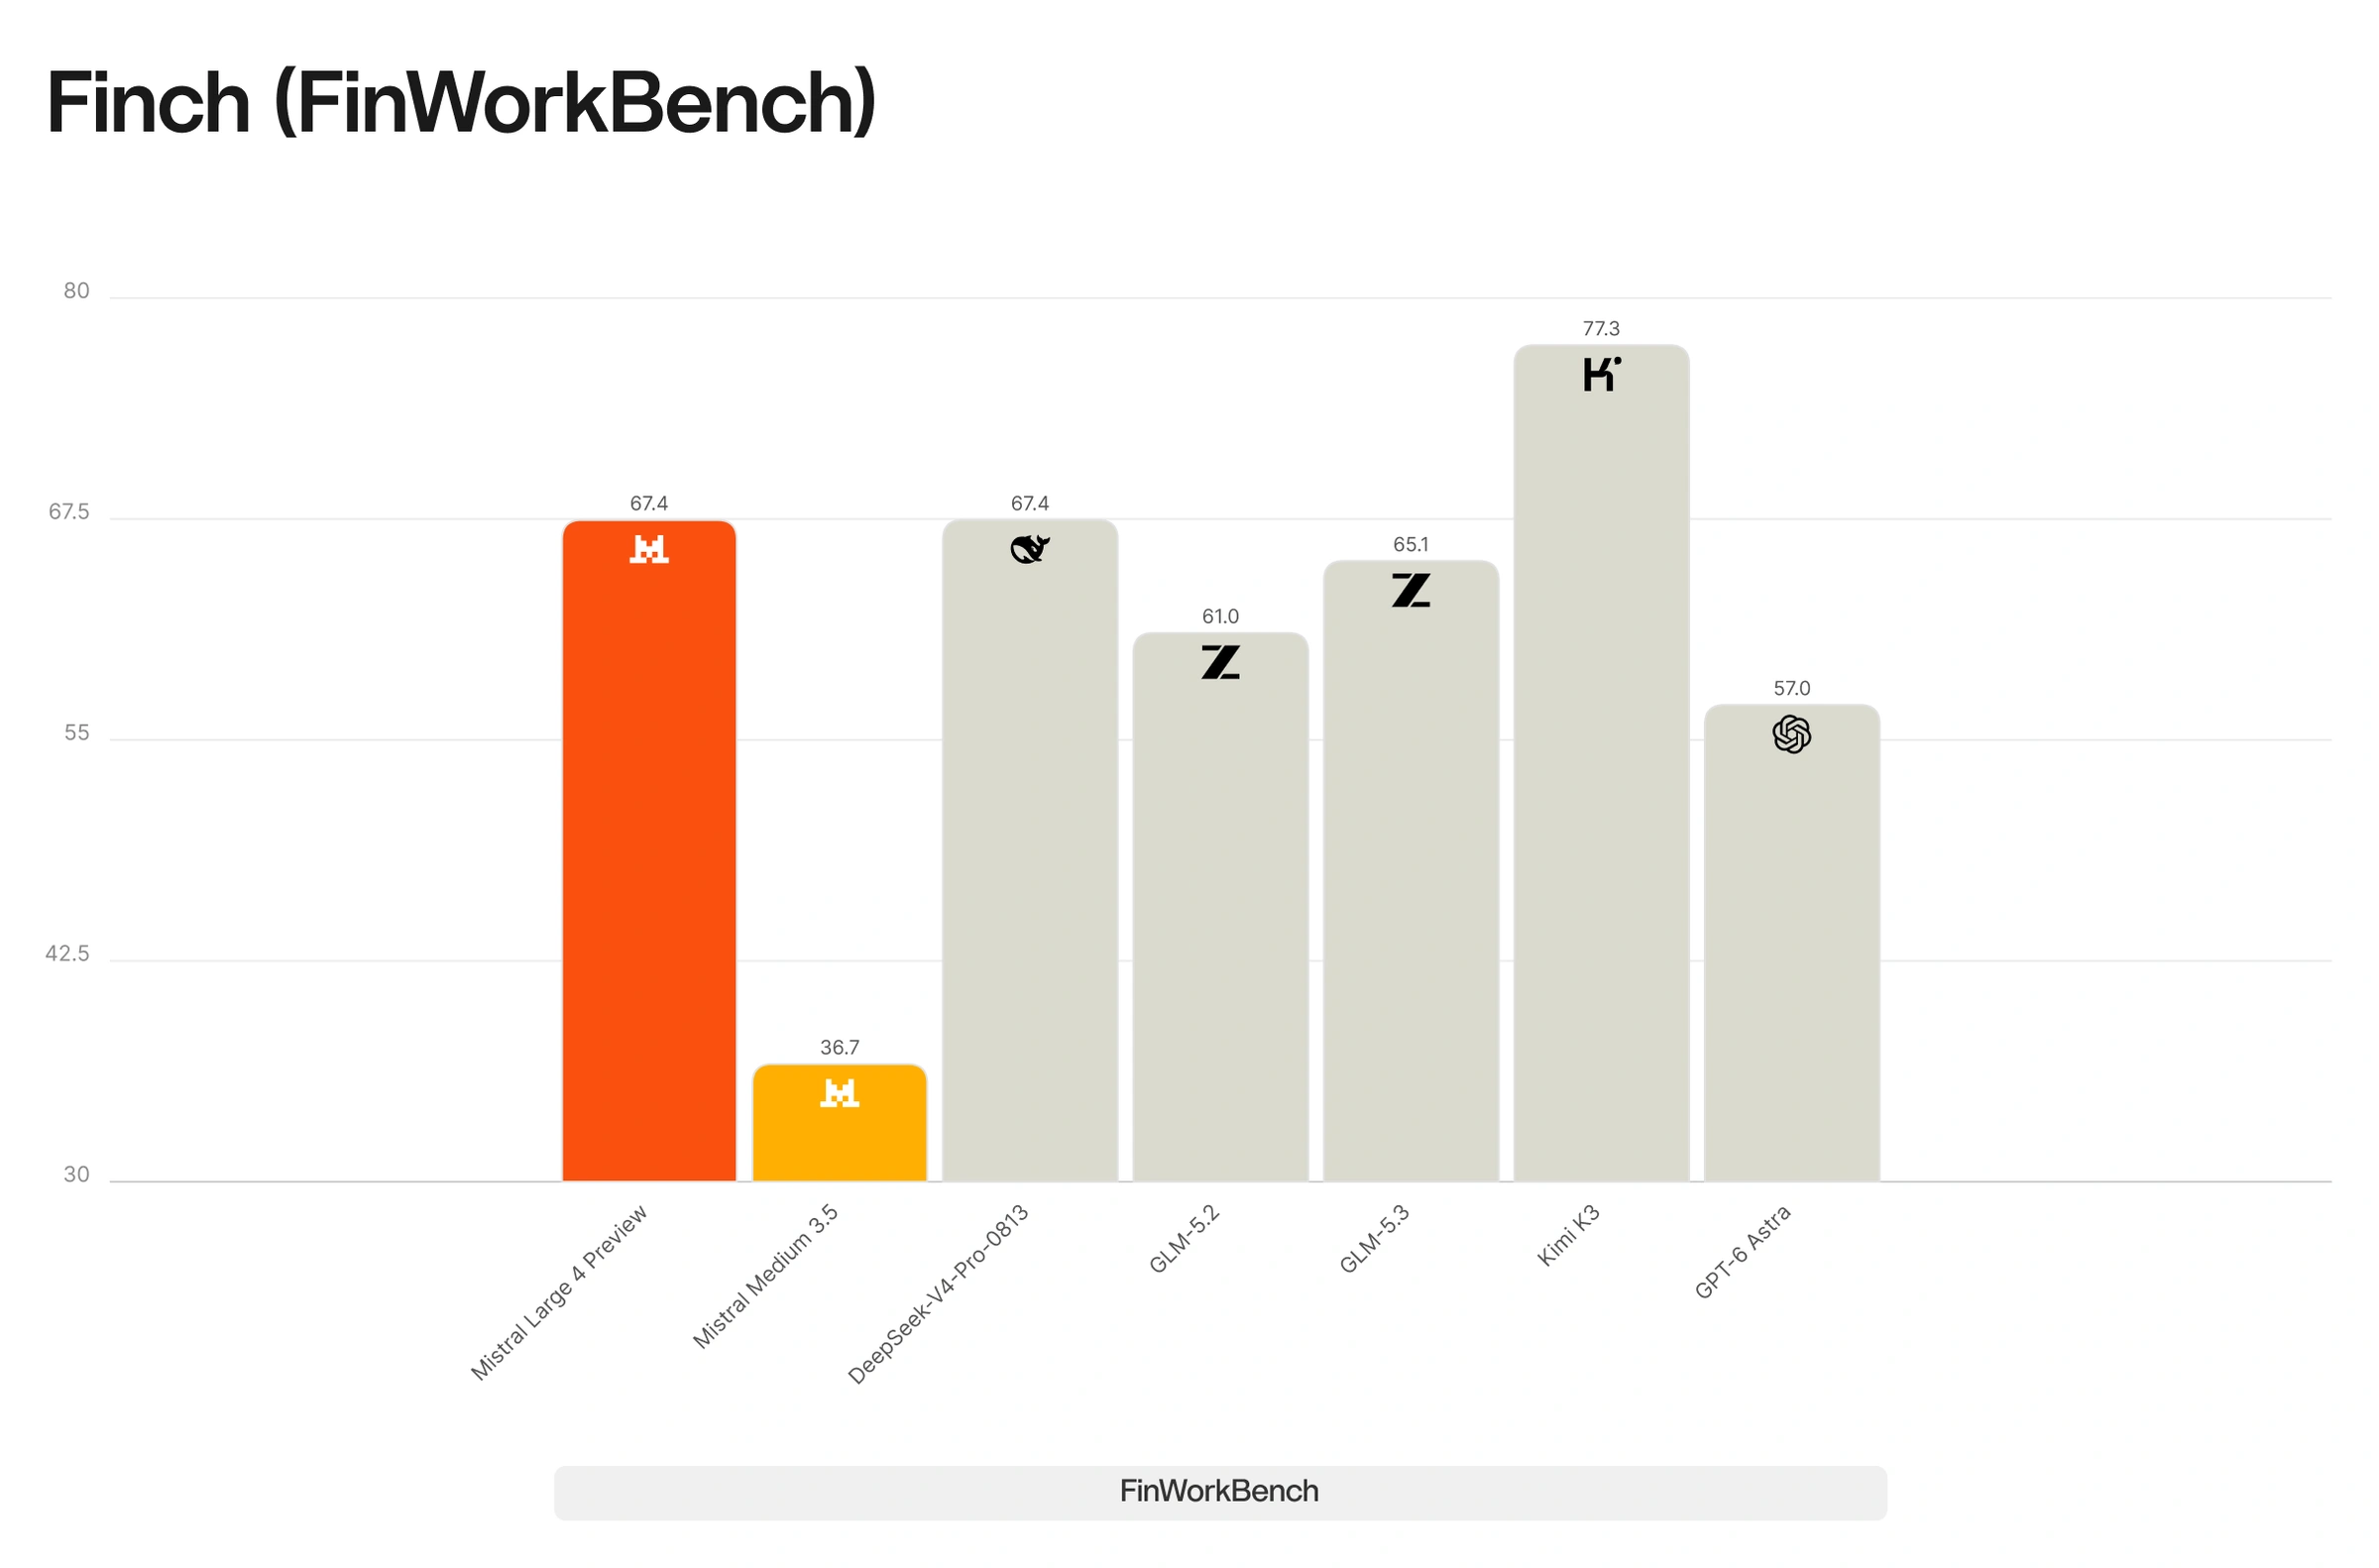
FinWorkBench testa la capacità dei modelli di creare e modificare fogli di calcolo per casi d'uso reali in ambito finanziario e contabile.
L'analisi finanziaria richiede precisione e capacità di sintetizzare informazioni provenienti da più fonti, un processo che ancora oggi richiede molto tempo in numerosi istituti finanziari. In questa demo, ML4 e altri modelli OSS di punta affrontano la stessa sfida di finanza aziendale articolata in più fasi, effettuando ricerche tra documenti societari pubblici e relazioni finanziarie, come quelli disponibili tramite EDGAR e database europei equivalenti. Una mappa semantica animata traccia il percorso di ciascun modello verso una soluzione, evidenziando ogni documento recuperato lungo il cammino. La posizione di ciascun tracciato riflette le evidenze raccolte, i risultati dei calcoli e le domande ancora irrisolte. È possibile seguire lo svolgimento delle indagini e confrontare i diversi percorsi intrapresi da ciascun modello prima di arrivare alla risposta finale.
Sicurezza del modello
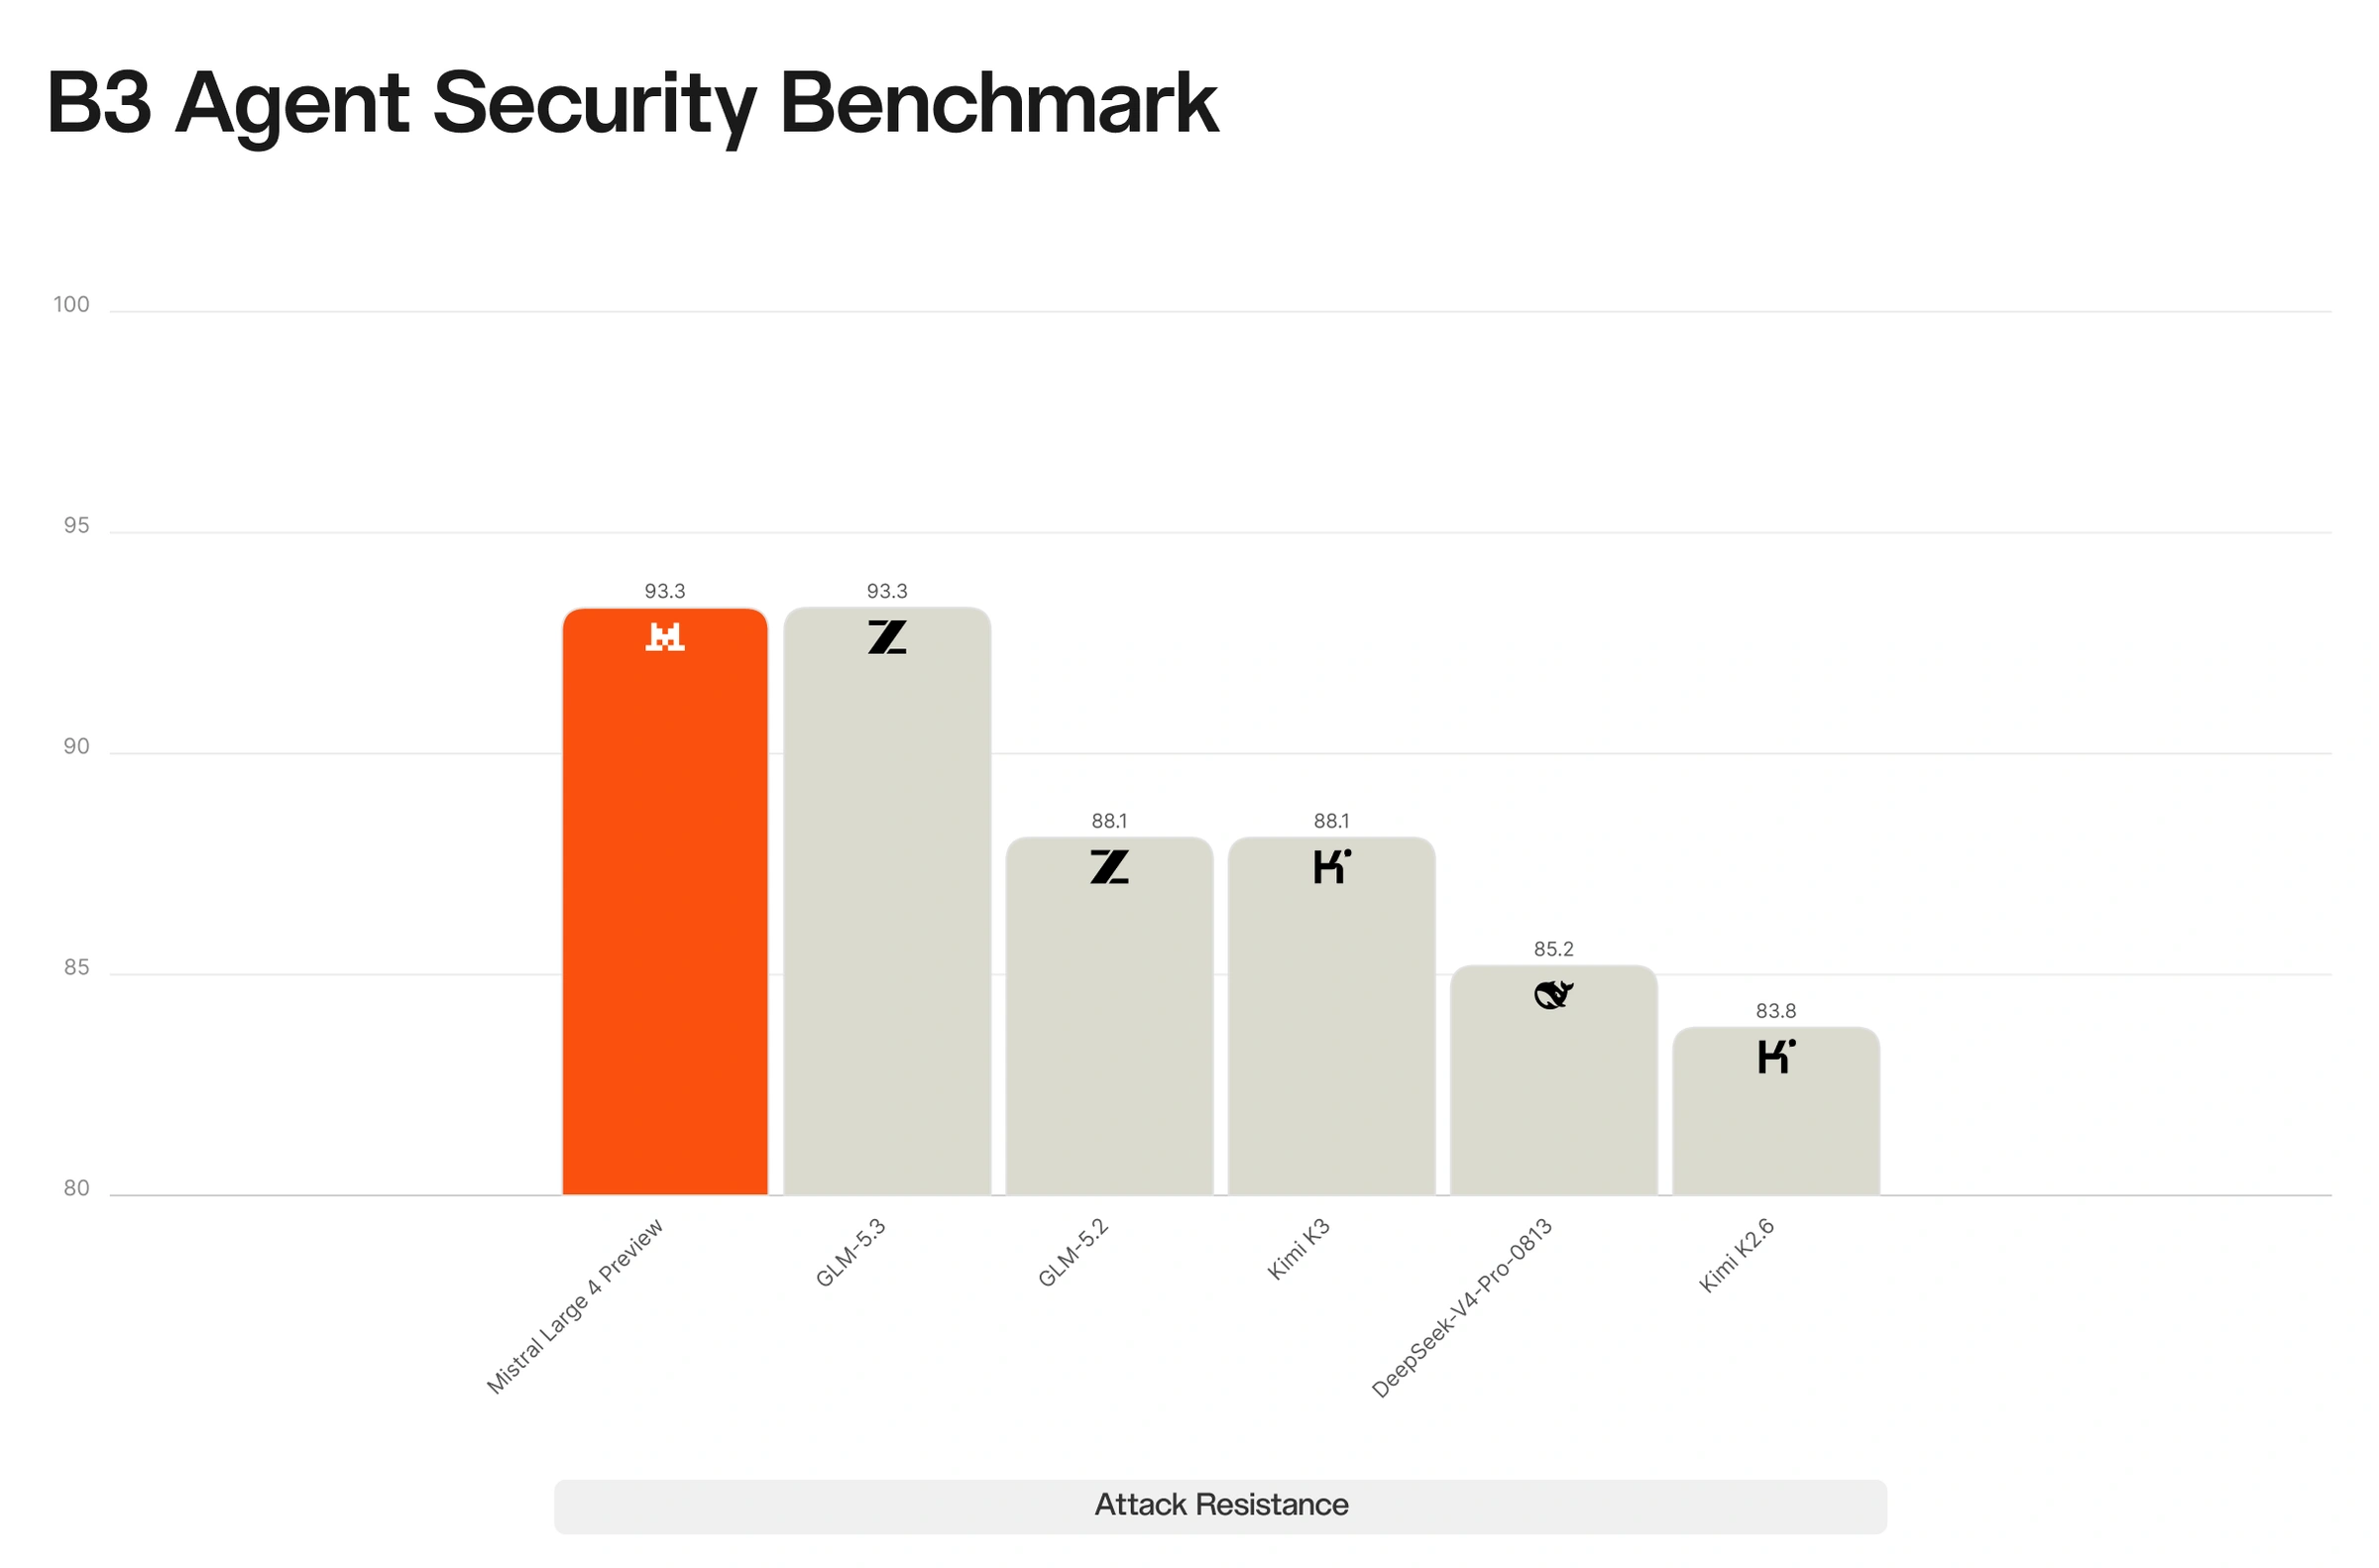

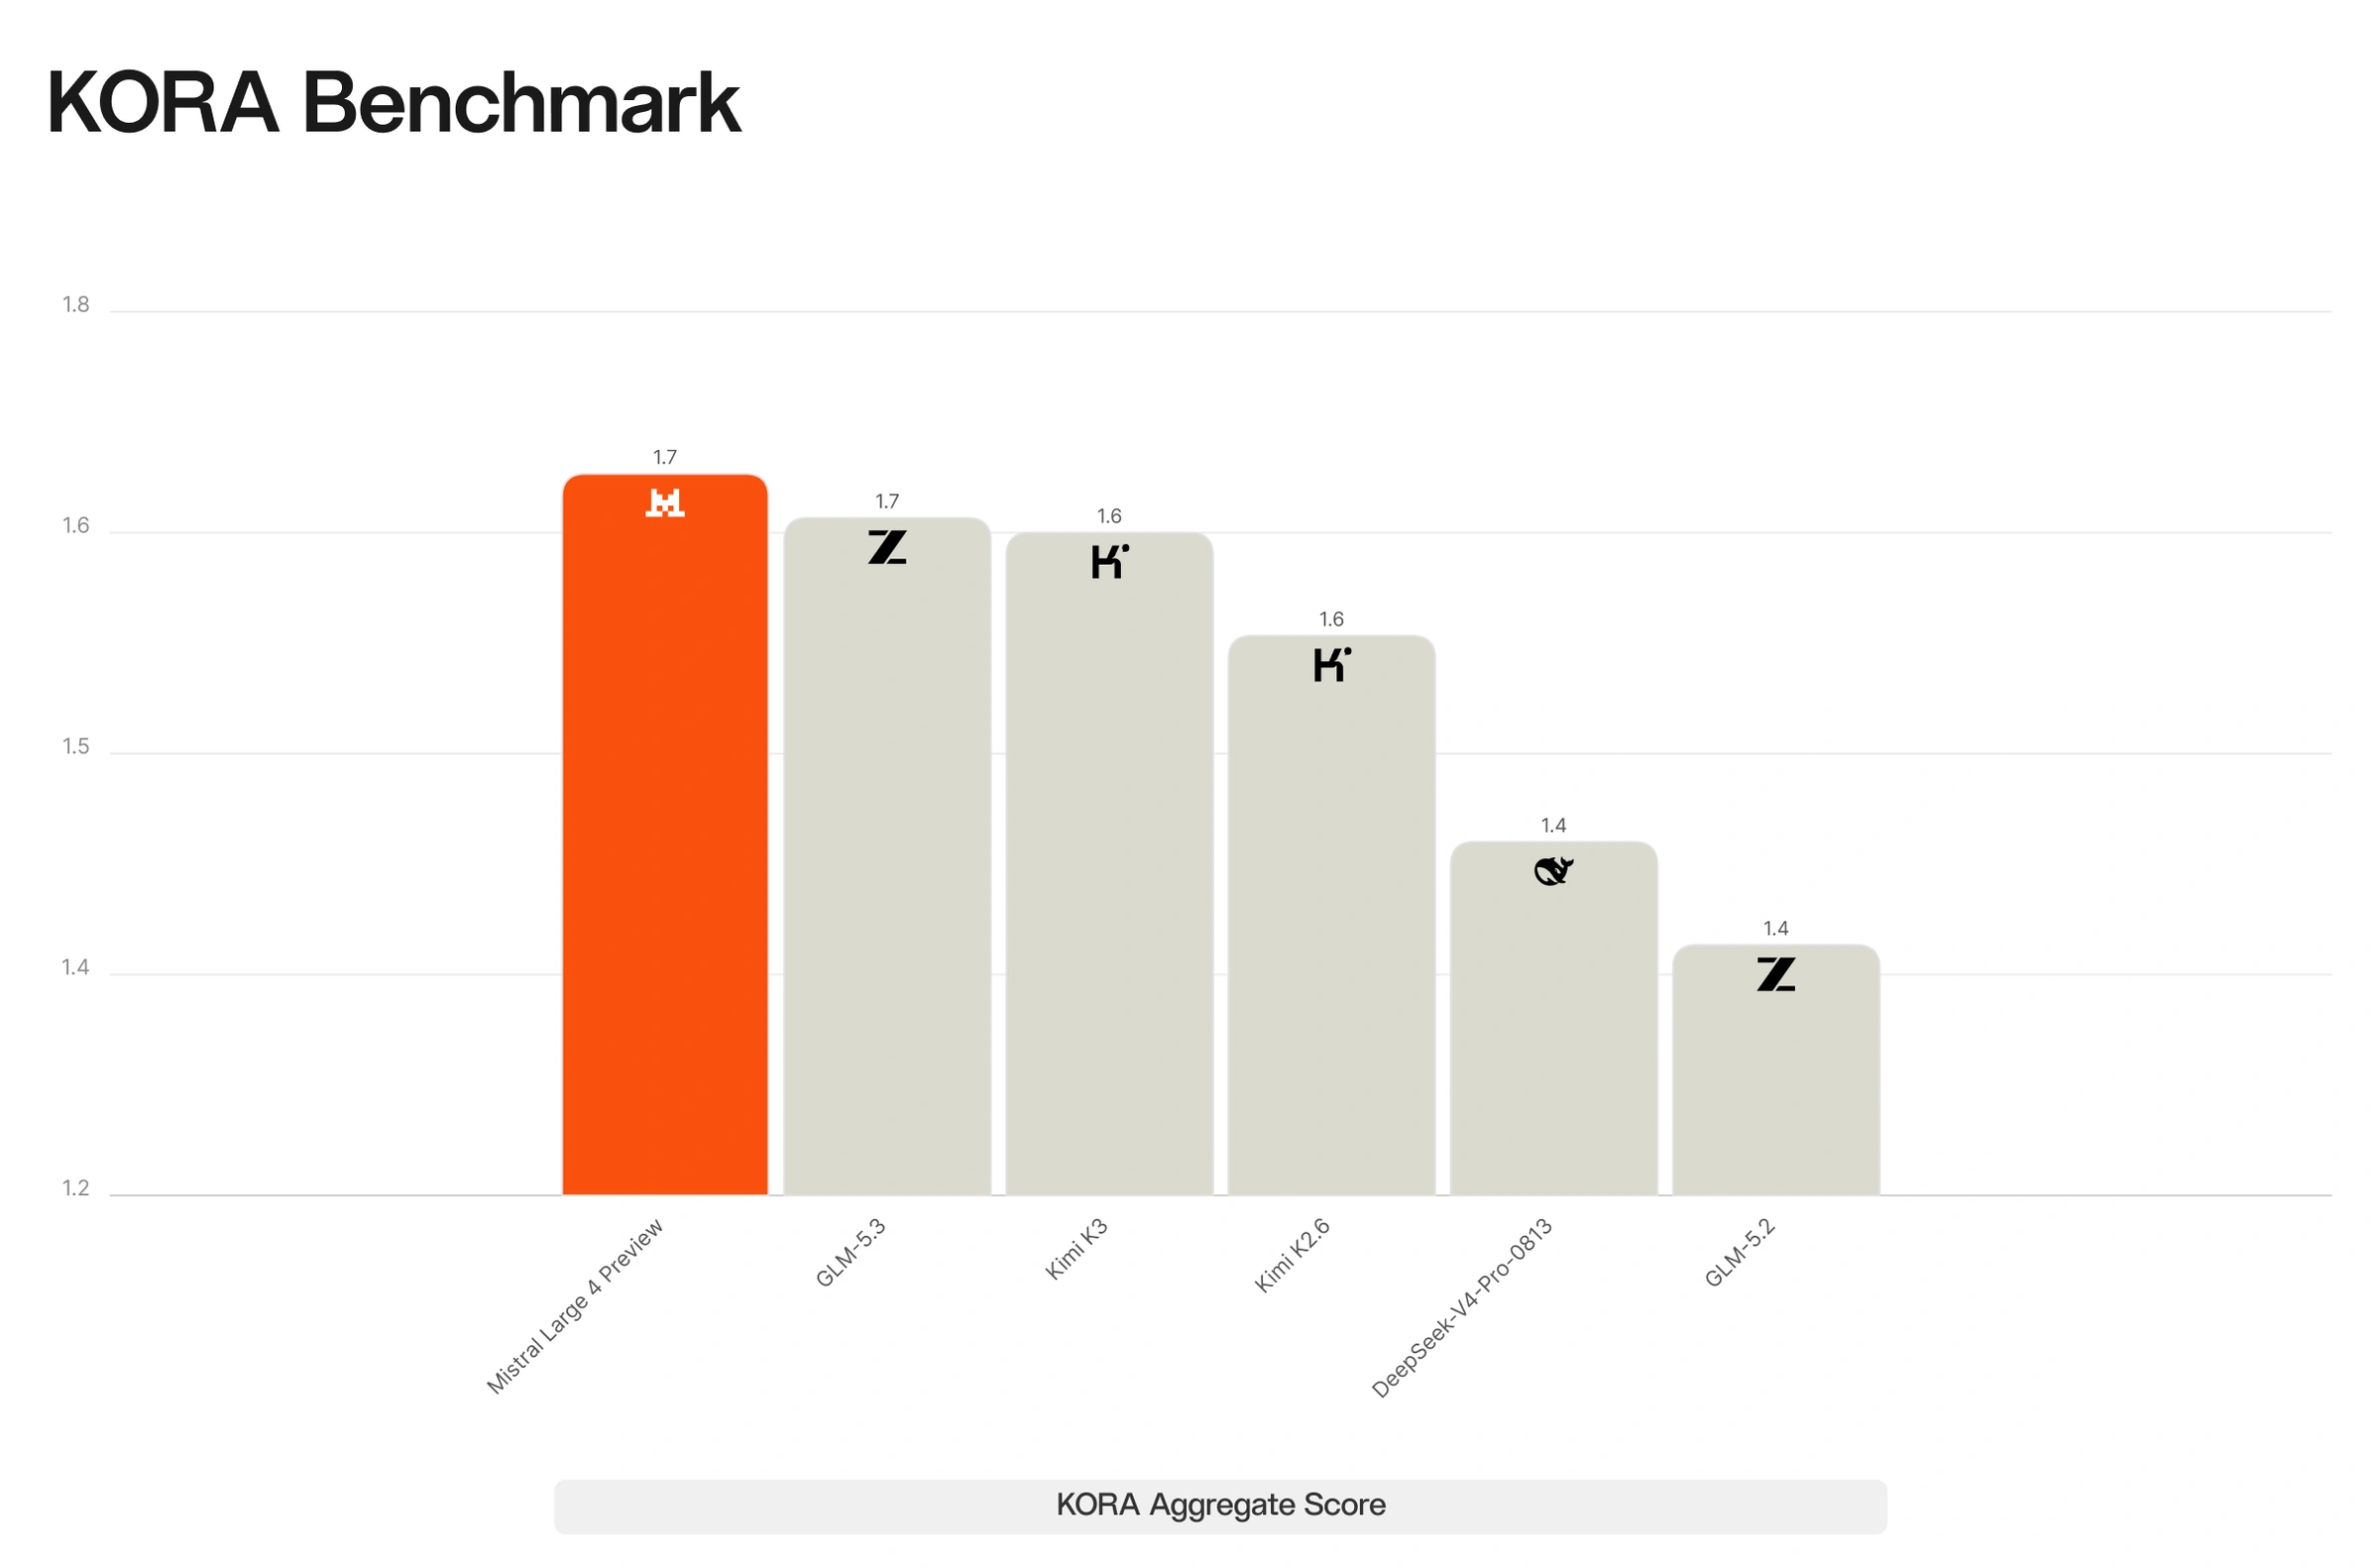
ML4 ha saturato i nostri benchmark di robustezza alle prompt injection indirette, collocandosi tra i modelli OSS più avanzati (rispetto a GLM-5.2, GLM-5.3, Kimi-K2.6, Kimi-K3, DS-V4-Pro-0813). Nel benchmark pubblico di Lakera B3 AI Security Benchmark, ML4 resiste al 93,3% degli attacchi: non rileviamo punteggi superiori tra i concorrenti.
ML4 interagisce inoltre con gli utenti in modo più responsabile rispetto a tutti i nostri modelli precedenti. Evidenziamo i risultati ottenuti nel KORA Benchmark, dove ML4 raggiunge ancora una volta il punteggio più alto da noi misurato tra i modelli OSS (1,691, con 2 come massimo, indicato come “Esemplare”).
Particolarmente rilevante è la propensione del modello a rifiutare richieste malevole relative alla sicurezza informatica. Nonostante le ottime prestazioni nei benchmark di ambito informatico, il tasso medio di rifiuto del modello sui prompt informatici di JailbreakBench, StrongREJECT e AgentHarm è superiore a quello di tutti i modelli OSS.
Valutazione umana
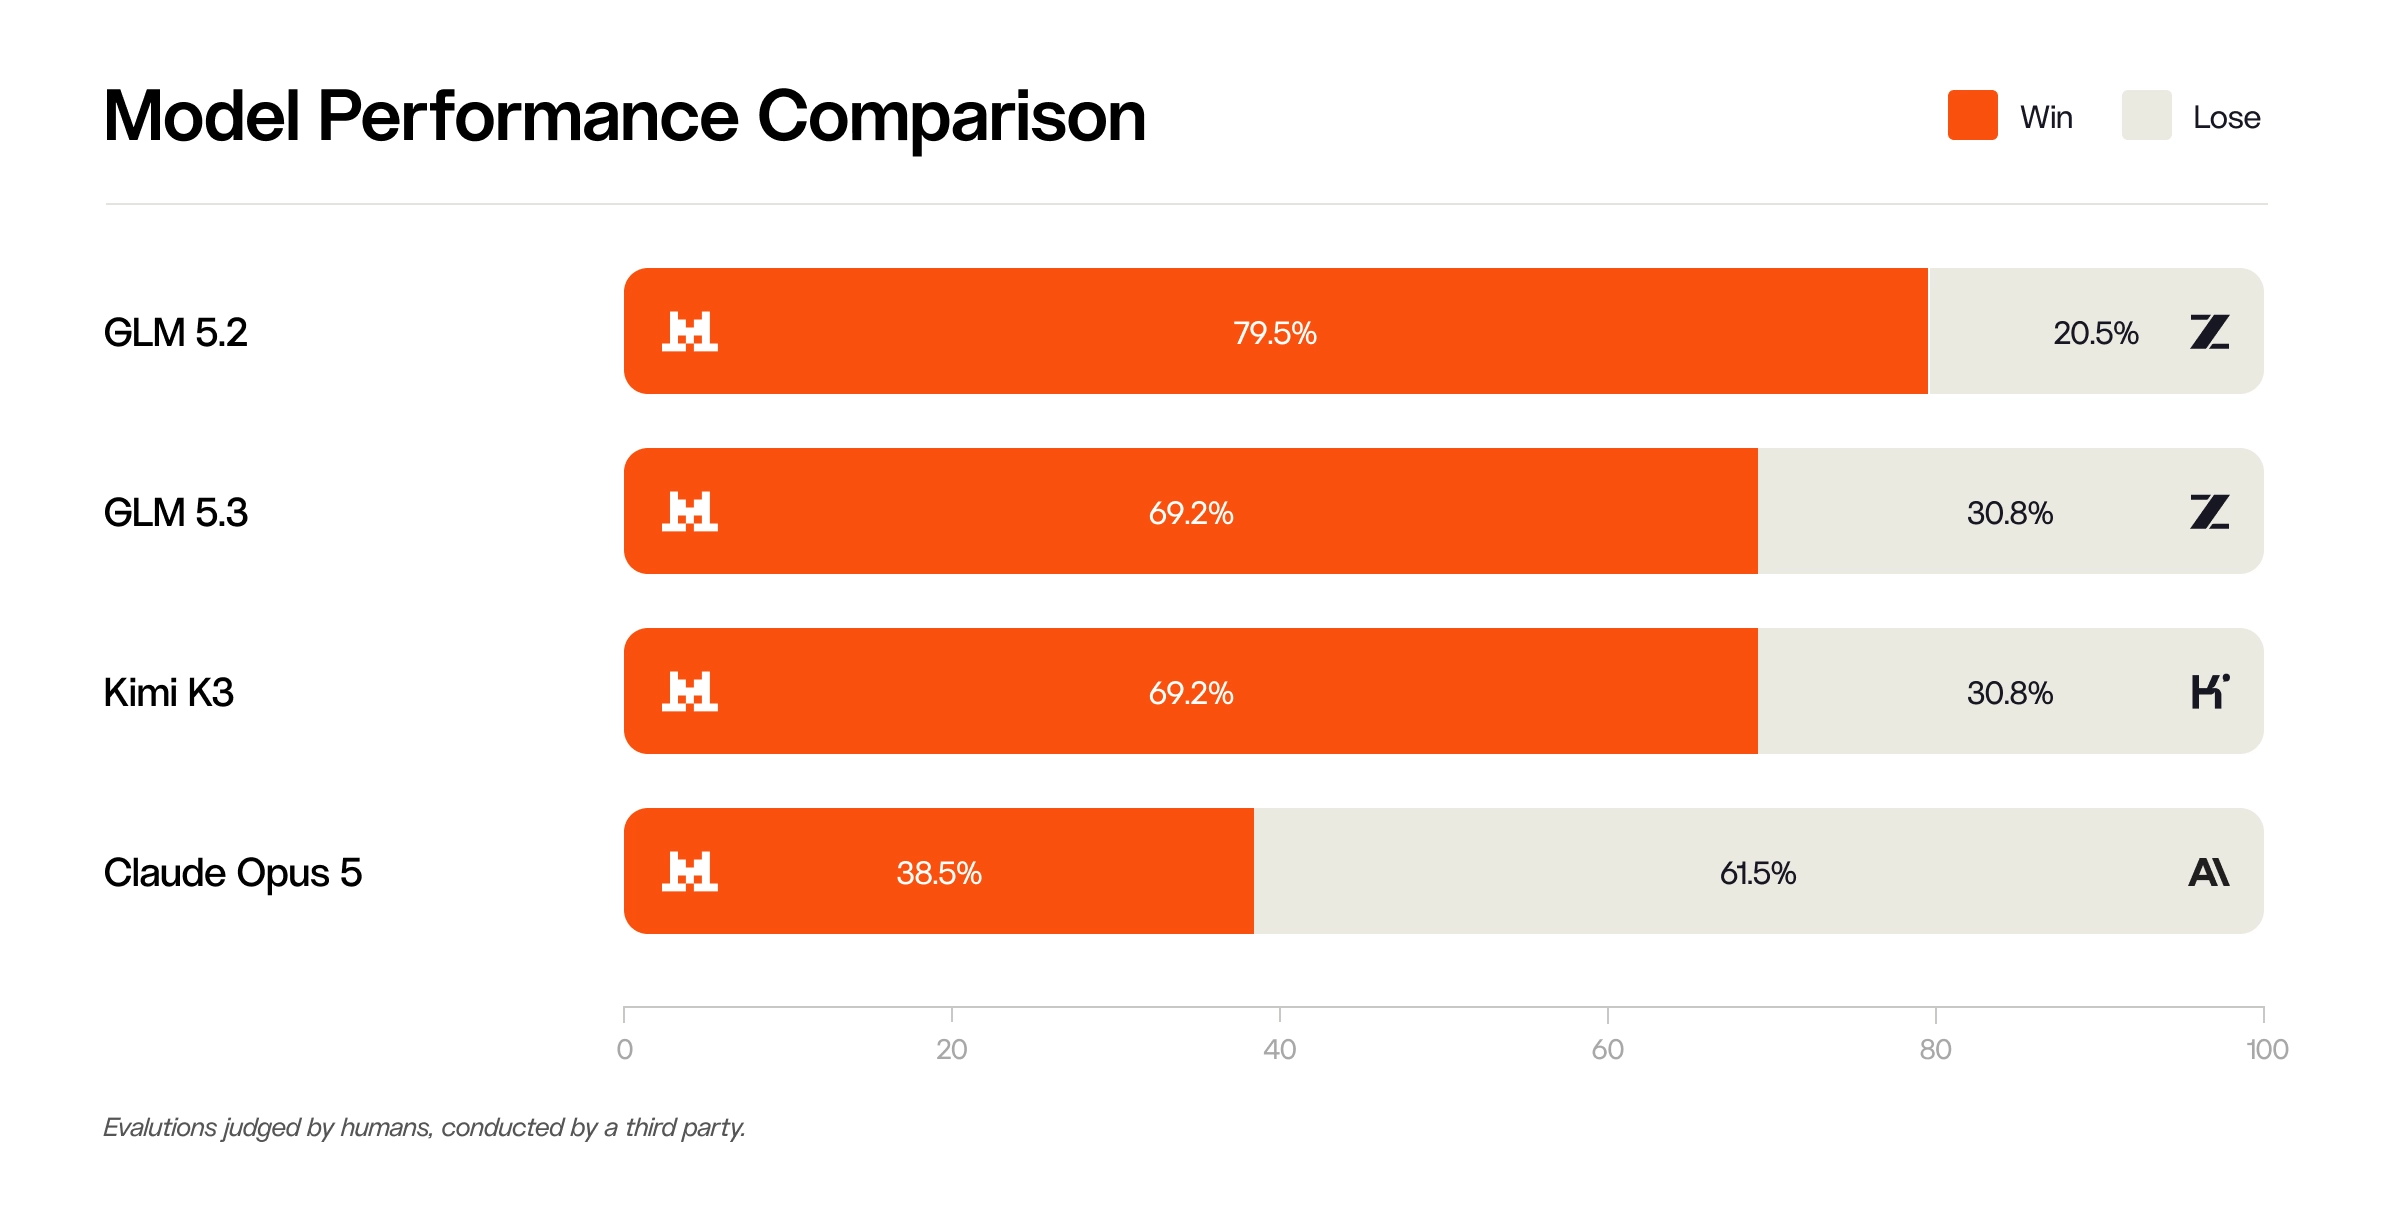
Abbiamo condotto una valutazione interna in cui annotatori esperti in codifica, progettazione assistita da computer (CAD), finanza, matematica e fisica hanno confrontato Mistral Large 4 con GLM-5.3. ML4 è stato preferito nel CAD e nelle discipline STEM, mentre ha ottenuto prestazioni pari o vicine a quelle di GLM-5.3 in finanza e codifica.
Apprendimento per rinforzo su larga scala
I modelli di base migliorano rapidamente e il nostro post-training deve tenere il passo. Una ricetta ottimizzata per il modello di ieri non sfrutta appieno le capacità dei modelli più avanzati di oggi, perché gli esempi di ground truth che un tempo spingevano un modello al limite non lo fanno più. Utilizziamo l'apprendimento per rinforzo (RL) perché si adatta all'evoluzione del modello: addestriamo sui risultati dei tentativi del modello stesso e possiamo aumentare la difficoltà e la varietà delle attività man mano che diventa più capace.
La nostra libreria RL è stata progettata per semplificare l'aggiunta di nuovi ambienti e l'addestramento su larga scala. Un'interfaccia condivisa e componibile consente di combinare, in un'unica esecuzione di addestramento, attività che spaziano dalle conversazioni a turno singolo e dalla risoluzione di problemi scientifici complessi all'allineamento alla sicurezza, all'accuratezza fattuale e all'uso di strumenti su orizzonti lunghi. Questi ambienti condividono strutture di supporto e risorse, come sandbox per il codice, ricerca web e API esterne. La stessa componibilità si estende alla verifica, combinando modelli di ricompensa, test unitari, giudici LLM e controlli statici in base alle esigenze di ciascuna attività.
Durante l'esecuzione, un insieme di attori con scalabilità automatica genera decine di migliaia di rollout in parallelo, mentre l'addestramento del modello procede in modo asincrono. La pipeline di generazione e addestramento è ottimizzata per traiettorie lunghe e supporta budget di rollout di milioni di token attraverso più compattazioni, mantenendo basso il grado di obsolescenza. Metodi innovativi e ottimizzazioni in entrambe le fasi riducono al minimo la deriva off-policy e consentono un RL stabile su orizzonti lunghi.
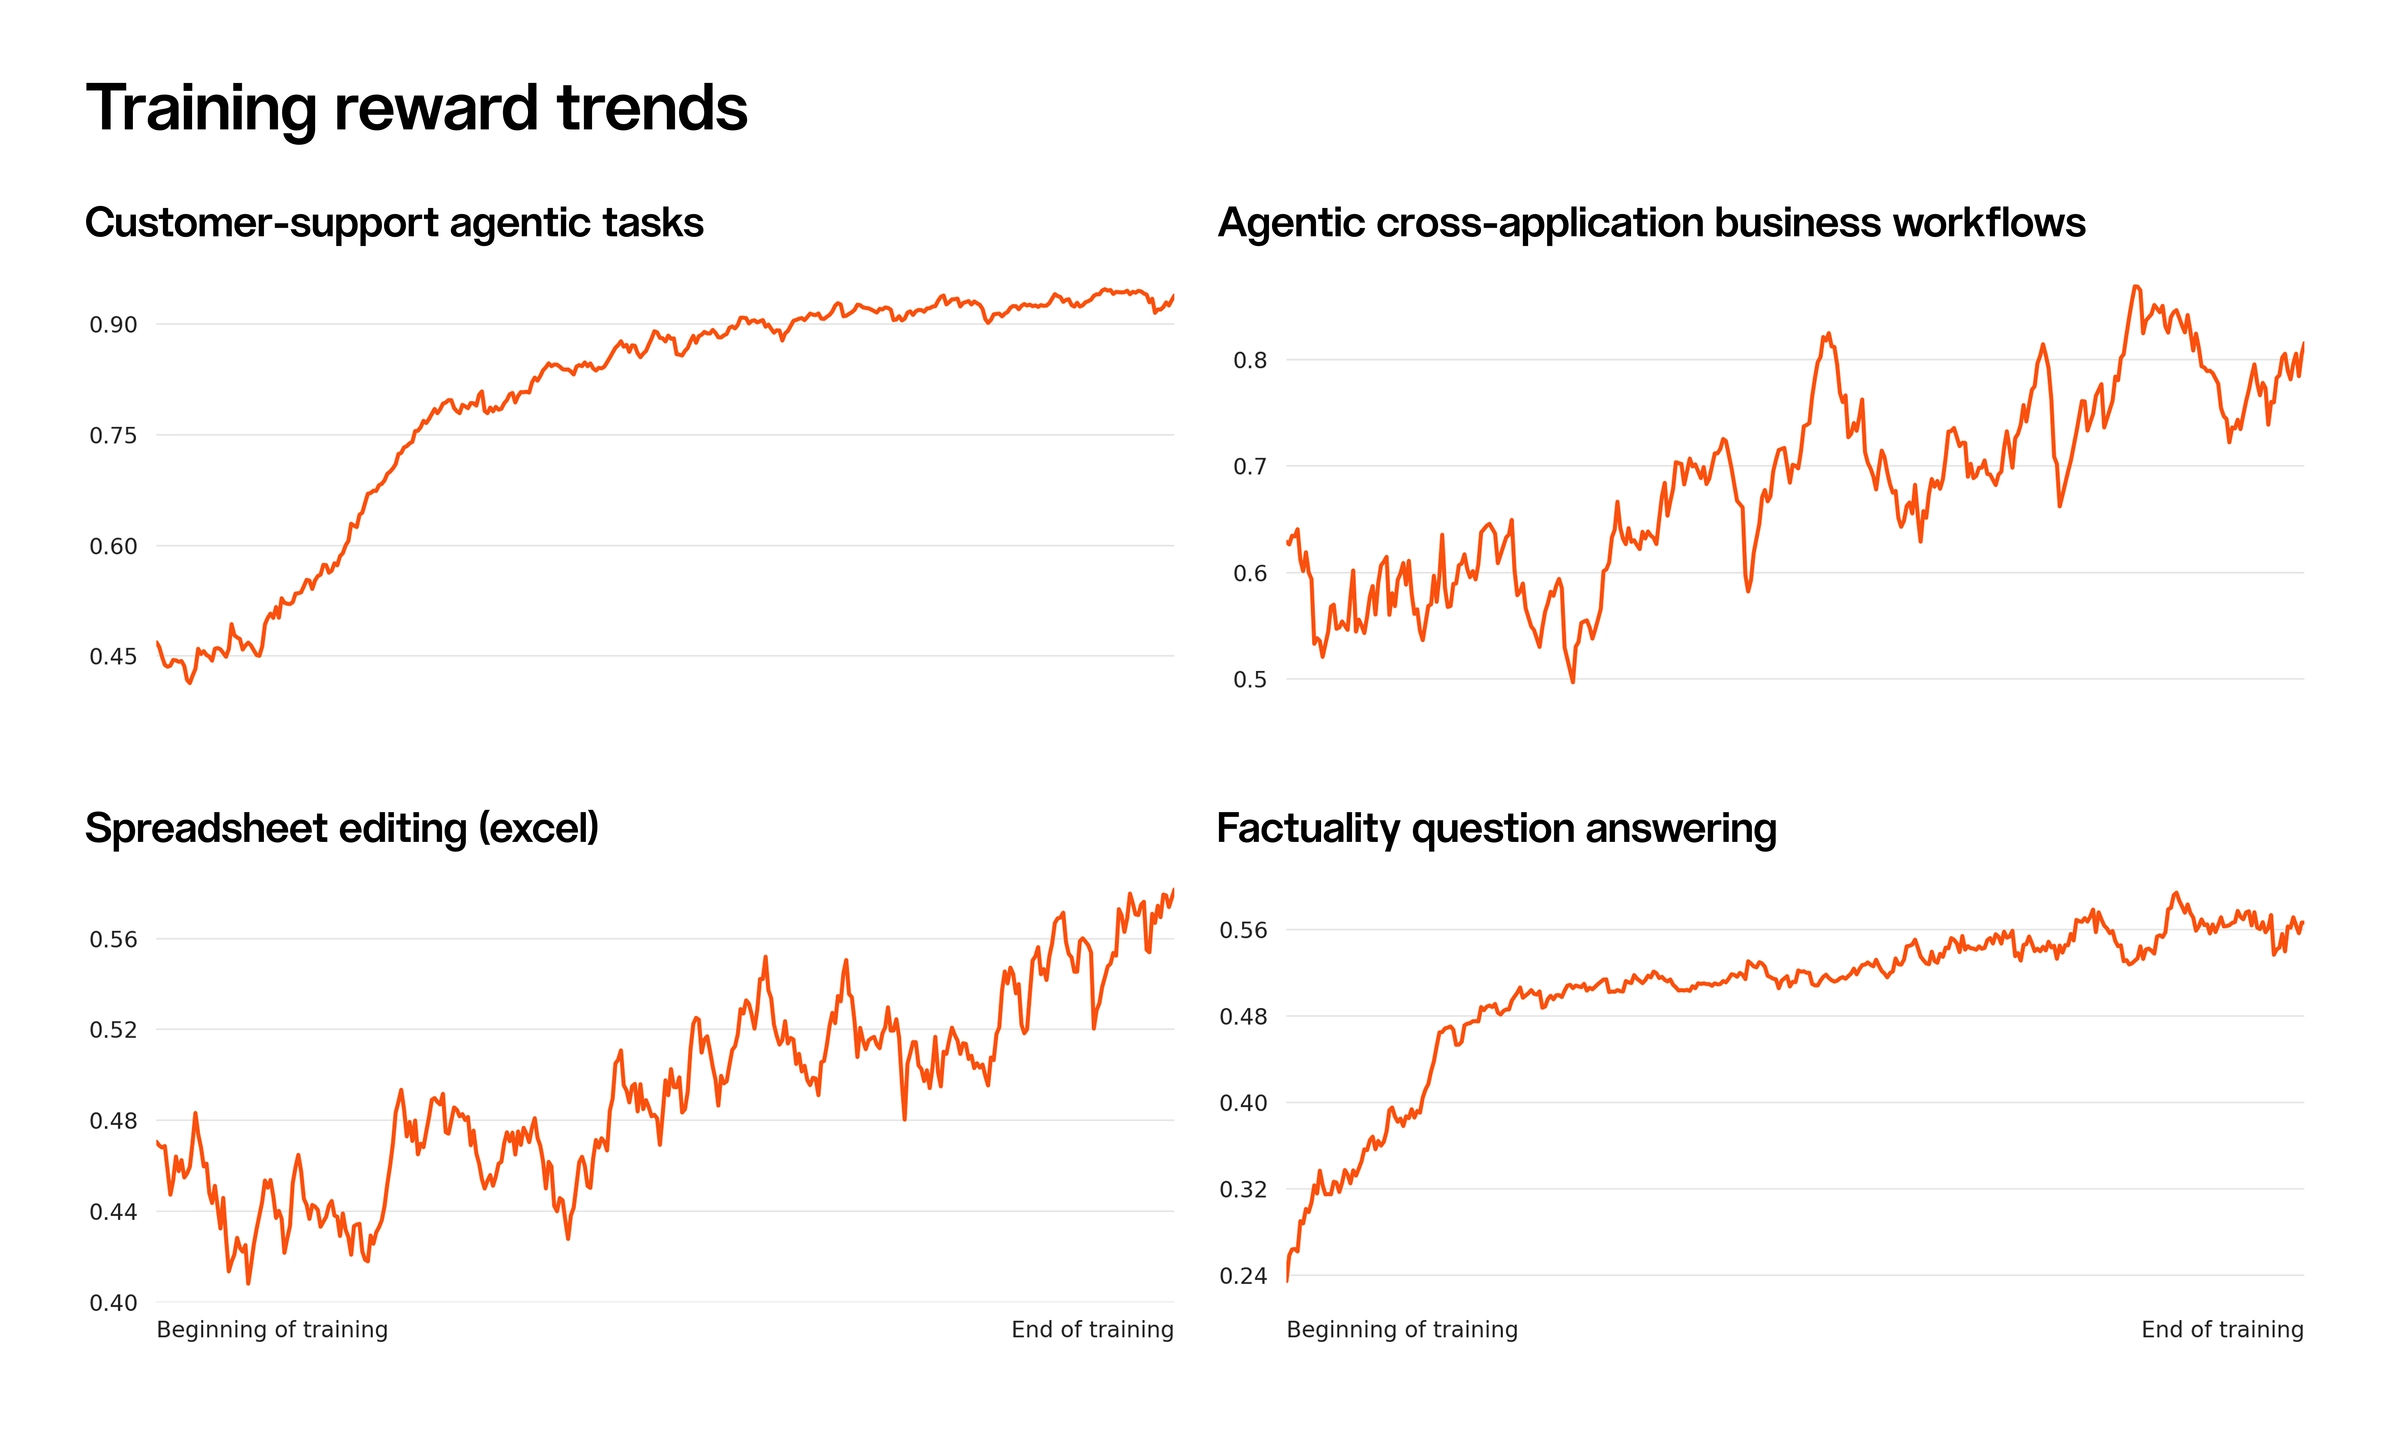
Alla scala attuale (3.000 GPU), una singola esecuzione di addestramento produce circa 33 miliardi di token al giorno, di cui circa 16 miliardi sono token di completamento utilizzabili per l'addestramento dopo il filtraggio e il mascheramento. Possiamo osservare l'avanzamento dell'esecuzione direttamente nei rollout di addestramento: le ricompense aumentano in diversi ambienti rappresentativi man mano che la policy impara a risolvere attività sempre più complesse. Di seguito sono riportati alcuni esempi.
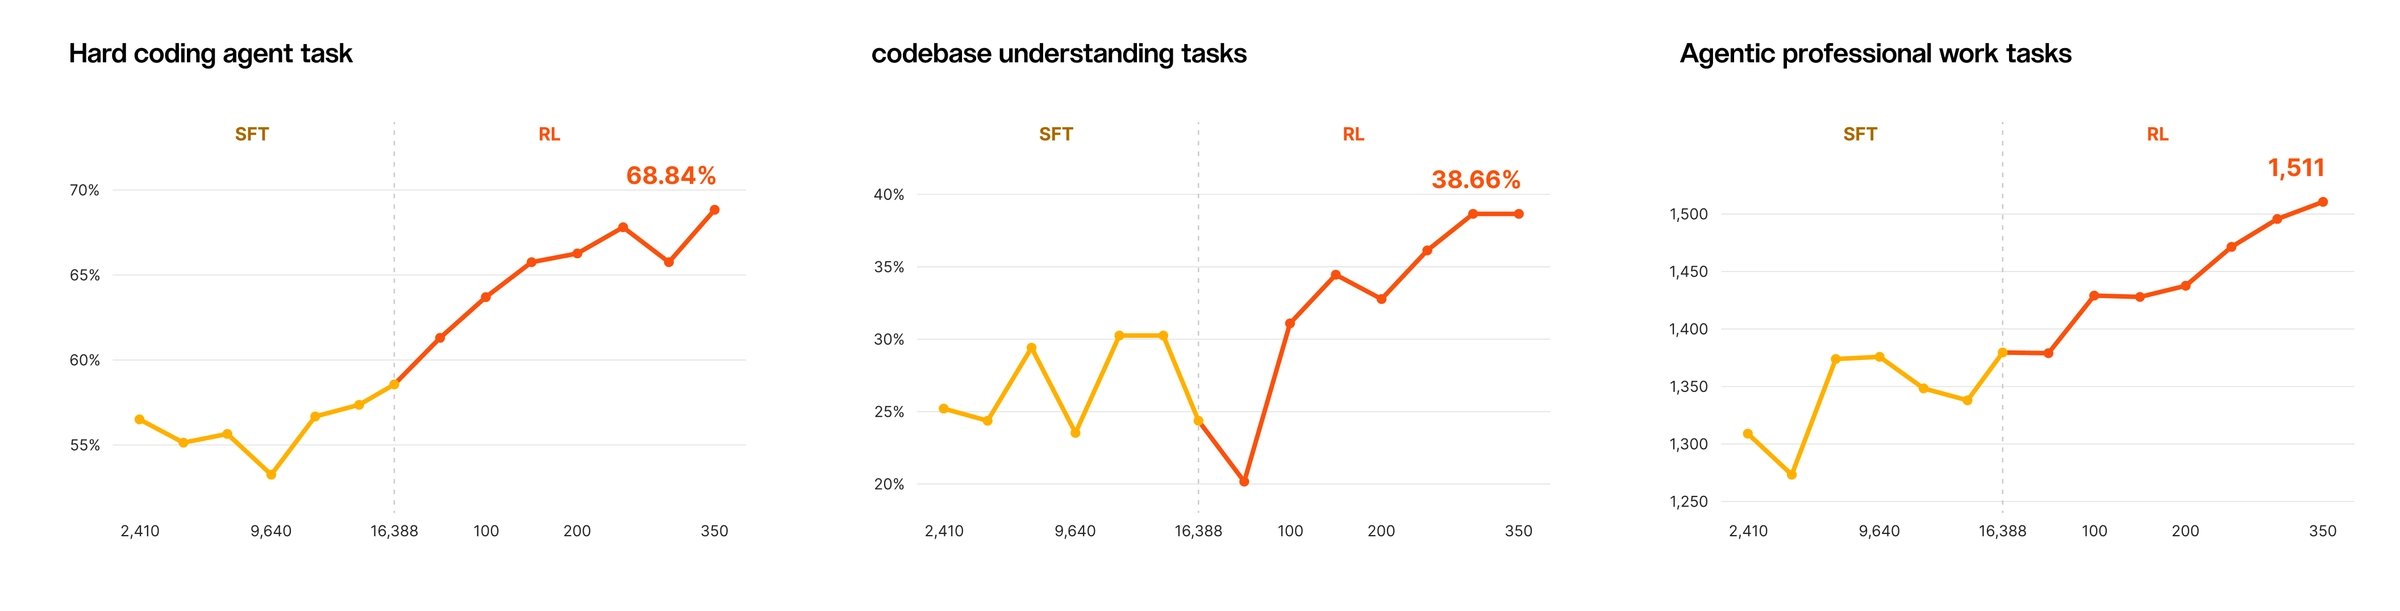
I miglioramenti non sono specifici degli ambienti su cui effettuiamo l'addestramento: si trasferiscono alle valutazioni a valle, e il modello finale li deve a entrambe le fasi di post-training (fine-tuning supervisionato e RL), come mostrato nei grafici.
I prossimi passi
Questo è solo l'inizio. ML4 è il primo traguardo della roadmap finanziata dal nostro round di serie D da 3 miliardi di euro, il più grande round di finanziamento in equity mai raccolto da un'azienda tecnologica europea. Quel capitale è già al lavoro: stiamo ampliando in modo significativo la capacità di calcolo nei nostri data center europei, e nei prossimi mesi ne entrerà in funzione molta altra.
Più capacità di calcolo significa più addestramento. L'esecuzione di apprendimento per rinforzo alla base di questa anteprima è ancora in corso e il modello non mostra segni di saturazione: resta un ampio margine di miglioramento. Man mano che aumentiamo l'addestramento sulla nostra infrastruttura ampliata, ci aspettiamo miglioramenti significativi e rapidi nelle prossime settimane e nei prossimi mesi.
Pubblicheremo i pesi entro la fine del mese, insieme a maggiori dettagli sull'architettura, ulteriori benchmark e la nostra metodologia di post-training. E ML4 è solo la base: servirà da fondamento per una nuova generazione di modelli Mistral specializzati e ottimizzati, pensati per i settori e i carichi di lavoro più importanti per i nostri clienti.
Da qui in avanti, il ritmo dei progressi sarà rapido. Segua i prossimi aggiornamenti.
Mistral Large 4
New
Open-weight hybrid instruct-and-reasoning MoE with multimodal input; unifies instruction, reasoning, and agentic capabilities in a single model, state-of-the-art among open weights on cybersecurity, finance, and manufacturing, natively fluent in 160+ languages.
Multimodale
Ragionamento
Codifica
Agentico
Cybersecurity
Input (/M tokens)
$1.36
Output (/M tokens)
$4.18