Le Chonk
Aujourd'hui, nous lançons une préversion publique de Mistral Large 4. Officieusement ML4, très officiellement : le Chonk. ML4 repousse les limites de la performance des modèles à poids ouverts. Vous pouvez dès aujourd'hui essayer l'API de préversion sur Mistral Studio. Les poids seront publiés à la fin du mois.
Performances de pointe
ML4 est un modèle nativement multimodal de 1 000 milliards de paramètres, doté de 52 milliards de paramètres actifs. C'est notre modèle le plus grand et le plus performant à ce jour, et il continue de s'améliorer rapidement à mesure que nous l'affinons.
Le modèle affiche des performances exceptionnelles en codage, en workflows agentiques et en compréhension multimodale. Il rivalise déjà avec les meilleurs modèles open source au monde, tout en surpassant largement tout modèle à poids ouverts développé aux États-Unis ou en Europe. Sur les charges de travail critiques en entreprise, notamment en cybersécurité, en finance et en droit, il représente selon nous l'état de l'art des modèles ouverts. Dans certains domaines, comme le grounding visuel, il va encore plus loin et surpasse même les modèles fermés de pointe.
Nous publierons les poids d'ici la fin du mois. D'ici là, nous soumettons le modèle à un red-teaming en conditions réelles aux côtés de leaders de la cybersécurité, de partenaires validés et d'autorités publiques, qui accéderont au même modèle avec une modération allégée et des capacités cyber étendues.



Forgé en Europe. Conçu pour la souveraineté de l'IA.
ML4 a été entraîné à partir de zéro sur 3 800 GPU NVIDIA Grace Blackwell dans nos propres datacenters en Europe. La préversion publique s'exécute sur cette même infrastructure. C'est une étape importante de notre investissement à long terme dans l'infrastructure, la recherche et le développement produit : des performances de pointe dans des secteurs critiques, livrées via des poids ouverts et conçues pour donner aux clients le contrôle sur leur IA.
C'est particulièrement important en cybersécurité, où les refus imposés par les fournisseurs peuvent bloquer des recherches légitimes sur les vulnérabilités et la réponse aux incidents, et où la perte d'accès à une capacité en pleine gestion d'incident peut elle-même devenir un risque de sécurité critique. ML4 associe des performances cyber de tout premier ordre à des poids ouverts et à la possibilité de déployer le modèle soi-même, offrant aux organisations à la fois la capacité et l'autonomie nécessaires pour mener des travaux de sécurité avancés selon leurs propres politiques.
Le modèle sera disponible dans plusieurs régions du monde, dont un déploiement européen opéré de bout en bout par Mistral, indépendamment d'autres fournisseurs de services numériques et dans le cadre du droit européen. À noter : une part importante des données d'entraînement de ML4 était multilingue, couvrant plus de 160 langues, dont toutes les langues officielles de l'Union européenne.
Nous travaillons en étroite collaboration avec des entreprises de premier plan du monde entier — en finance, en ingénierie, en production industrielle, en logistique, dans l'industrie pharmaceutique, dans les sciences, dans le transport maritime, dans le secteur public et dans d'autres industries critiques — pour entraîner ML4. De fait, le modèle utilise le même environnement d'entraînement, de personnalisation et de RL que celui que nous proposons à nos clients via Mistral Forge.
Essayez-le dès aujourd'hui
Ce n'est pas tout. Tandis que nous préparons la publication des poids, nous partagerons de plus amples détails sur l'architecture du modèle, de nouveaux benchmarks et notre méthodologie de post-entraînement.
Ce modèle servira également de socle à une nouvelle génération de modèles Mistral spécialisés et optimisés. En attendant, nous vous invitons à essayer l'API de préversion et à partager vos retours avec nous sur les réseaux sociaux.
Fonctionnalités en détail
Cybersécurité
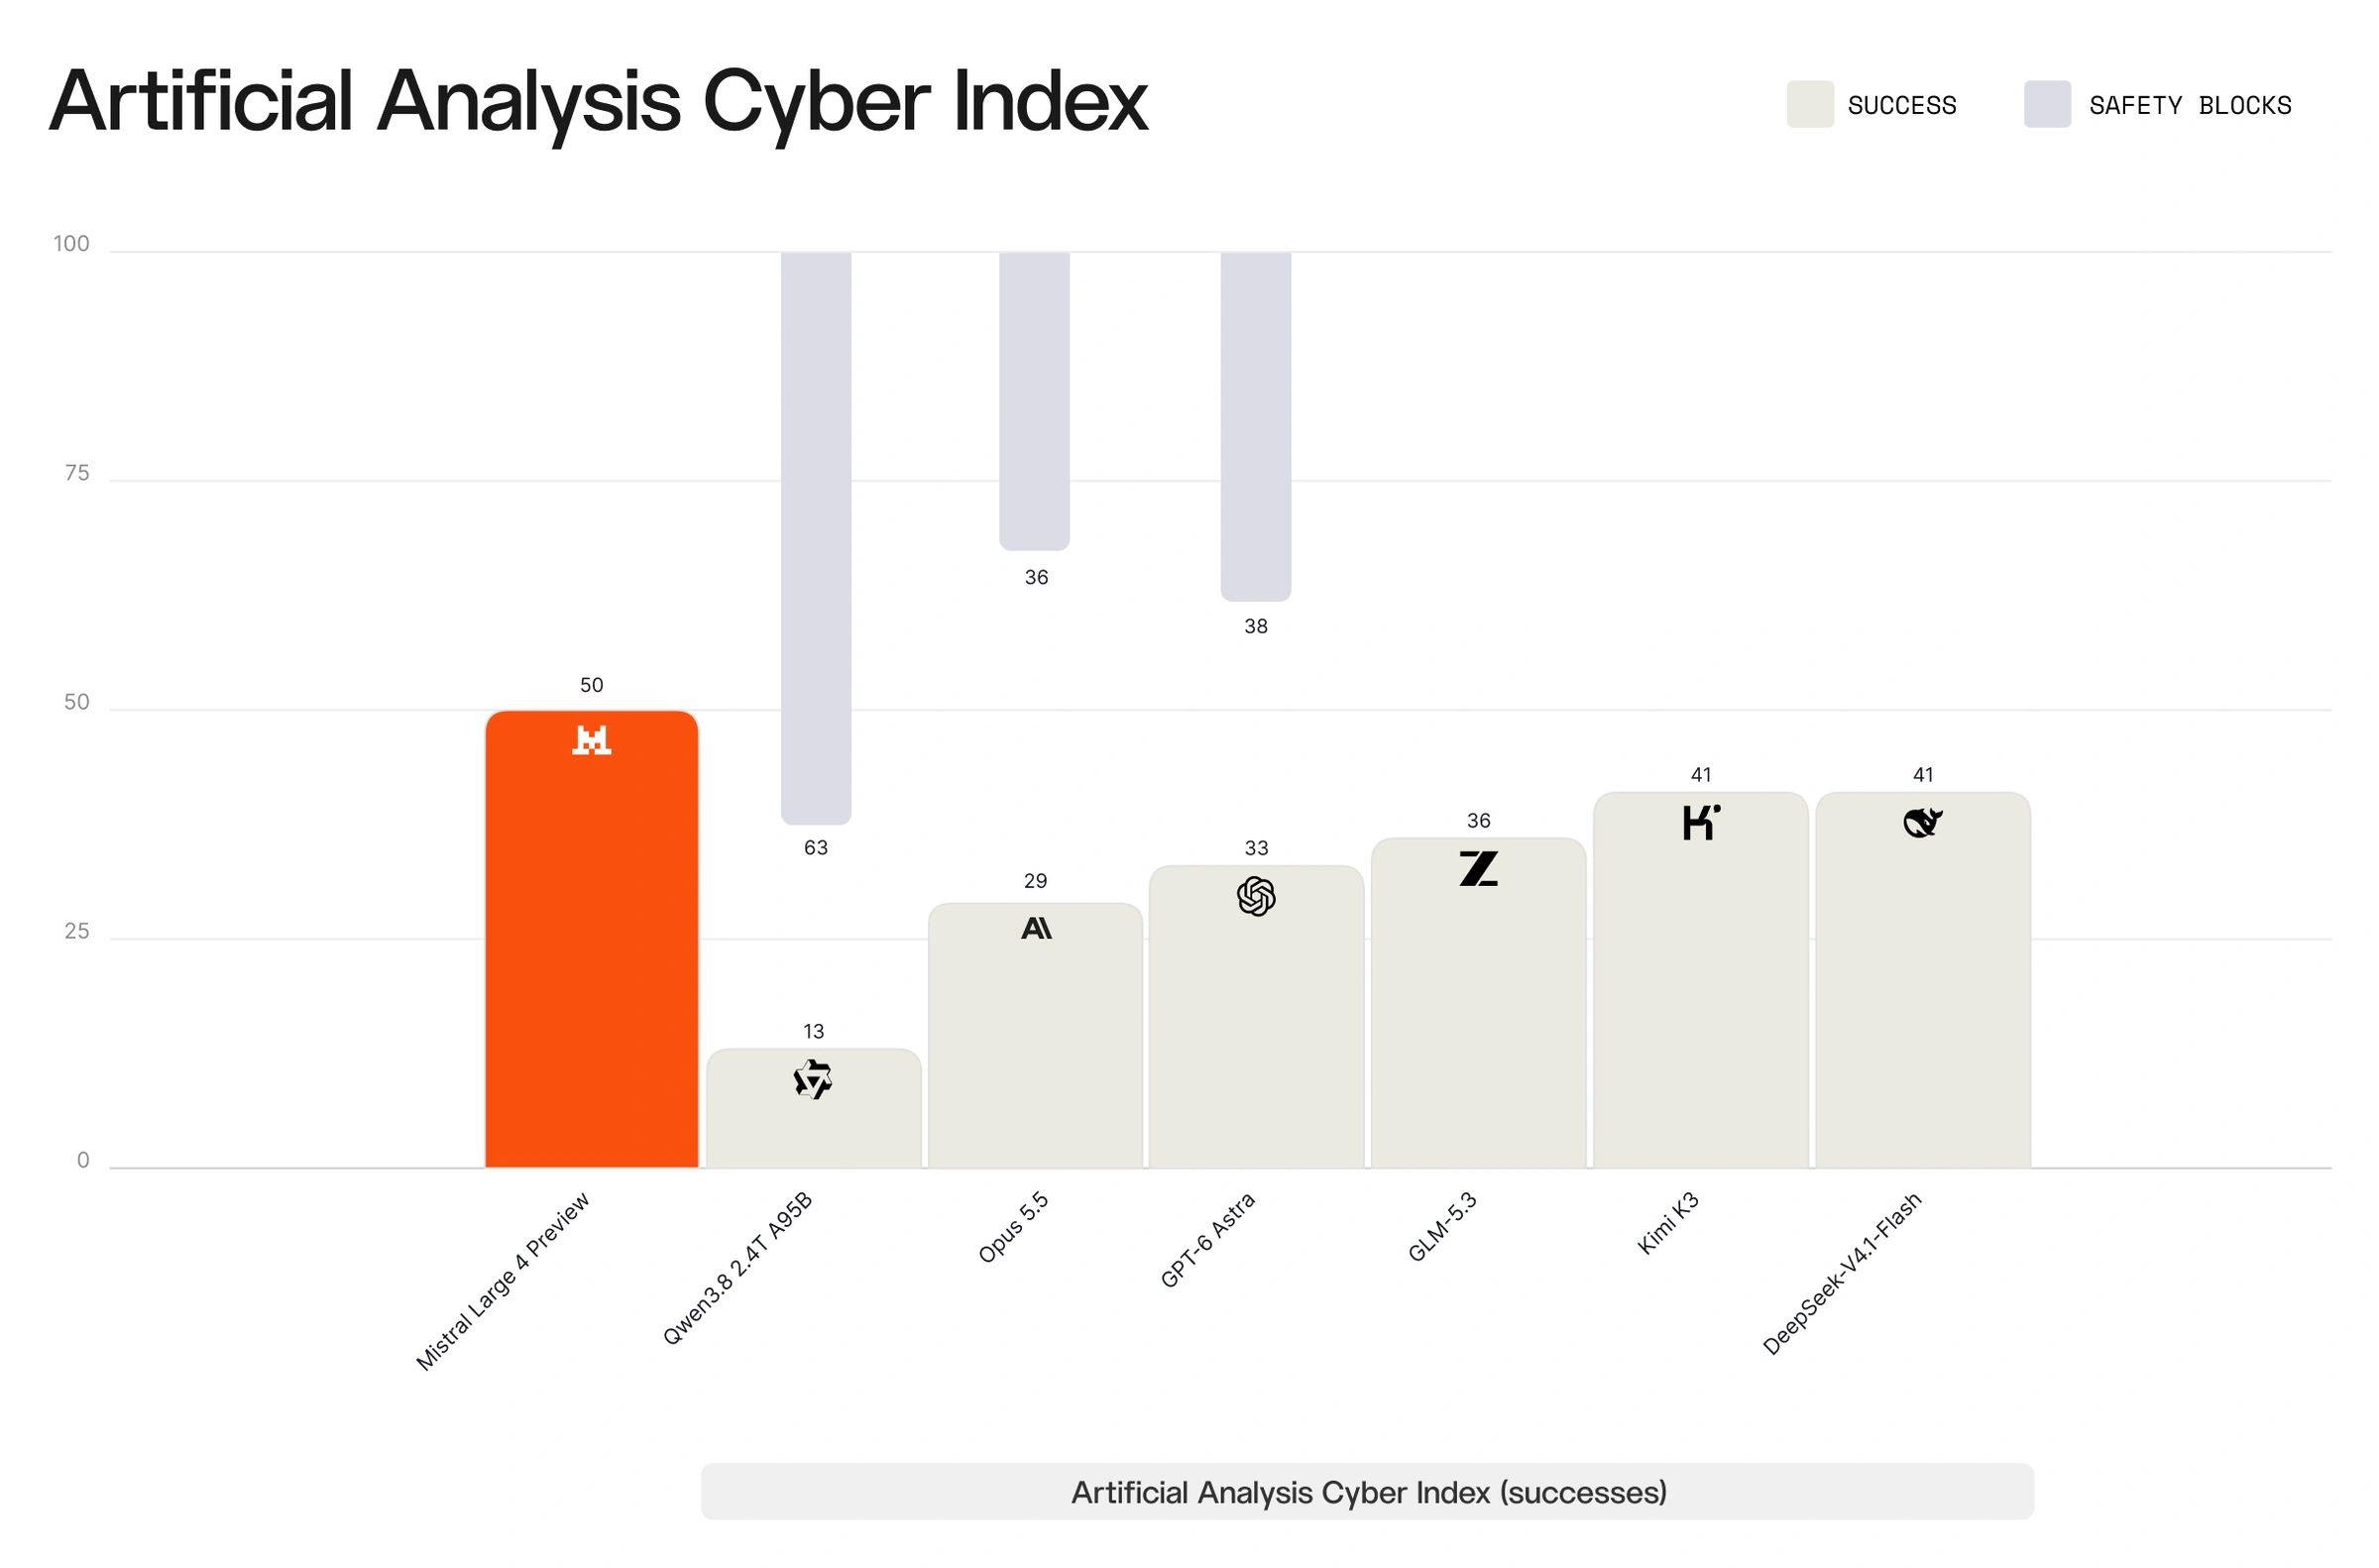
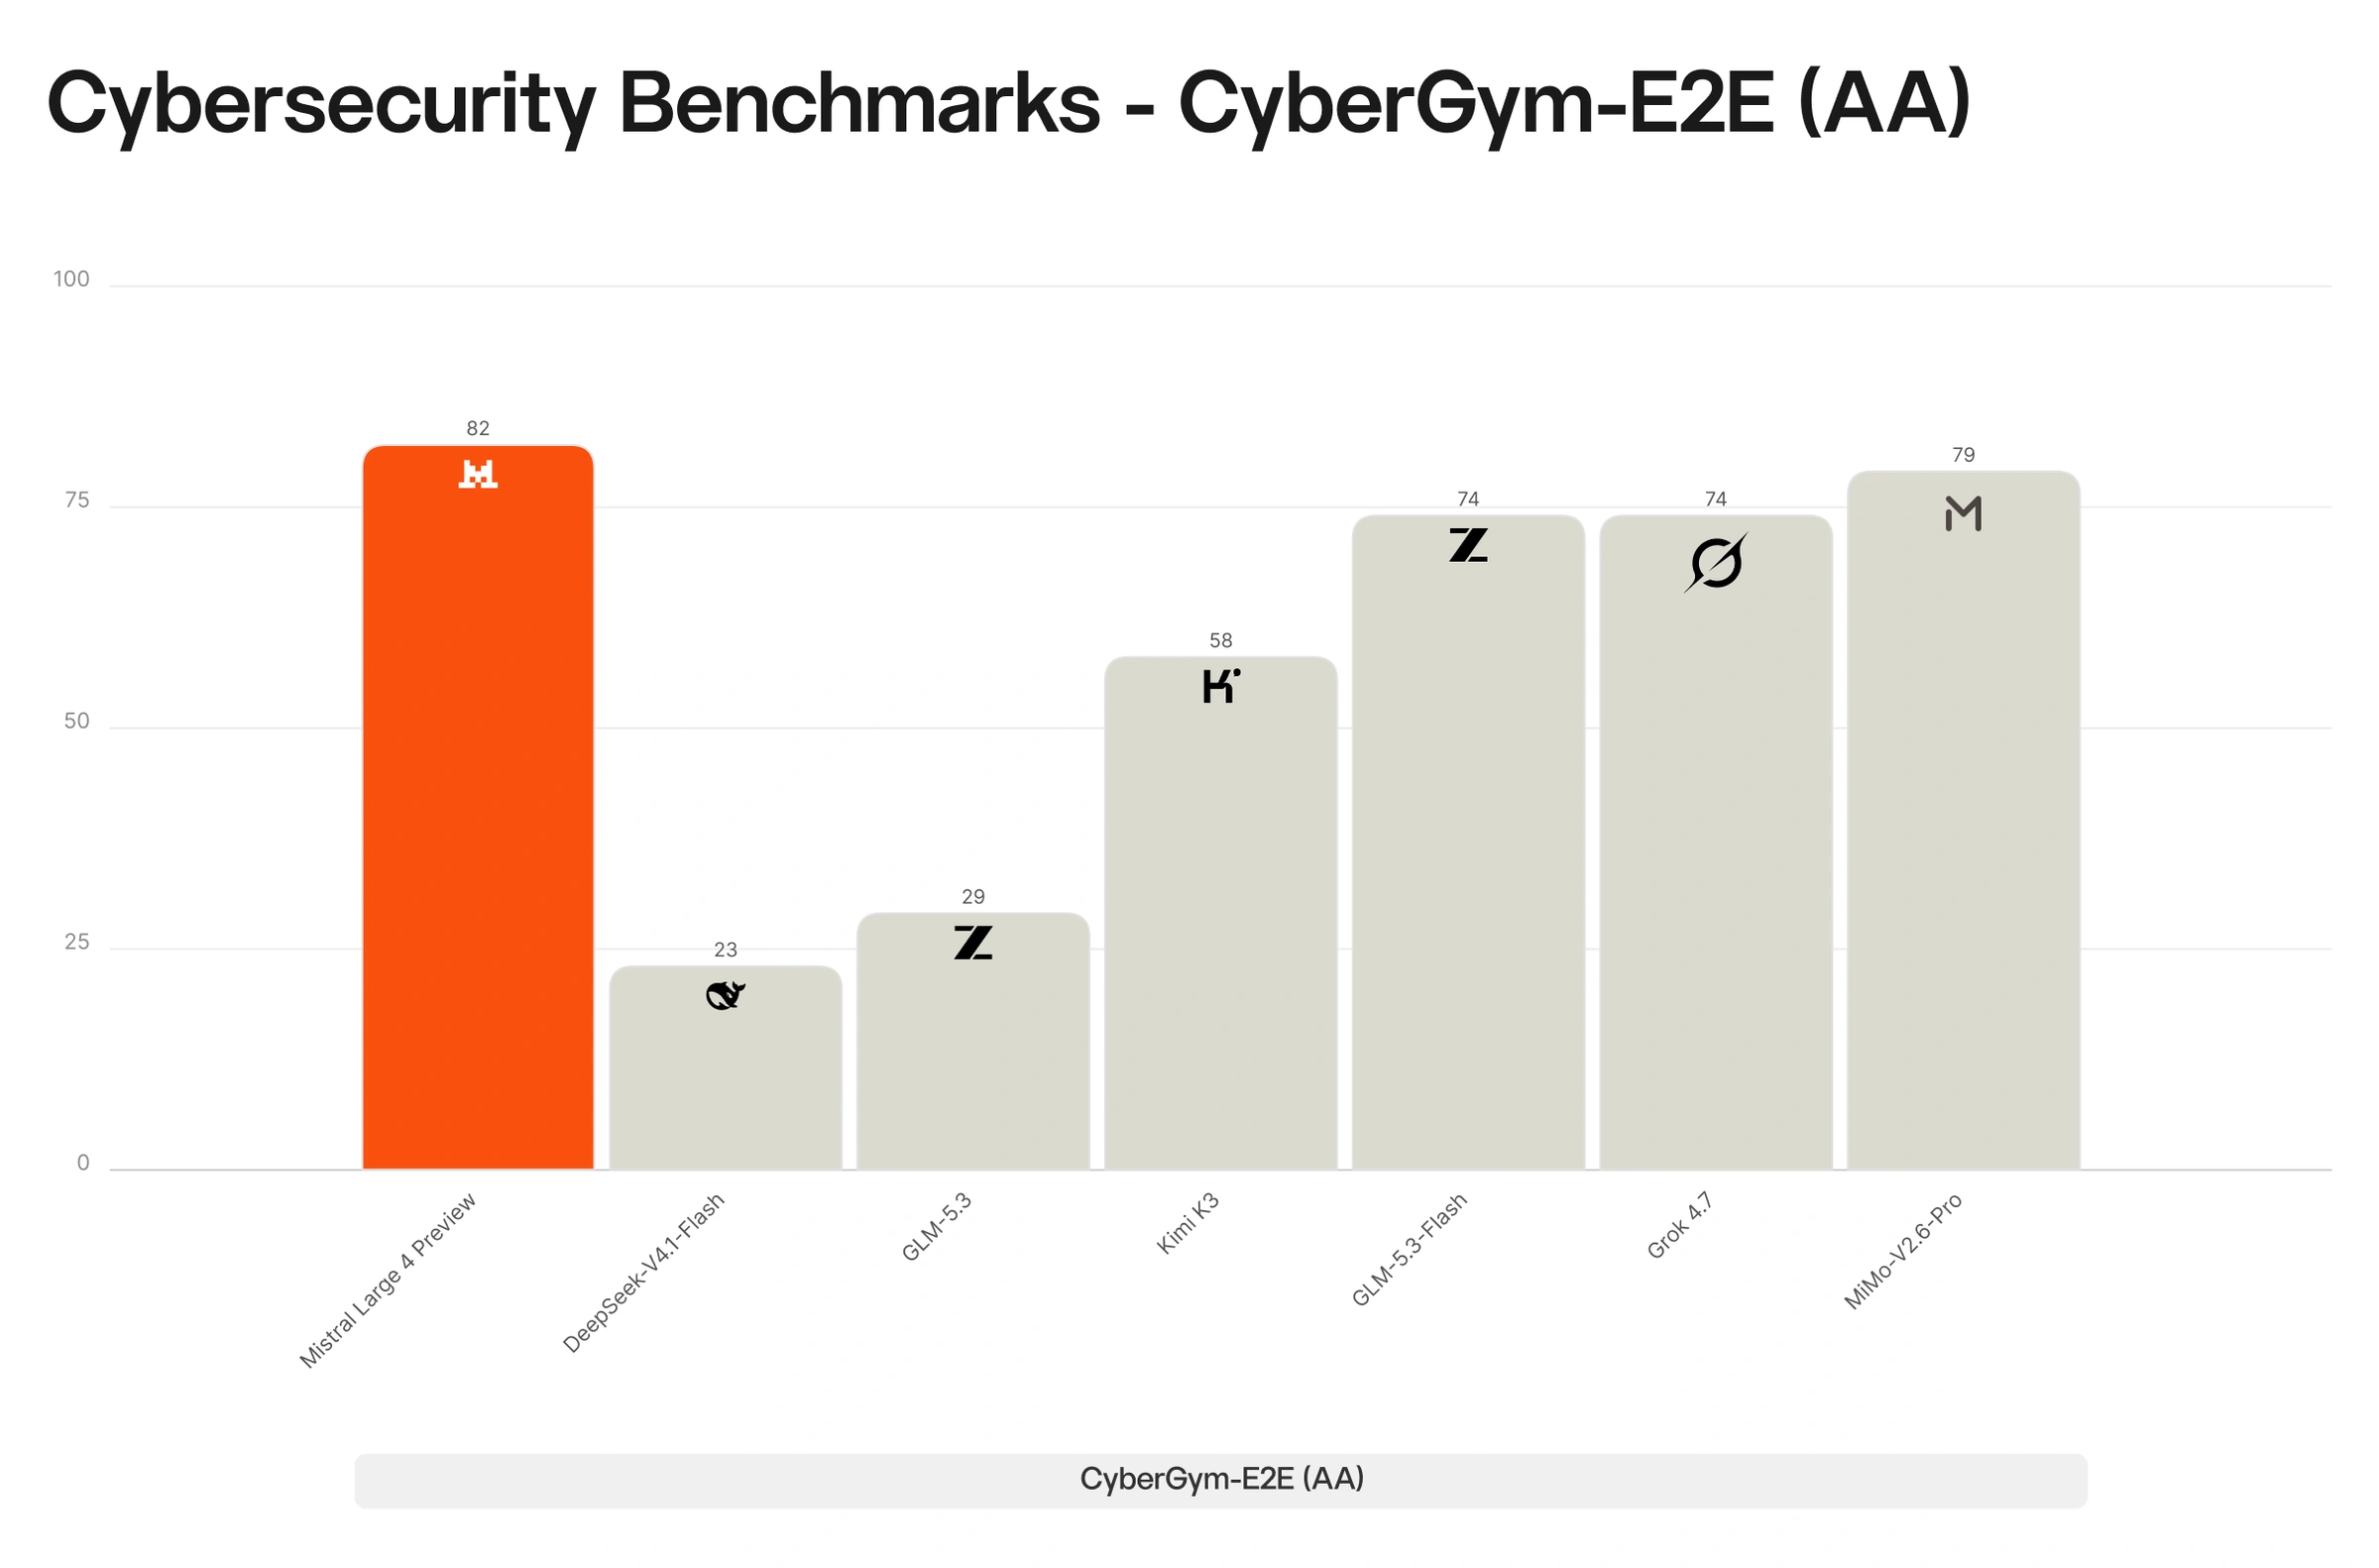
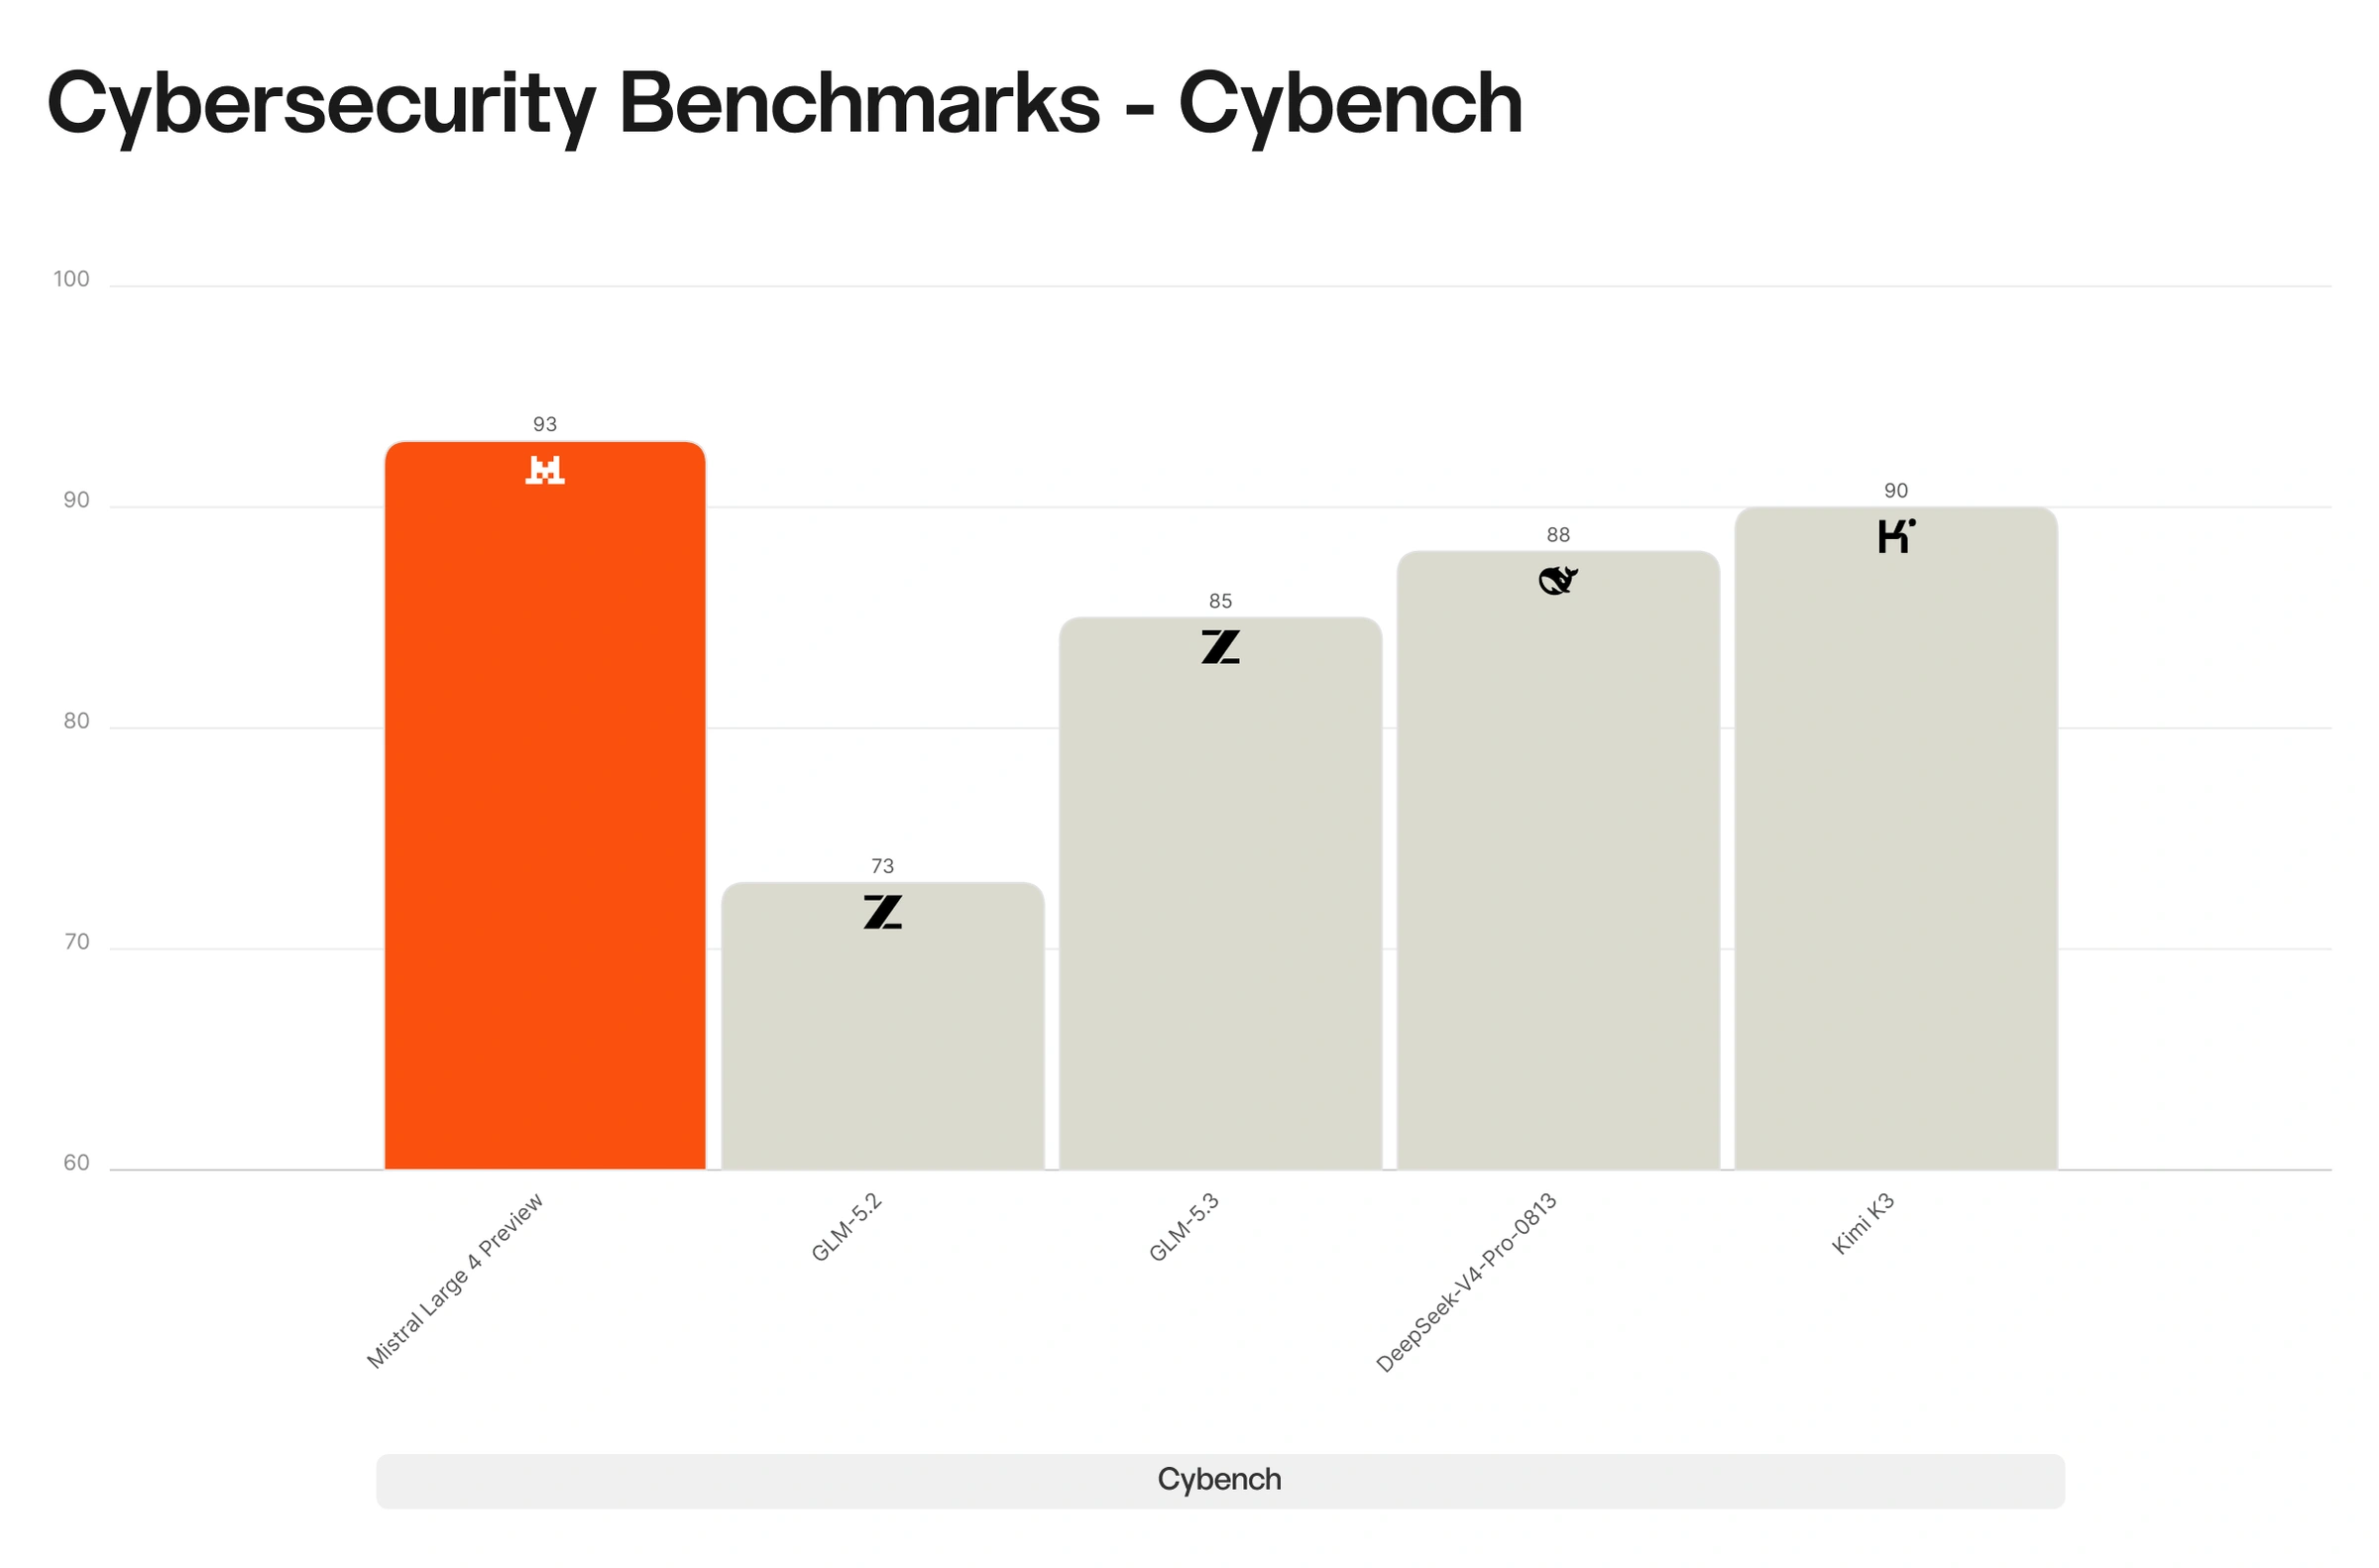
ML4 est l'un des modèles d'IA les plus puissants au monde en matière de cybersécurité. Sur l'Artificial Analysis Cyber Index, une évaluation indépendante qui mesure la capacité des modèles d'IA à trouver et corriger des failles de sécurité dans des logiciels réels, il figure parmi les cinq meilleurs modèles au monde et devance très largement les modèles à poids ouverts développés hors de Chine. Sur l'un des tests de cet index, qui demande au modèle de reproduire une véritable vulnérabilité dans un logiciel open source puis de la corriger, ML4 obtient 82 %, le score le plus élevé de tous les modèles. Il résout également 93 % des défis de Cybench, un ensemble de 40 exercices issus de compétitions de sécurité, soit l'un des meilleurs scores rapportés pour un modèle à poids ouverts.
Ce meilleur score reflète un avantage concret. Plusieurs modèles fermés de premier plan, dont Claude Opus 5.5 et GPT-6 Astra, obtiennent un score proche de zéro sur ce même test, car ils refusent d'effectuer la tâche. Or, la défense des logiciels commence souvent par prouver qu'une faille est réelle — précisément le type de travail que les filtres de sécurité des modèles fermés peuvent bloquer. L'enjeu est d'autant plus important que des acteurs malveillants parviennent de plus en plus à jailbreaker ces mêmes modèles pour appuyer des activités cyber offensives : les défenseurs ont besoin de systèmes capables d'égaler ces capacités sans être freinés par les mêmes refus. ML4 sait faire ce travail, et ses capacités vont au-delà de ce pour quoi il a été explicitement entraîné : lors de tests internes, il s'est montré utile pour analyser des malwares, prioriser des vulnérabilités et rédiger des règles de détection. Pour les organisations qui ont besoin d'une IA souveraine et auditable pour leurs opérations de sécurité, il pourra être déployé sur un cloud privé ou on-premise.
ML4 face à la concurrence : un raisonnement efficace sur des défis complexes et variés
Rétro-ingénierie de malwares : résolution d'une tâche d'investigation hors distribution
Codage agentique
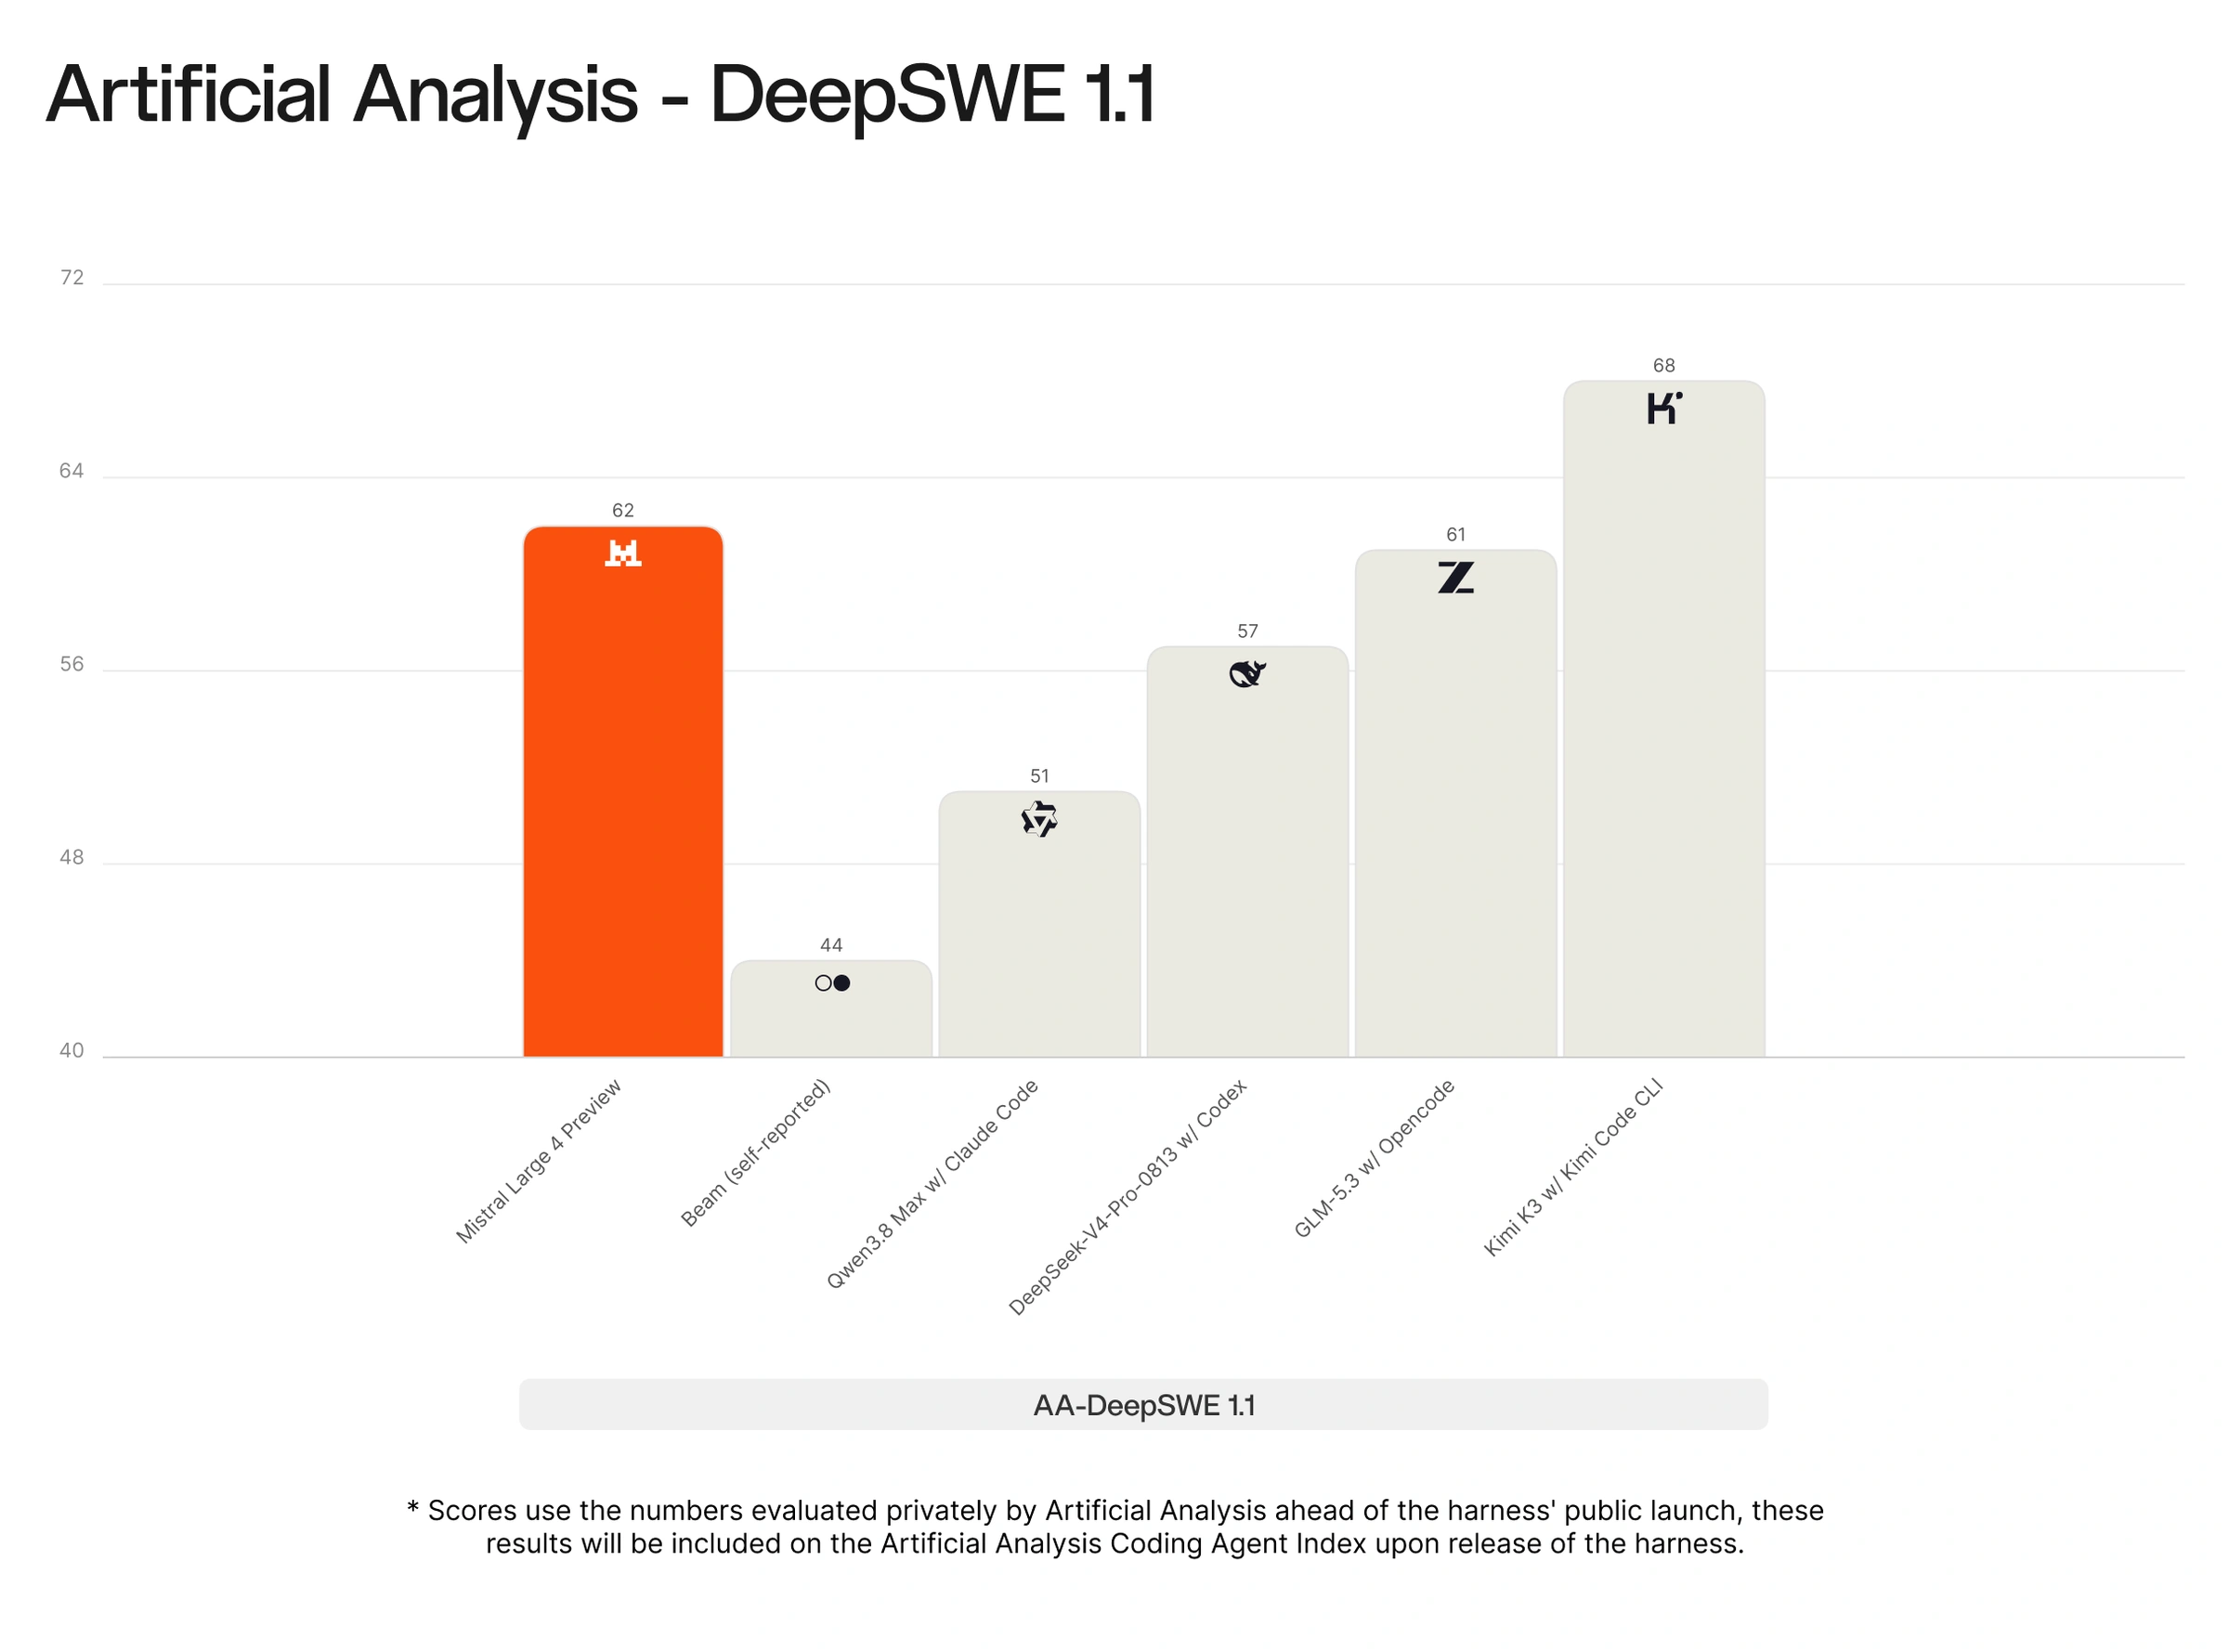
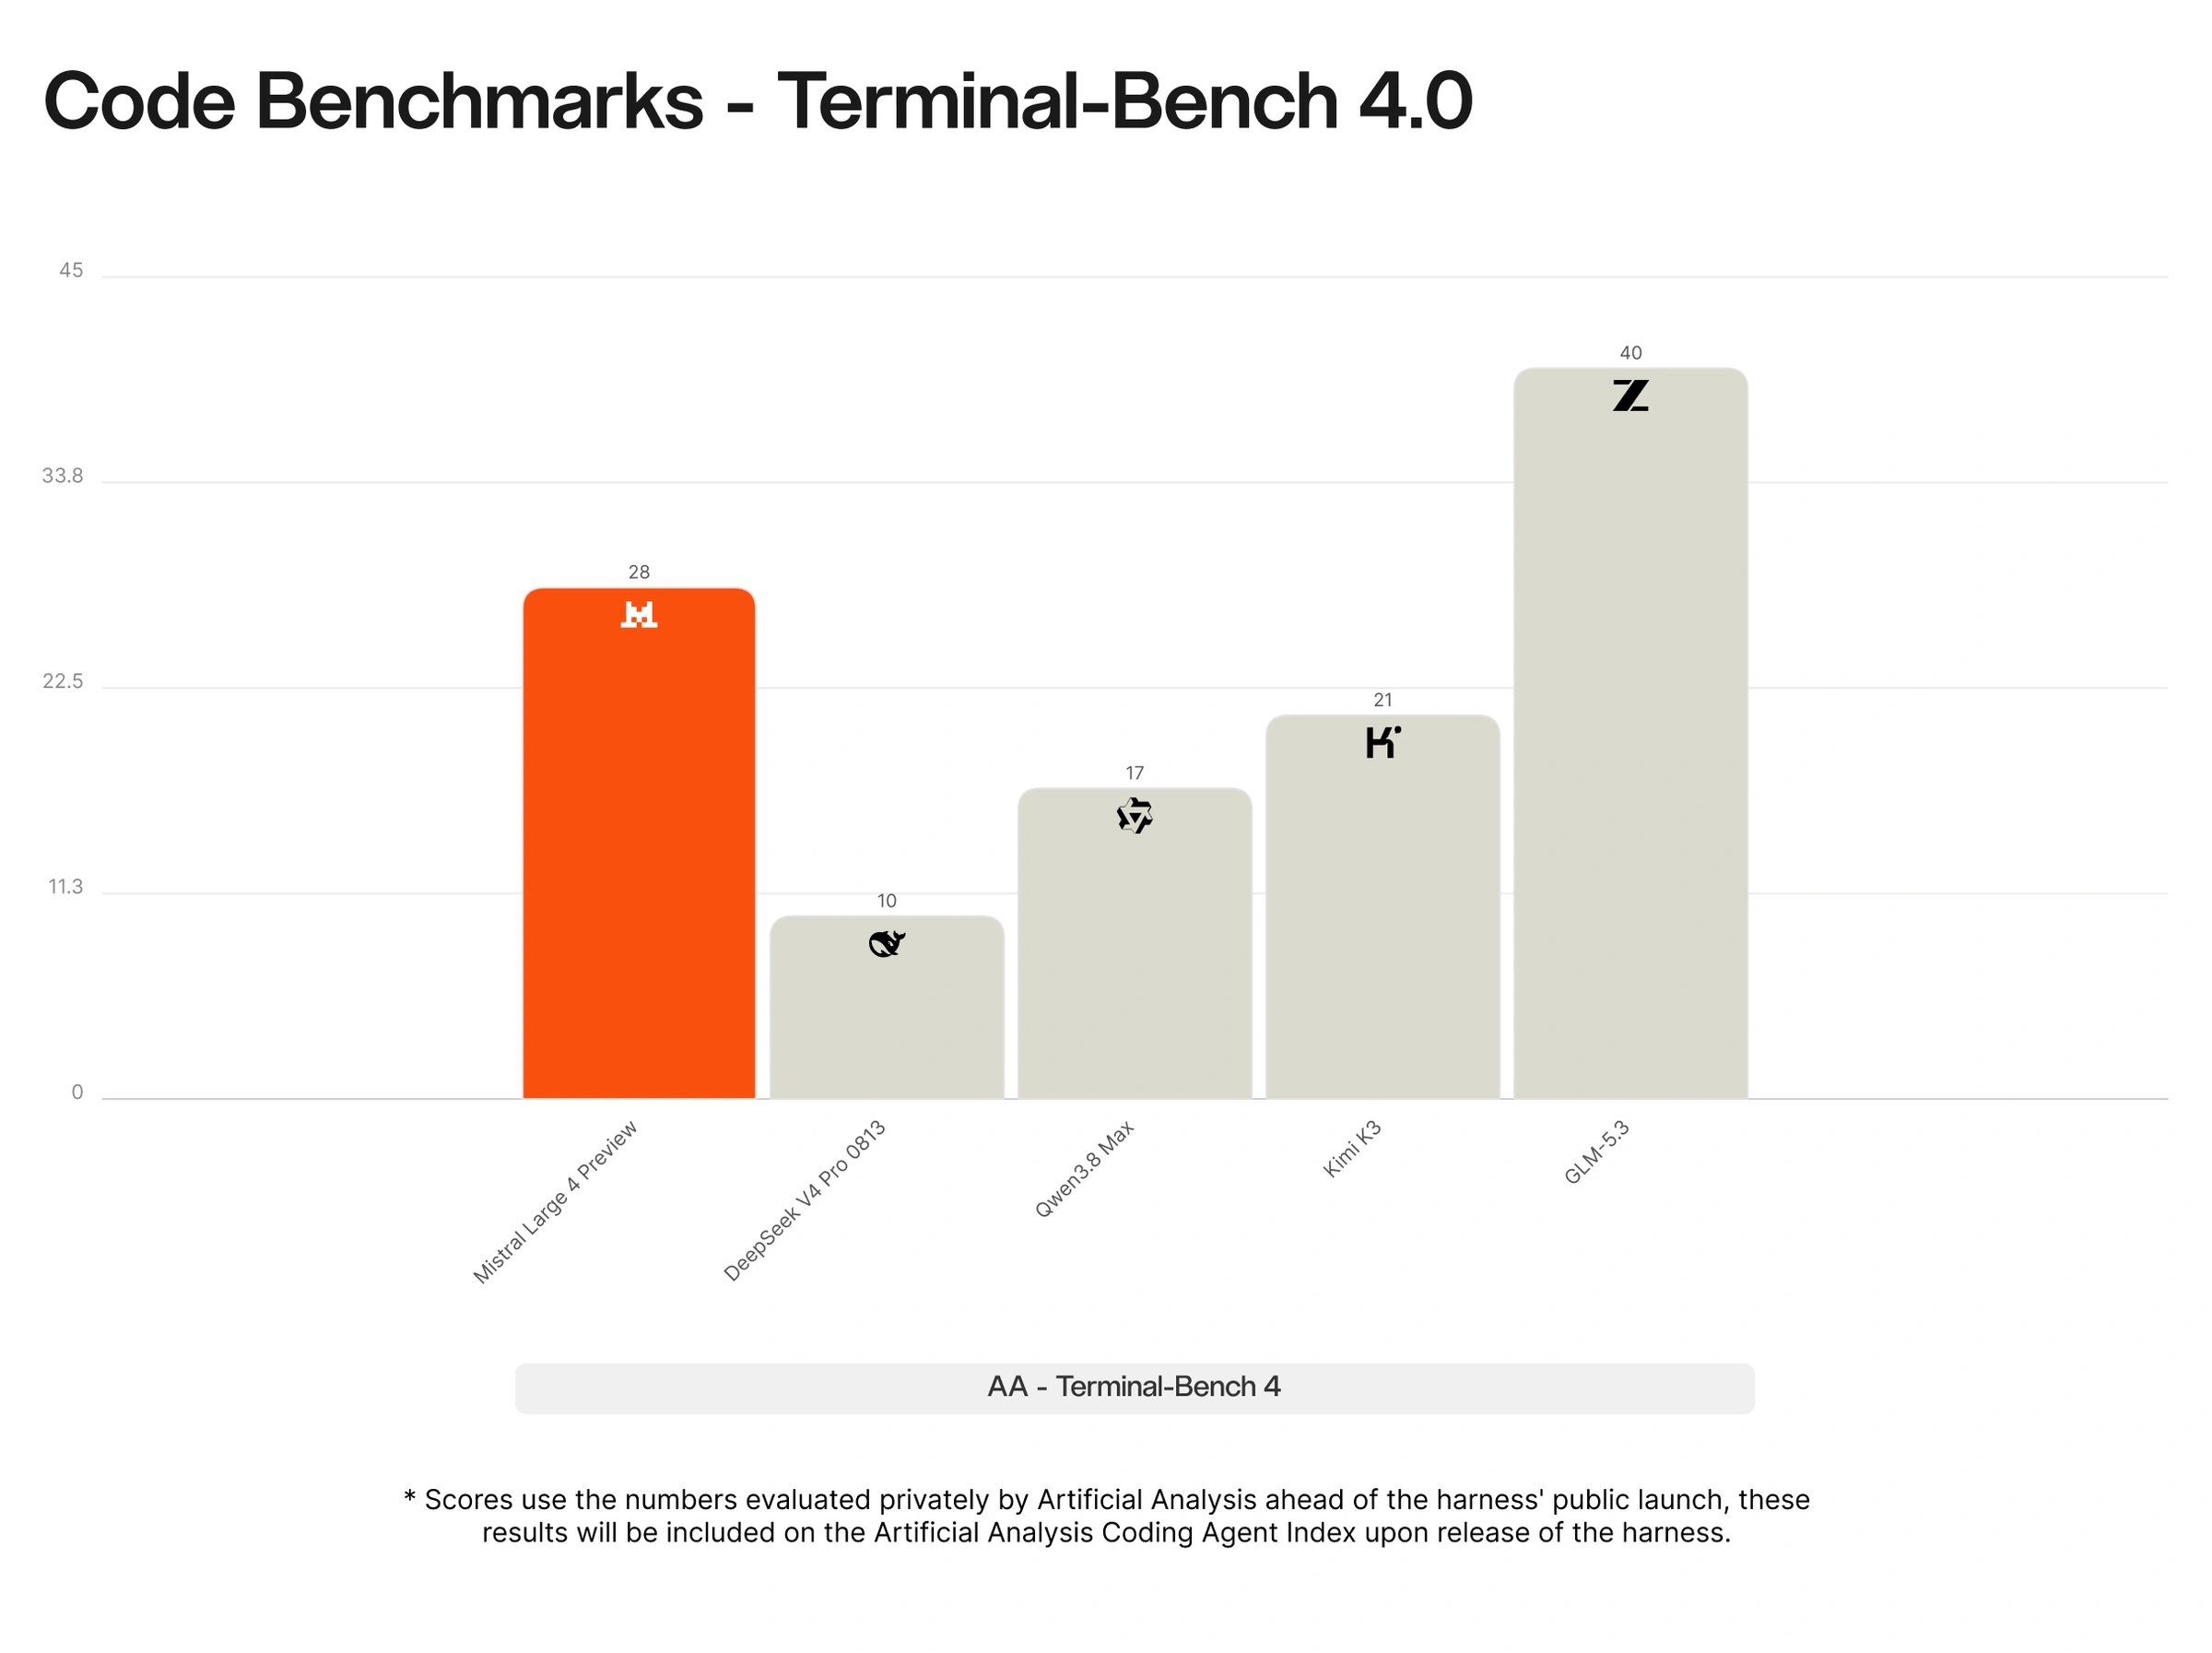
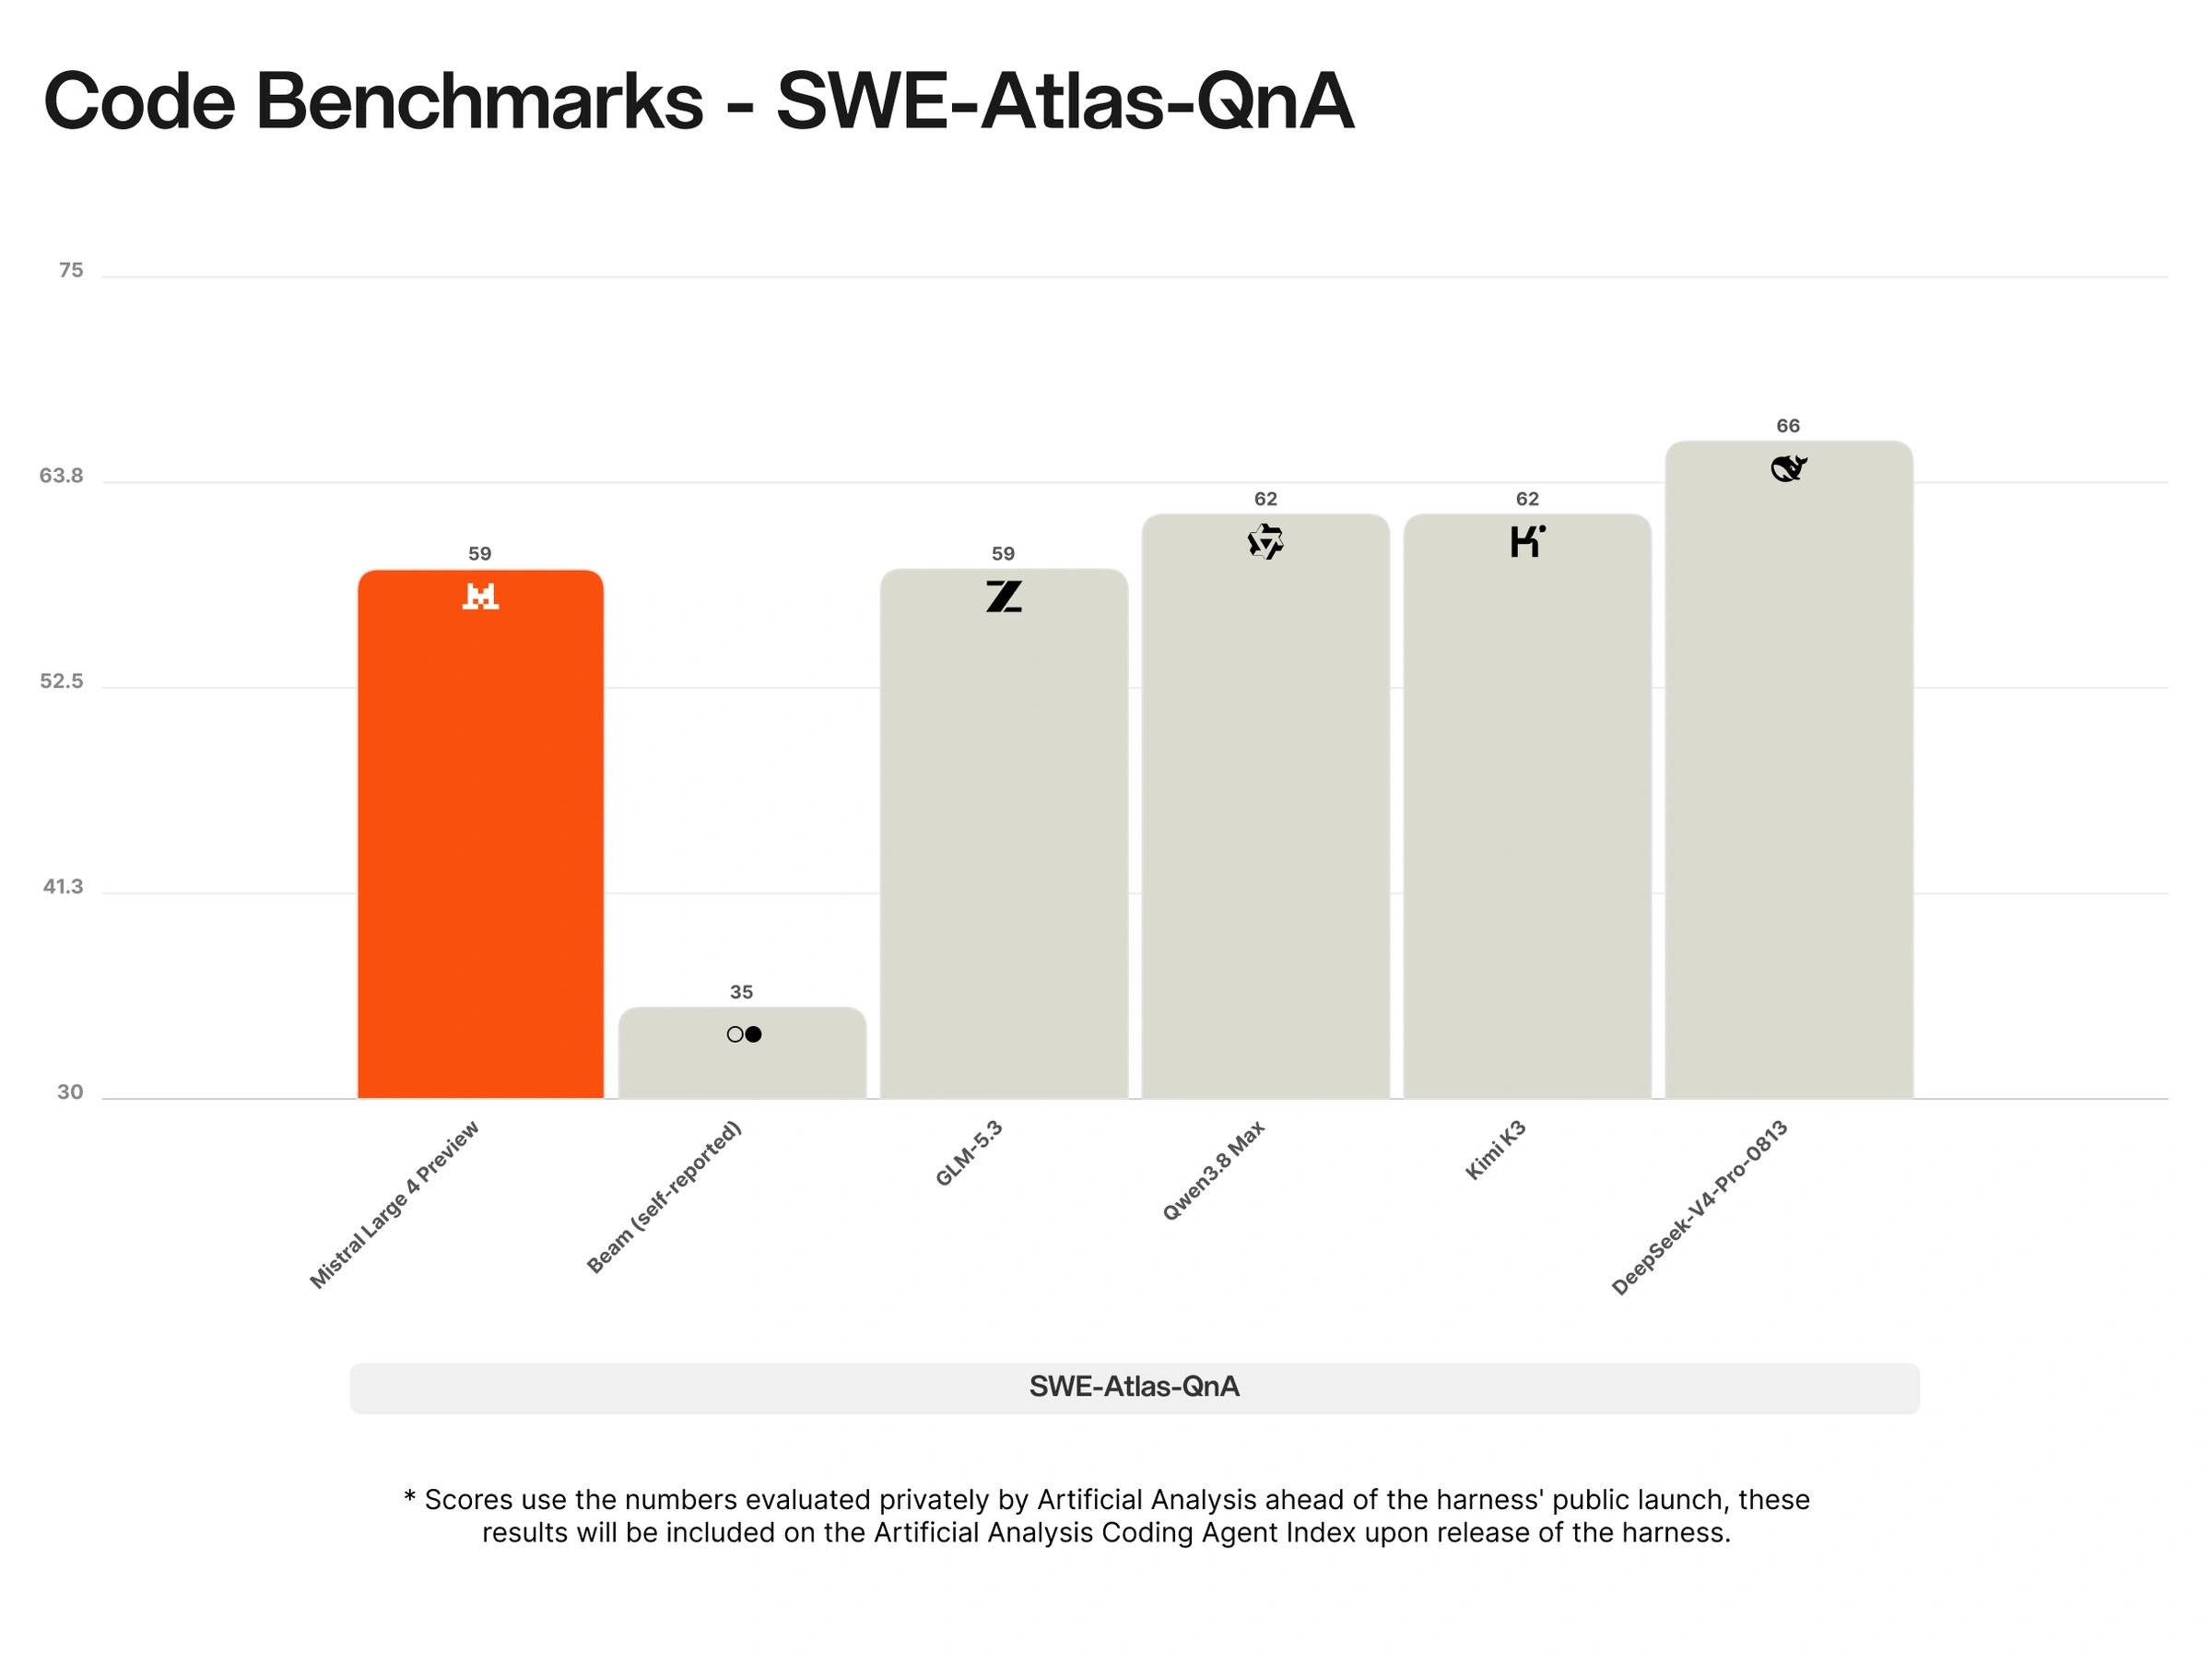
ML4 excelle en ingénierie logicielle, en compréhension de dépôts et dans les workflows complexes en terminal, avec 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4. Son score combiné de 49,8 % au Coding Agent Index le place devant DeepSeek V4 Pro 0813 et Qwen3.8 Max.
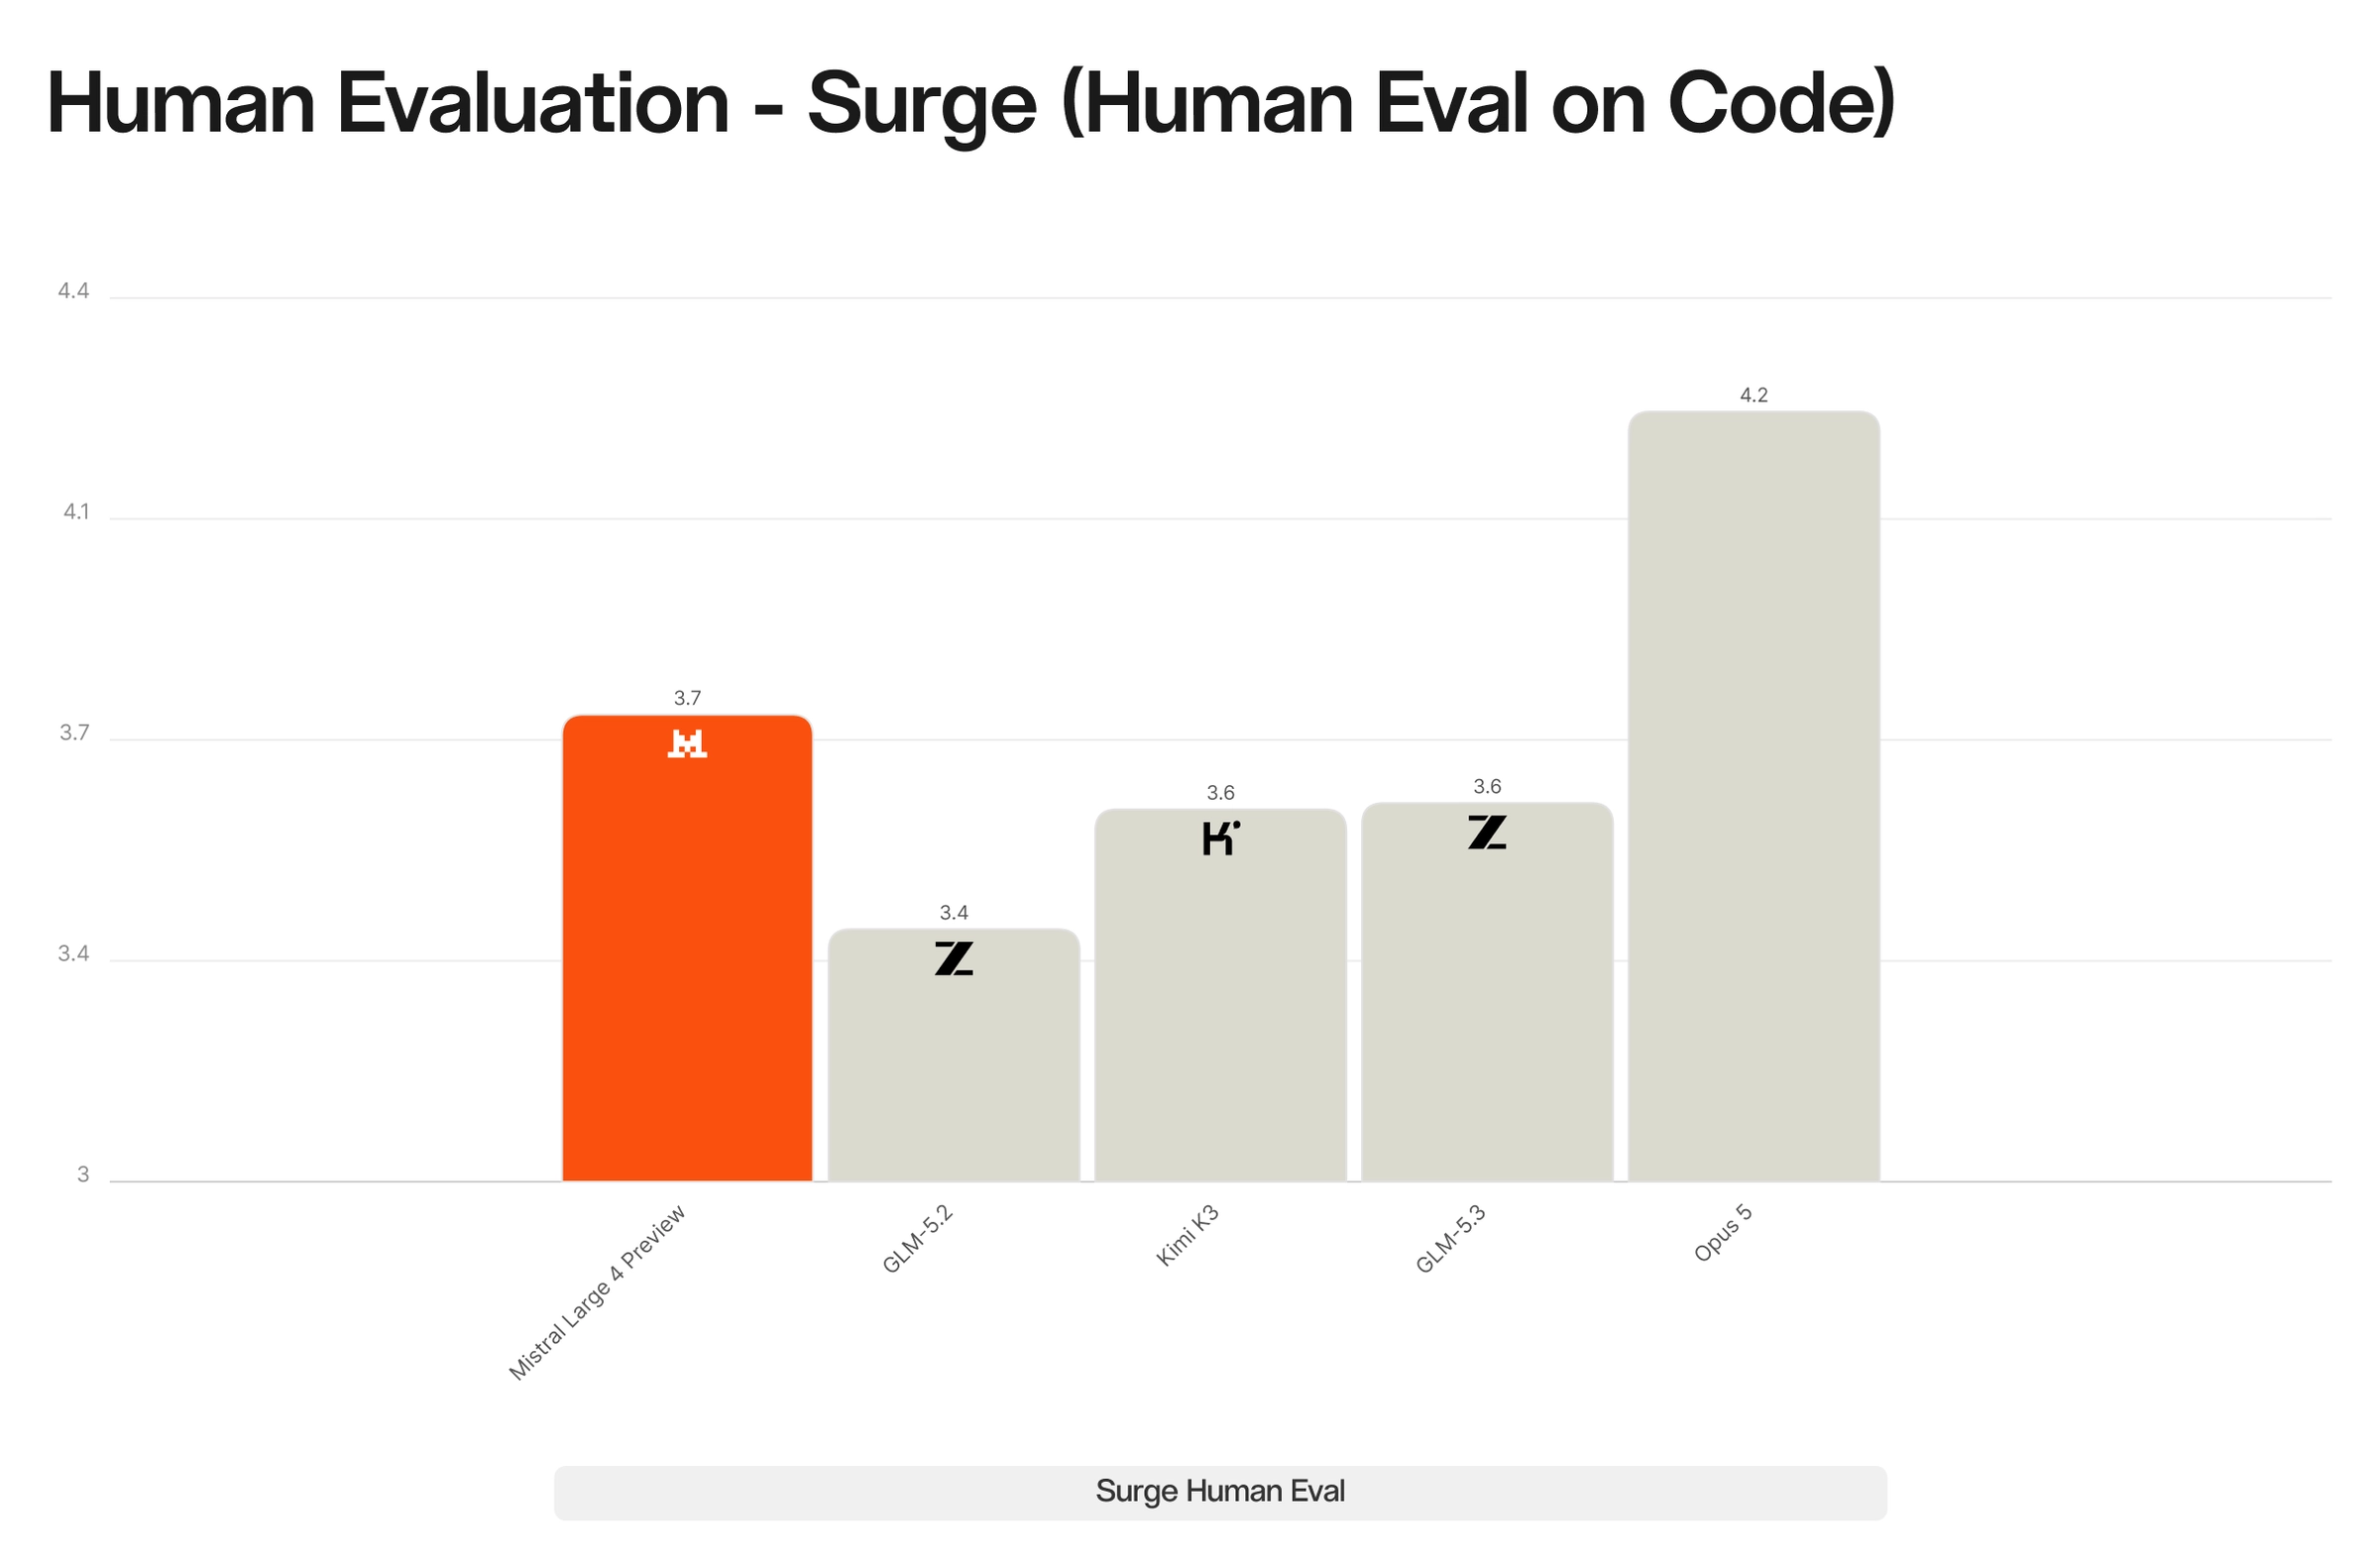
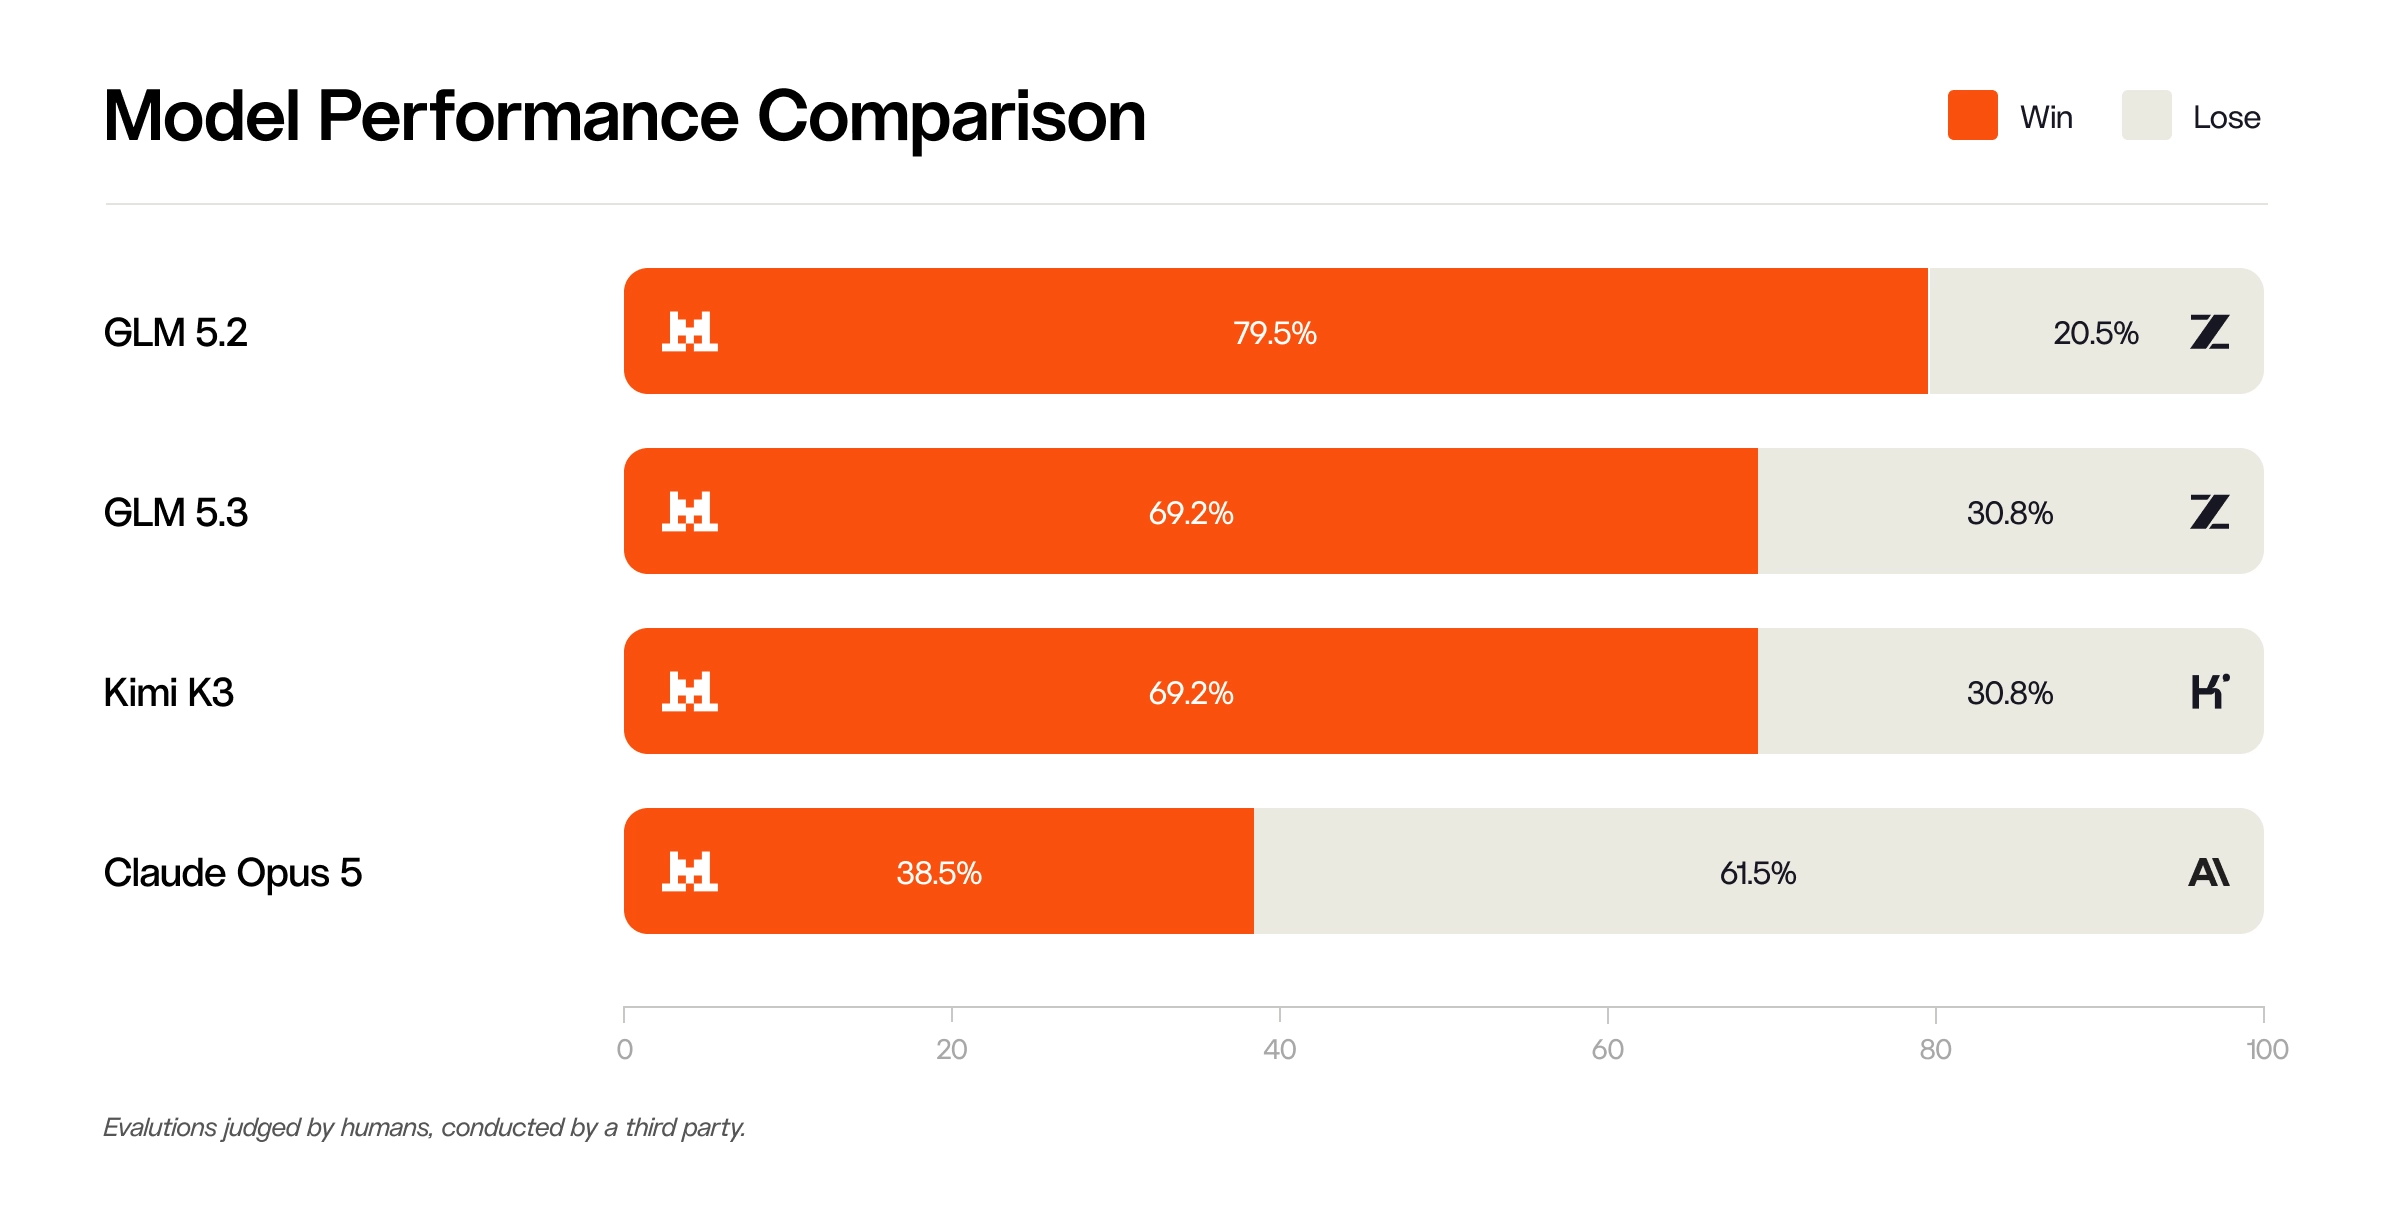
Nous avons également mené, avec Surge AI, une évaluation humaine en aveugle sur la qualité du code : des annotateurs professionnels ont noté les sorties des modèles sur une échelle de 1 à 5, sans connaître l'identité des modèles. ML4 Preview se classe deuxième sur cinq modèles (3,74), devant Kimi K3 (3,59), GLM-5.3 (3,60) et GLM-5.2 (3,40), et seul Claude Opus 5 (4,22) le devance.
Workflows agentiques
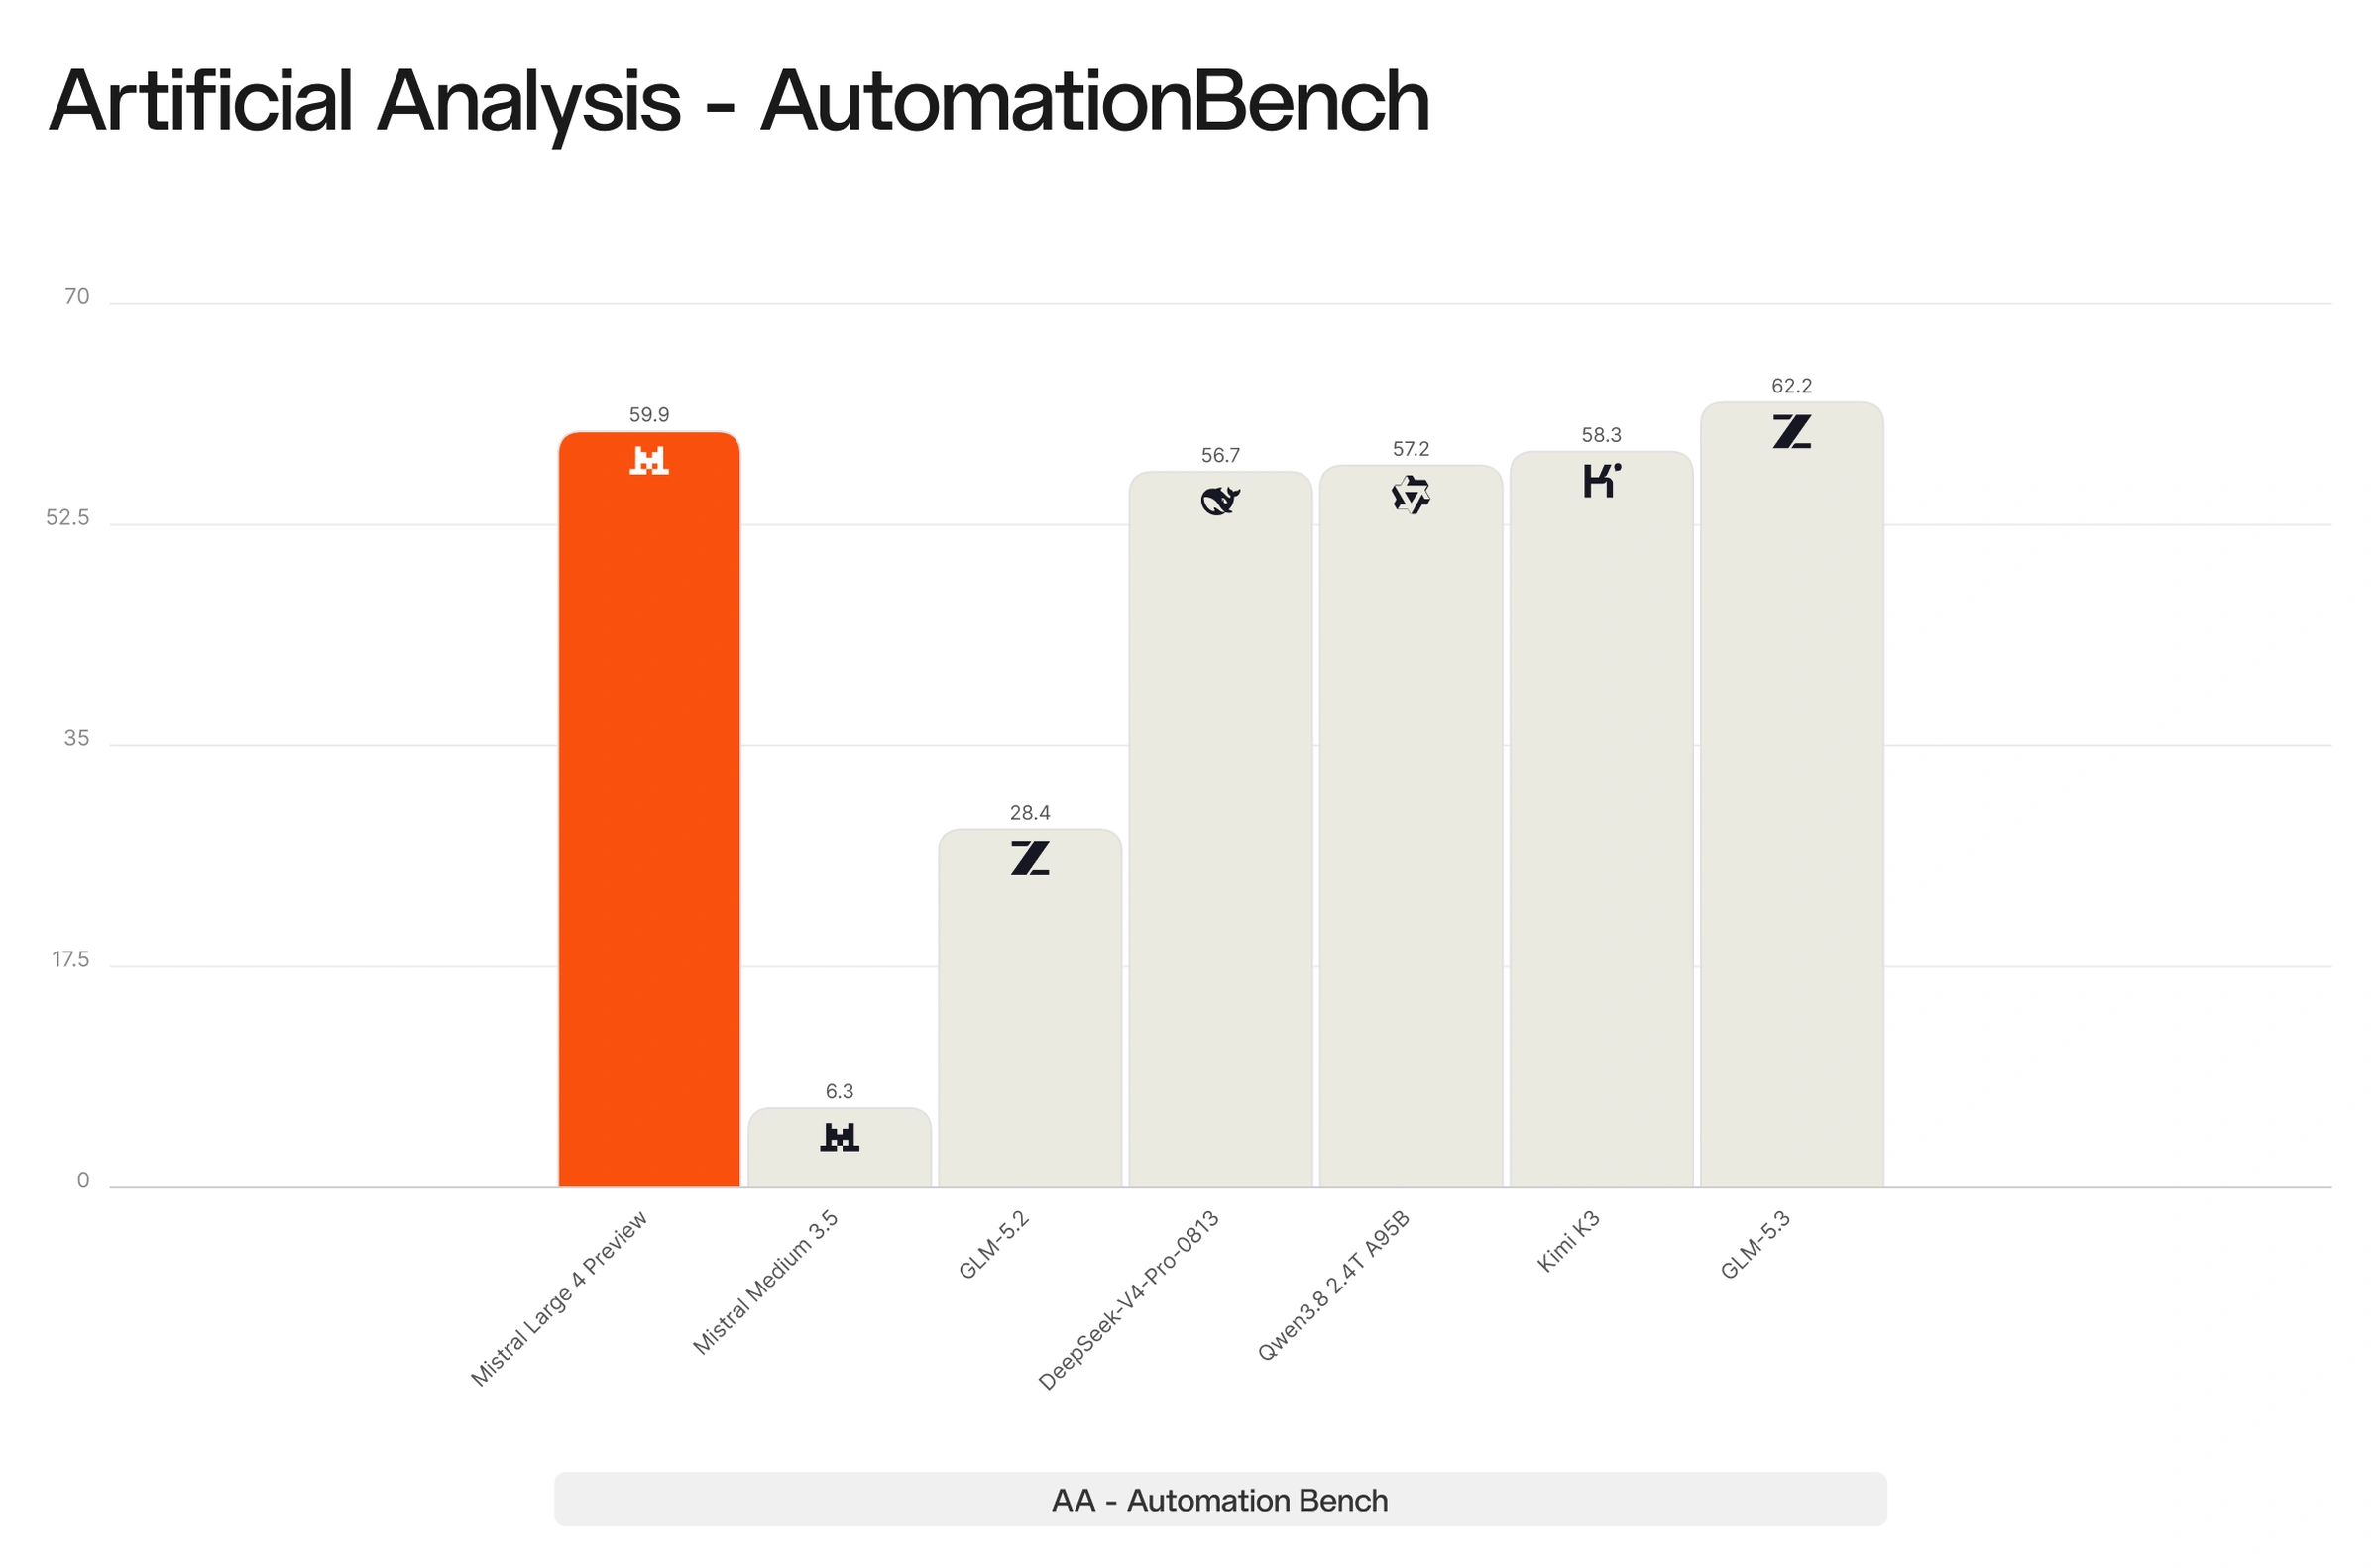
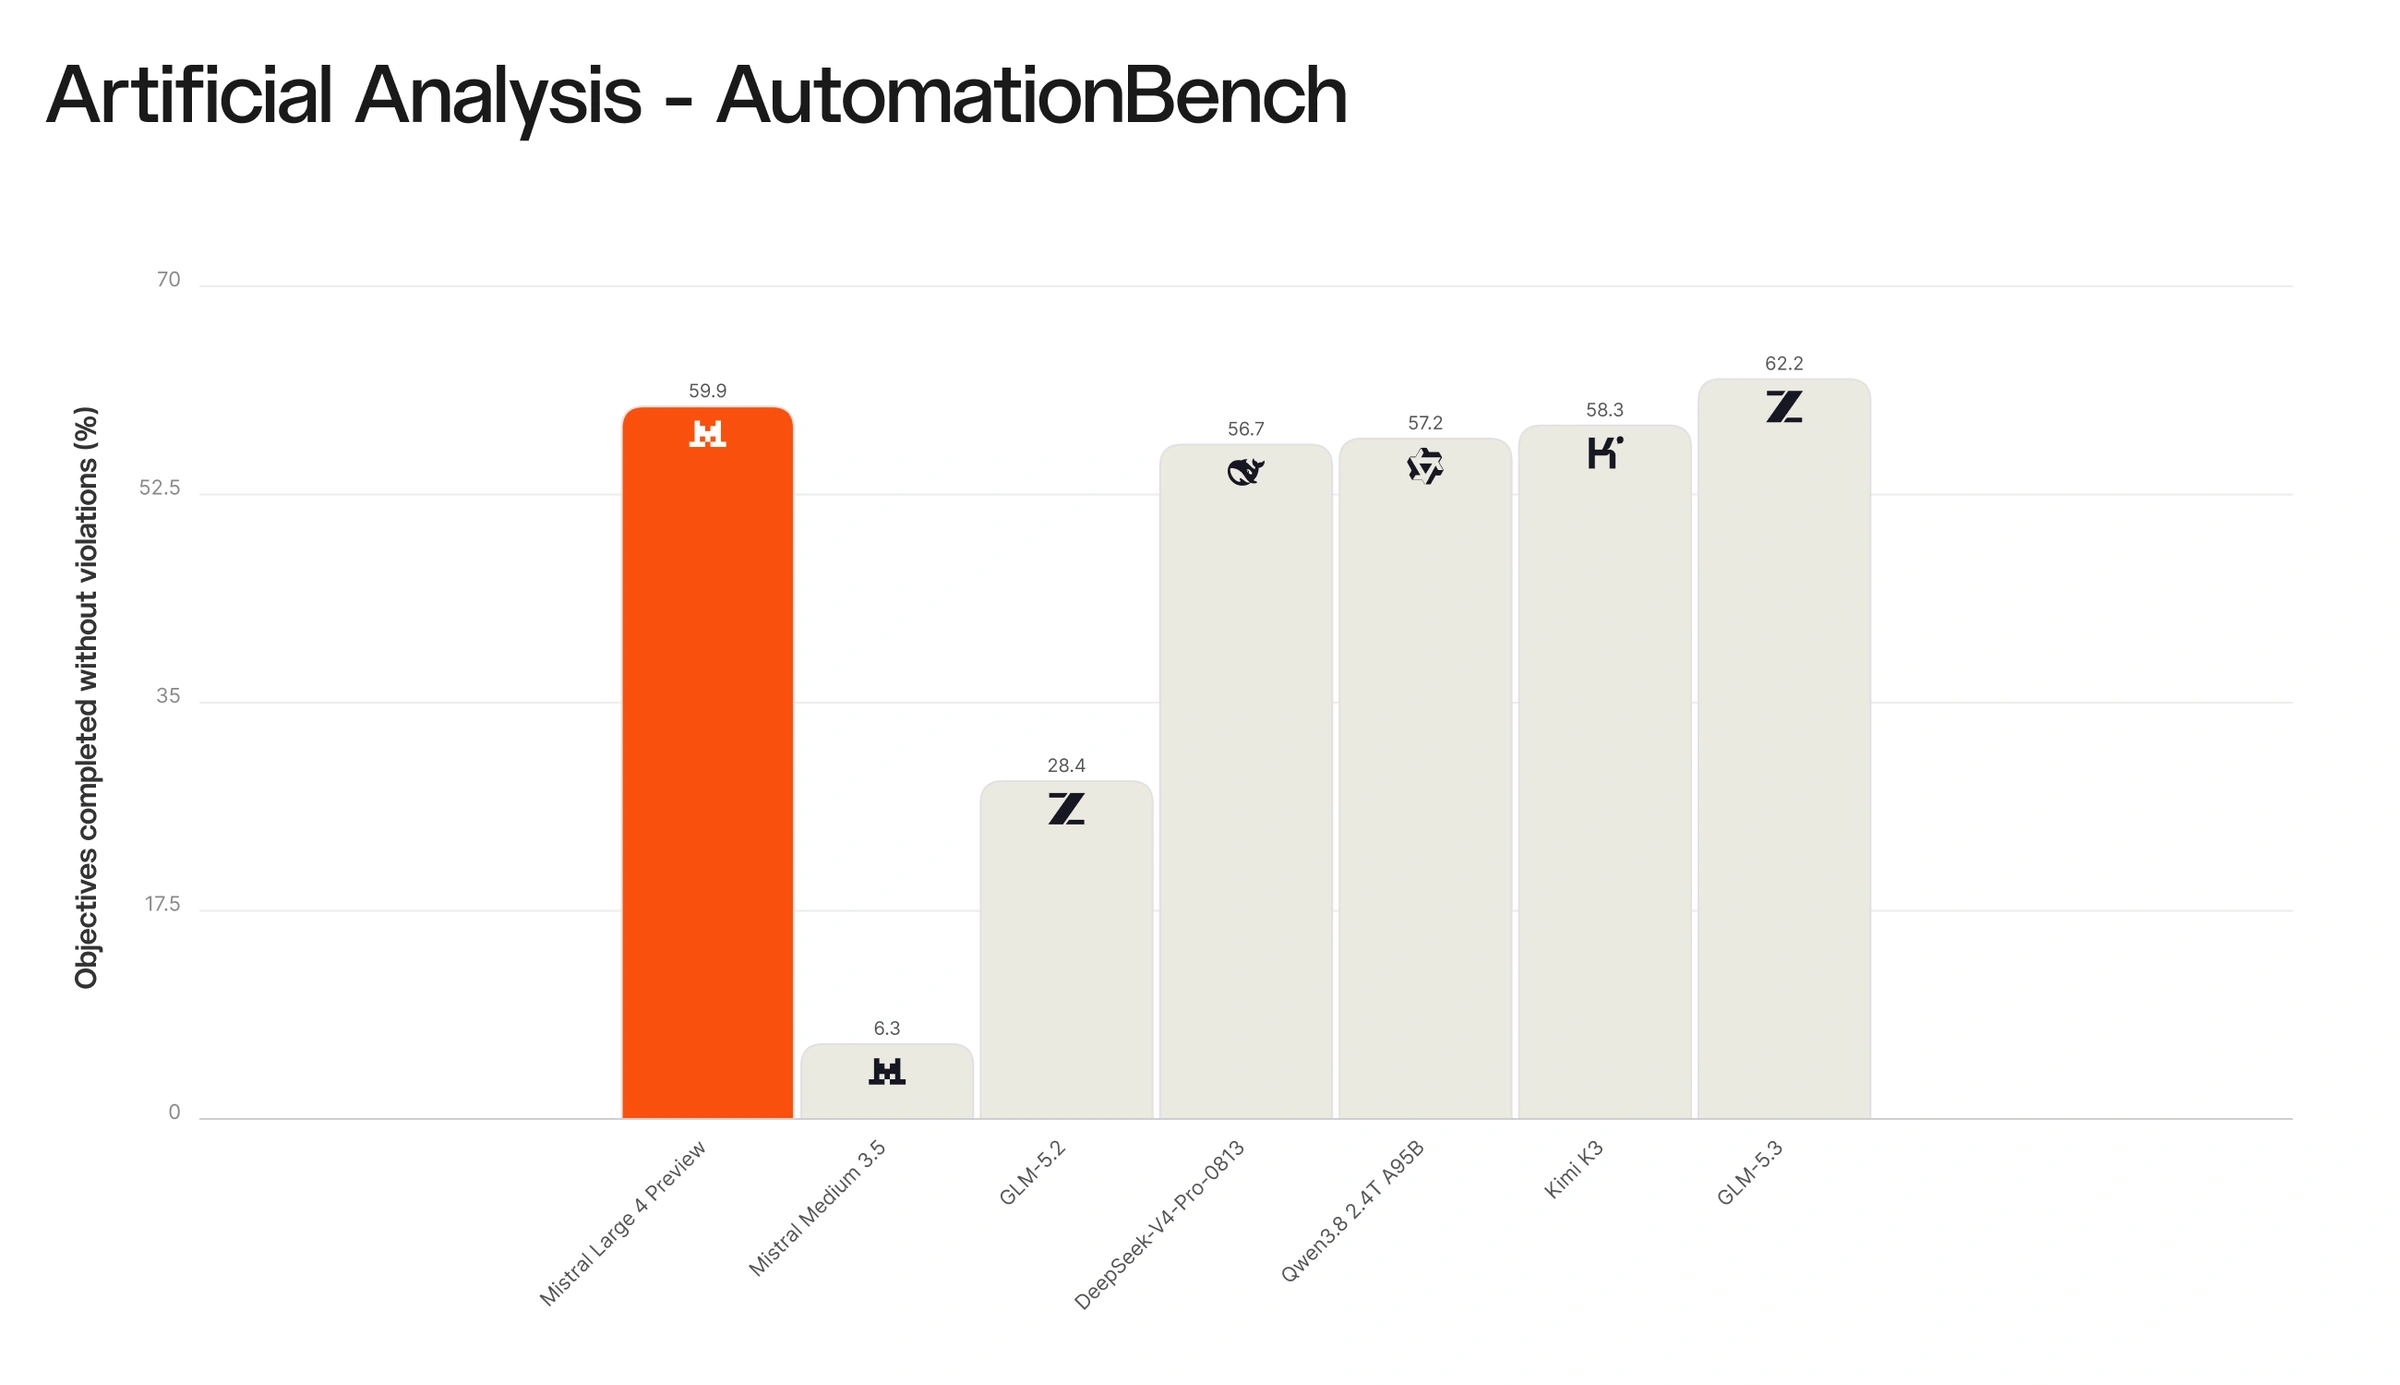
ML4 pilote des agents généralistes qui rassemblent des informations, utilisent des outils et produisent des livrables aboutis dans des workflows complexes. Sur AutomationBench — 657 workflows métier répartis dans des applications comme Gmail, Google Sheets, Slack et Salesforce —, il obtient 59,9 %, devant Kimi K3, MiMo-V2.6-Pro et DeepSeek V4 Pro.
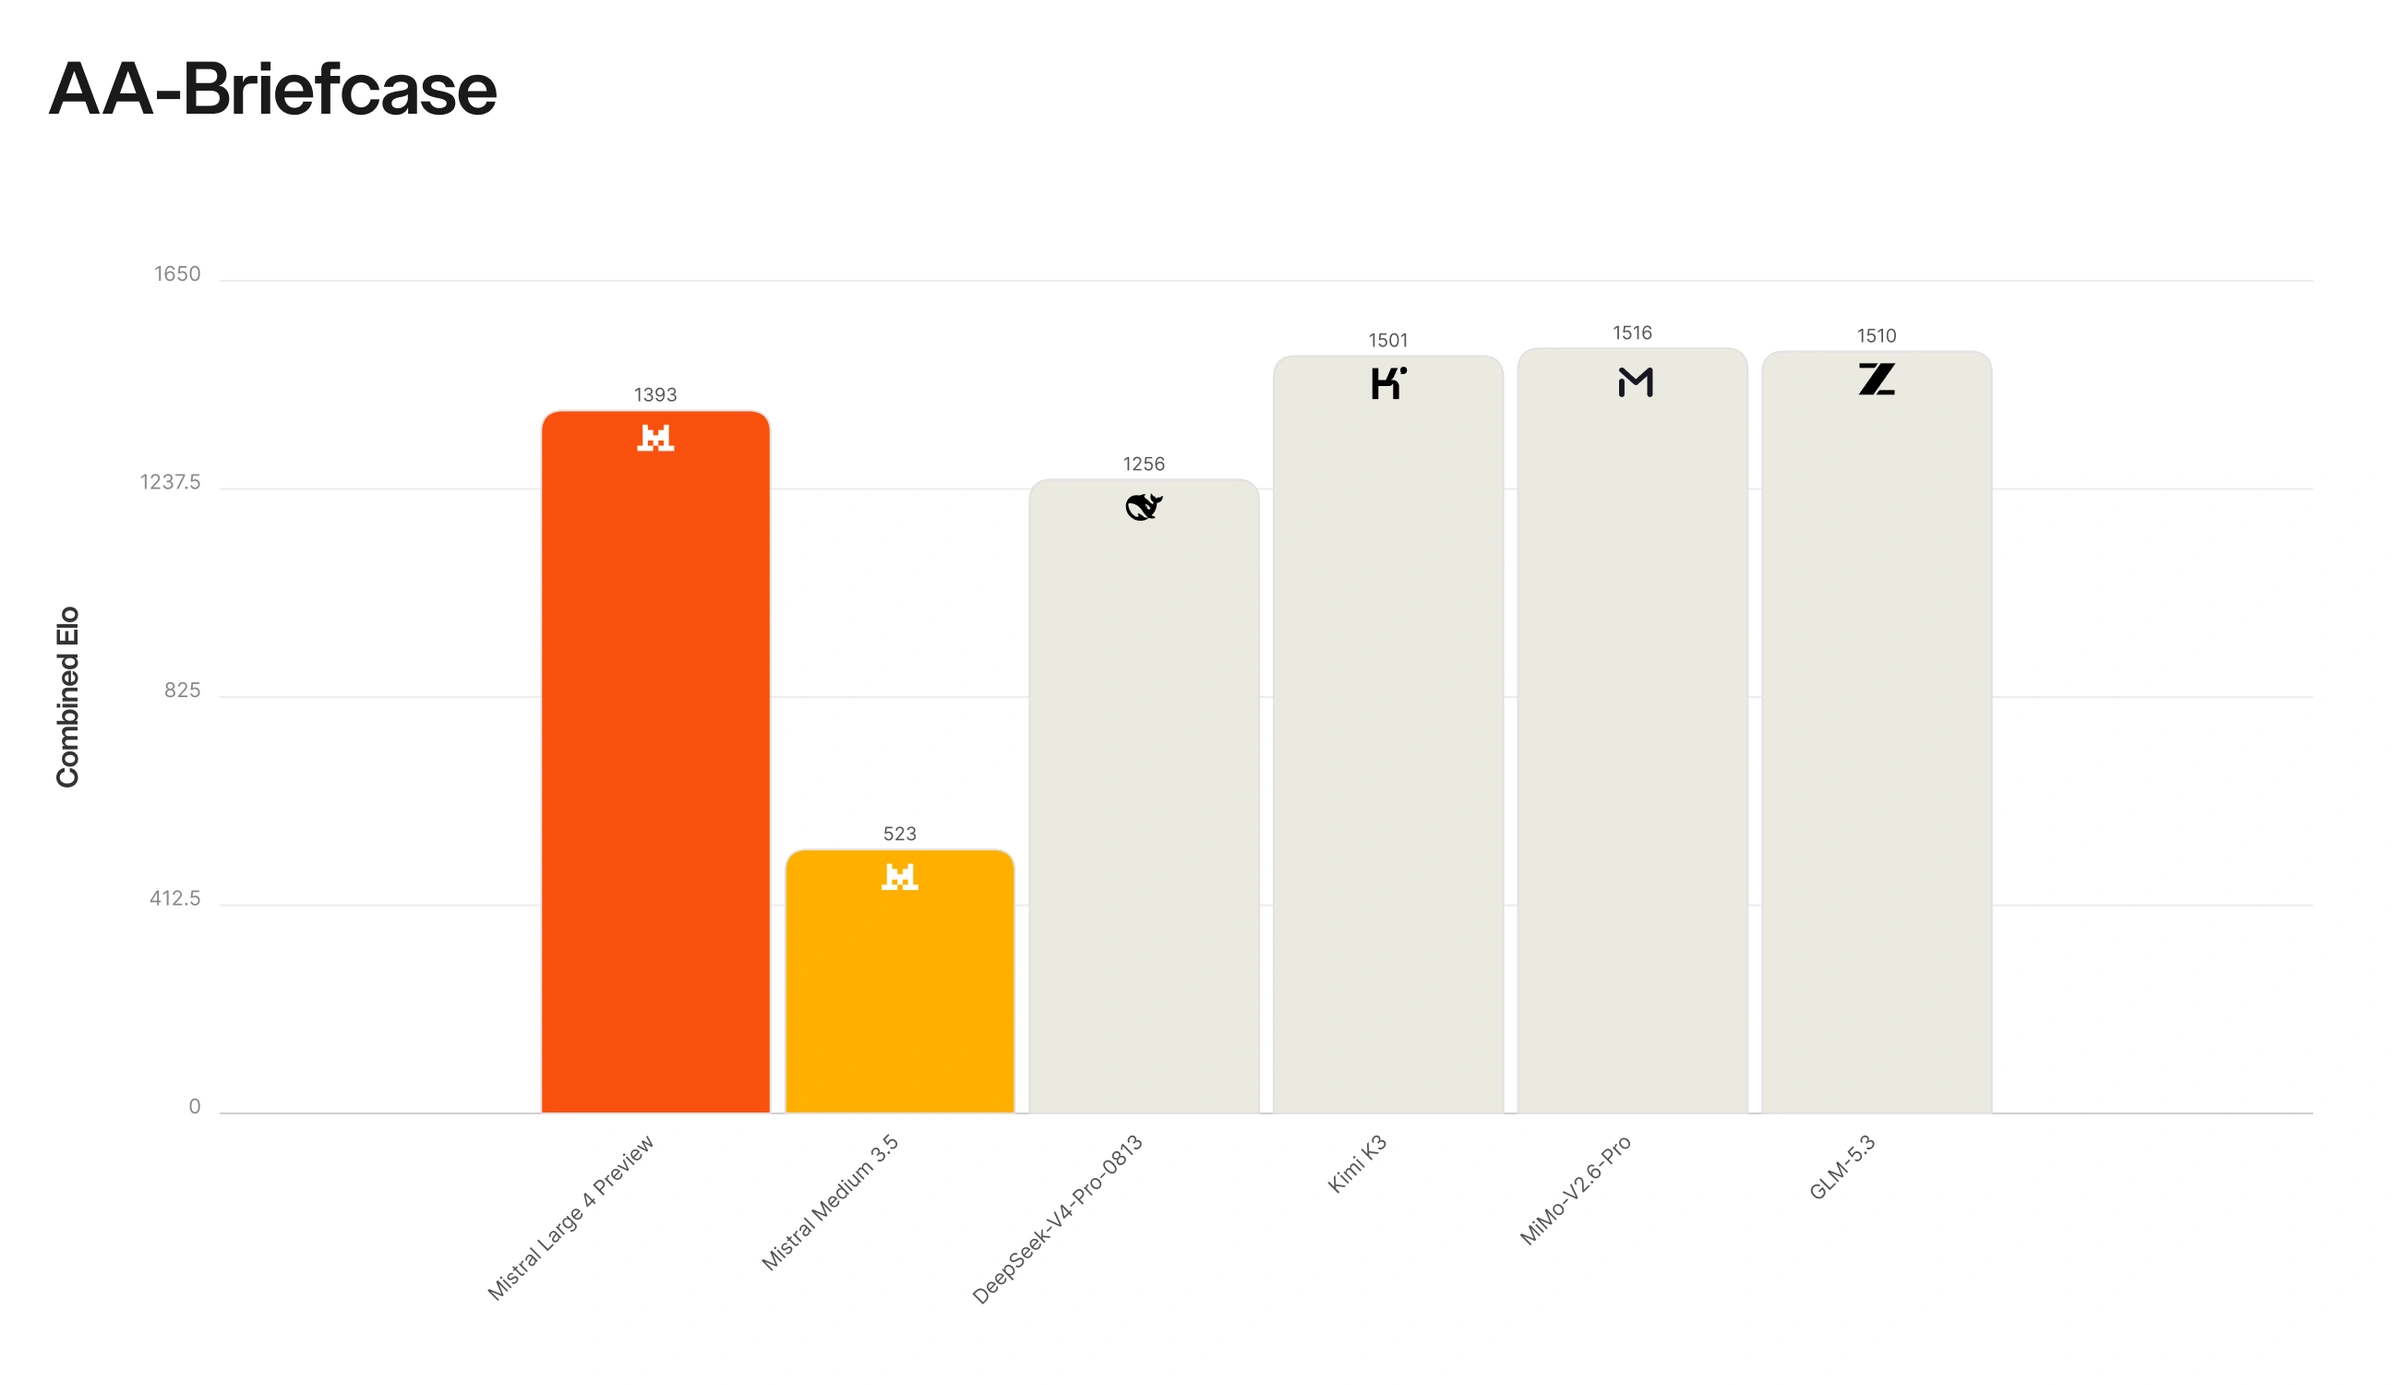
Il est tout aussi performant sur les livrables professionnels que produit réellement le travail intellectuel : tableurs, slides et PDF. Sur AA-Briefcase, qui évalue le travail intellectuel sur de longs horizons, il atteint 1 393 Elo, devant DeepSeek V4 Pro.
Multimodal
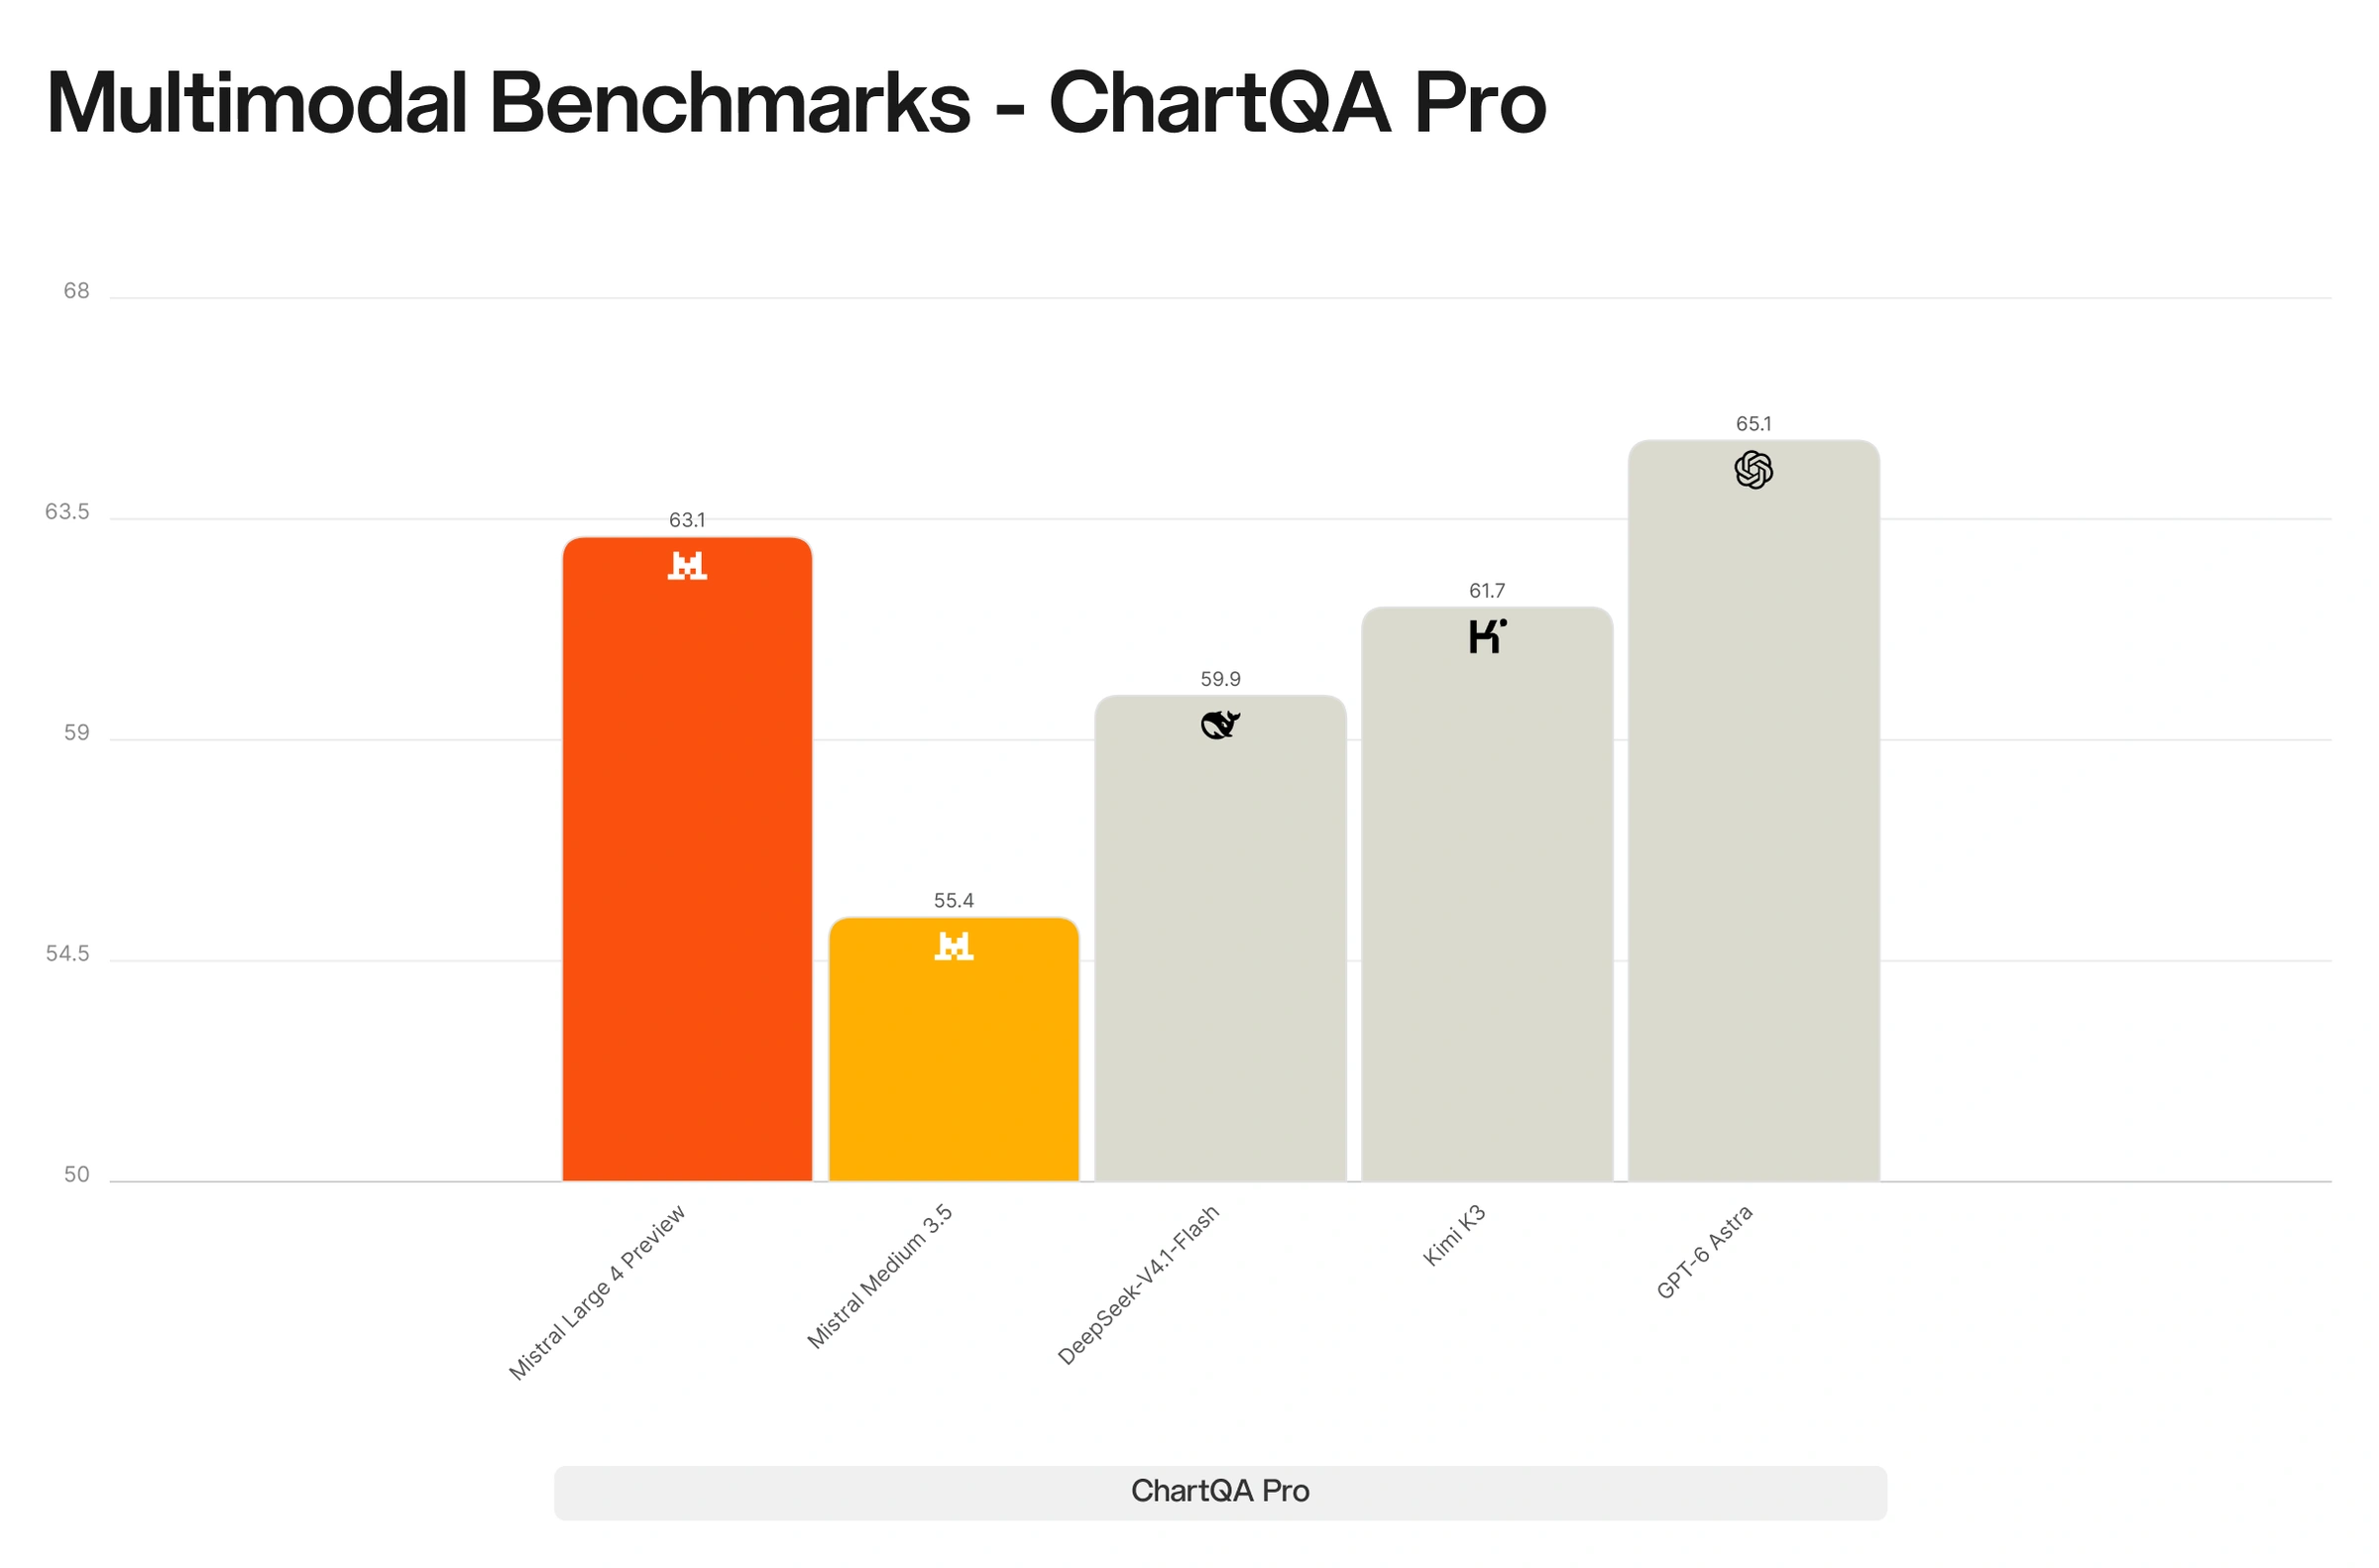
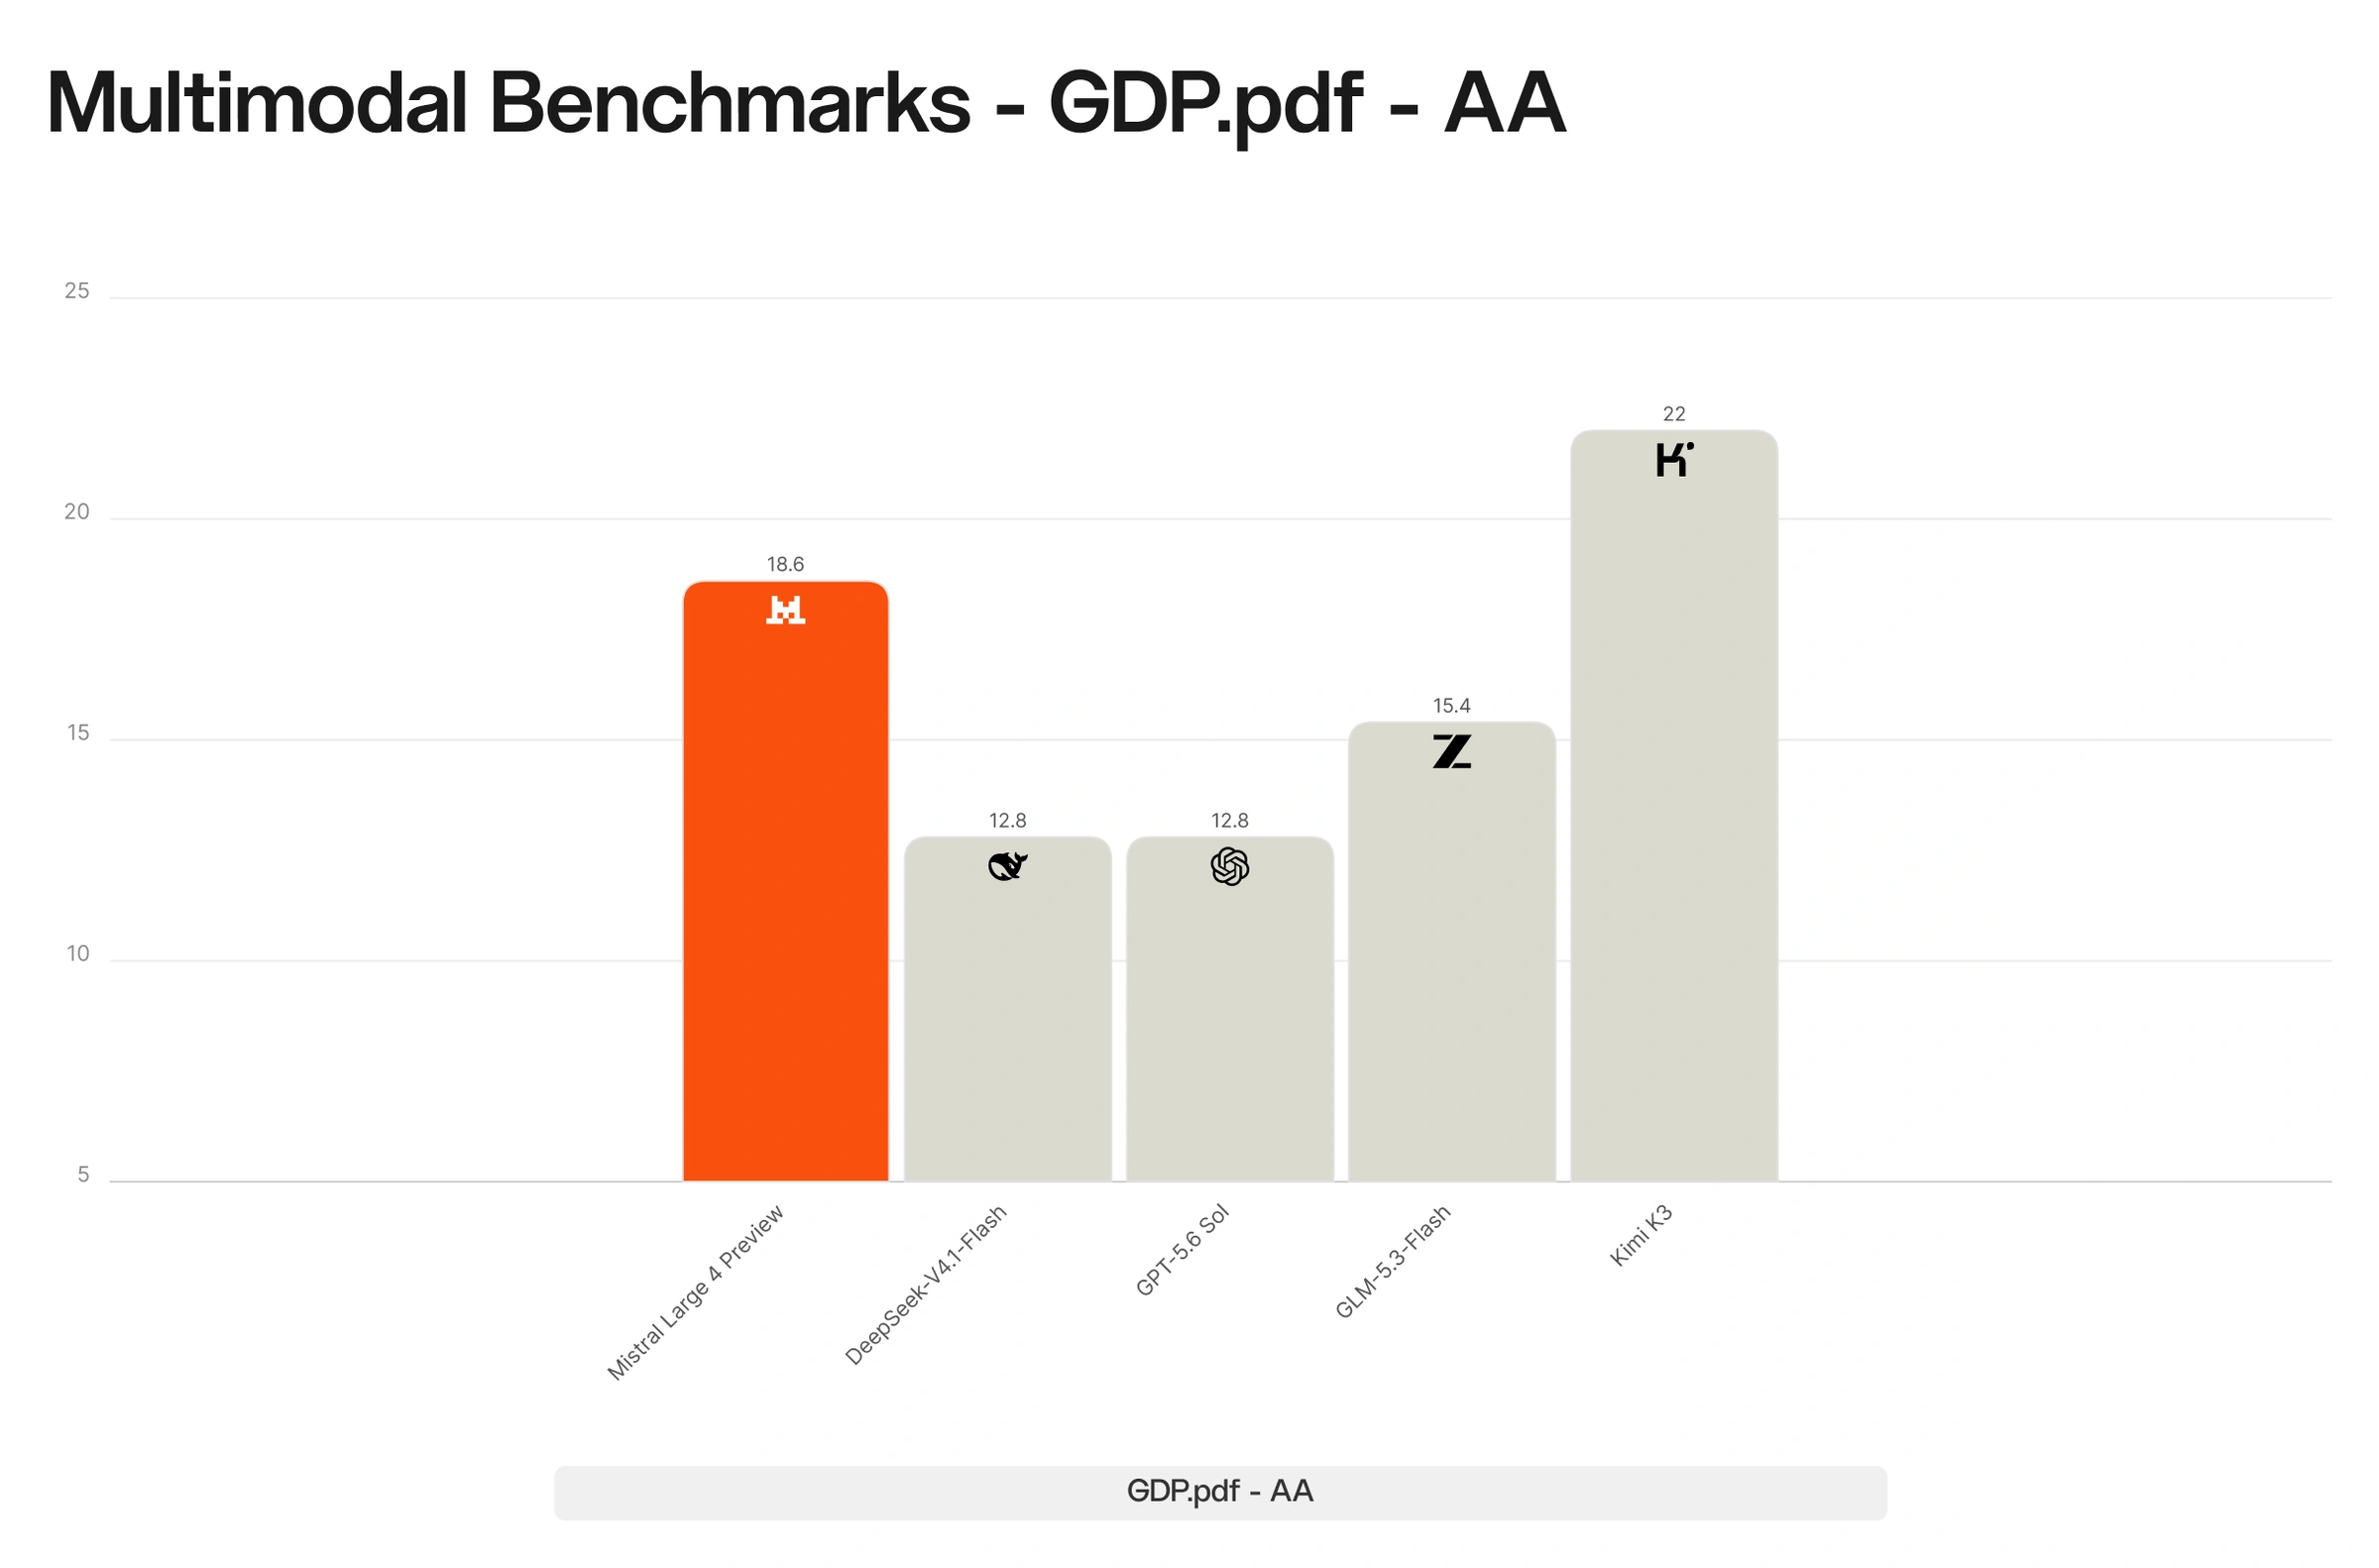
ML4 représente un changement d'échelle dans la capacité de nos modèles à comprendre les images. Il raisonne avec puissance sur des documents complexes, des graphiques et des images naturelles, et apporte la vision aux industries où la perception est critique, comme l'ingénierie, la production industrielle et l'observation de la Terre.
Le modèle peut en outre combiner le visual grounding avec des capacités agentiques : de l'inspection d'imagerie satellite gigapixel — qui aide les équipes de réponse aux catastrophes à agir quand chaque seconde compte — à l'analyse de dessins industriels — en zoomant, en inspectant et en vérifiant jusqu'à ce que la réponse soit exacte. Dans nos démonstrations ci-dessus, ML4 effectue le grounding de scènes naturelles denses, vérifie des pièces mécaniques dans des dessins techniques, retrouve des preuves dans des PDF et parcourt des images géospatiales massives pour repérer les objets les plus difficiles à trouver.
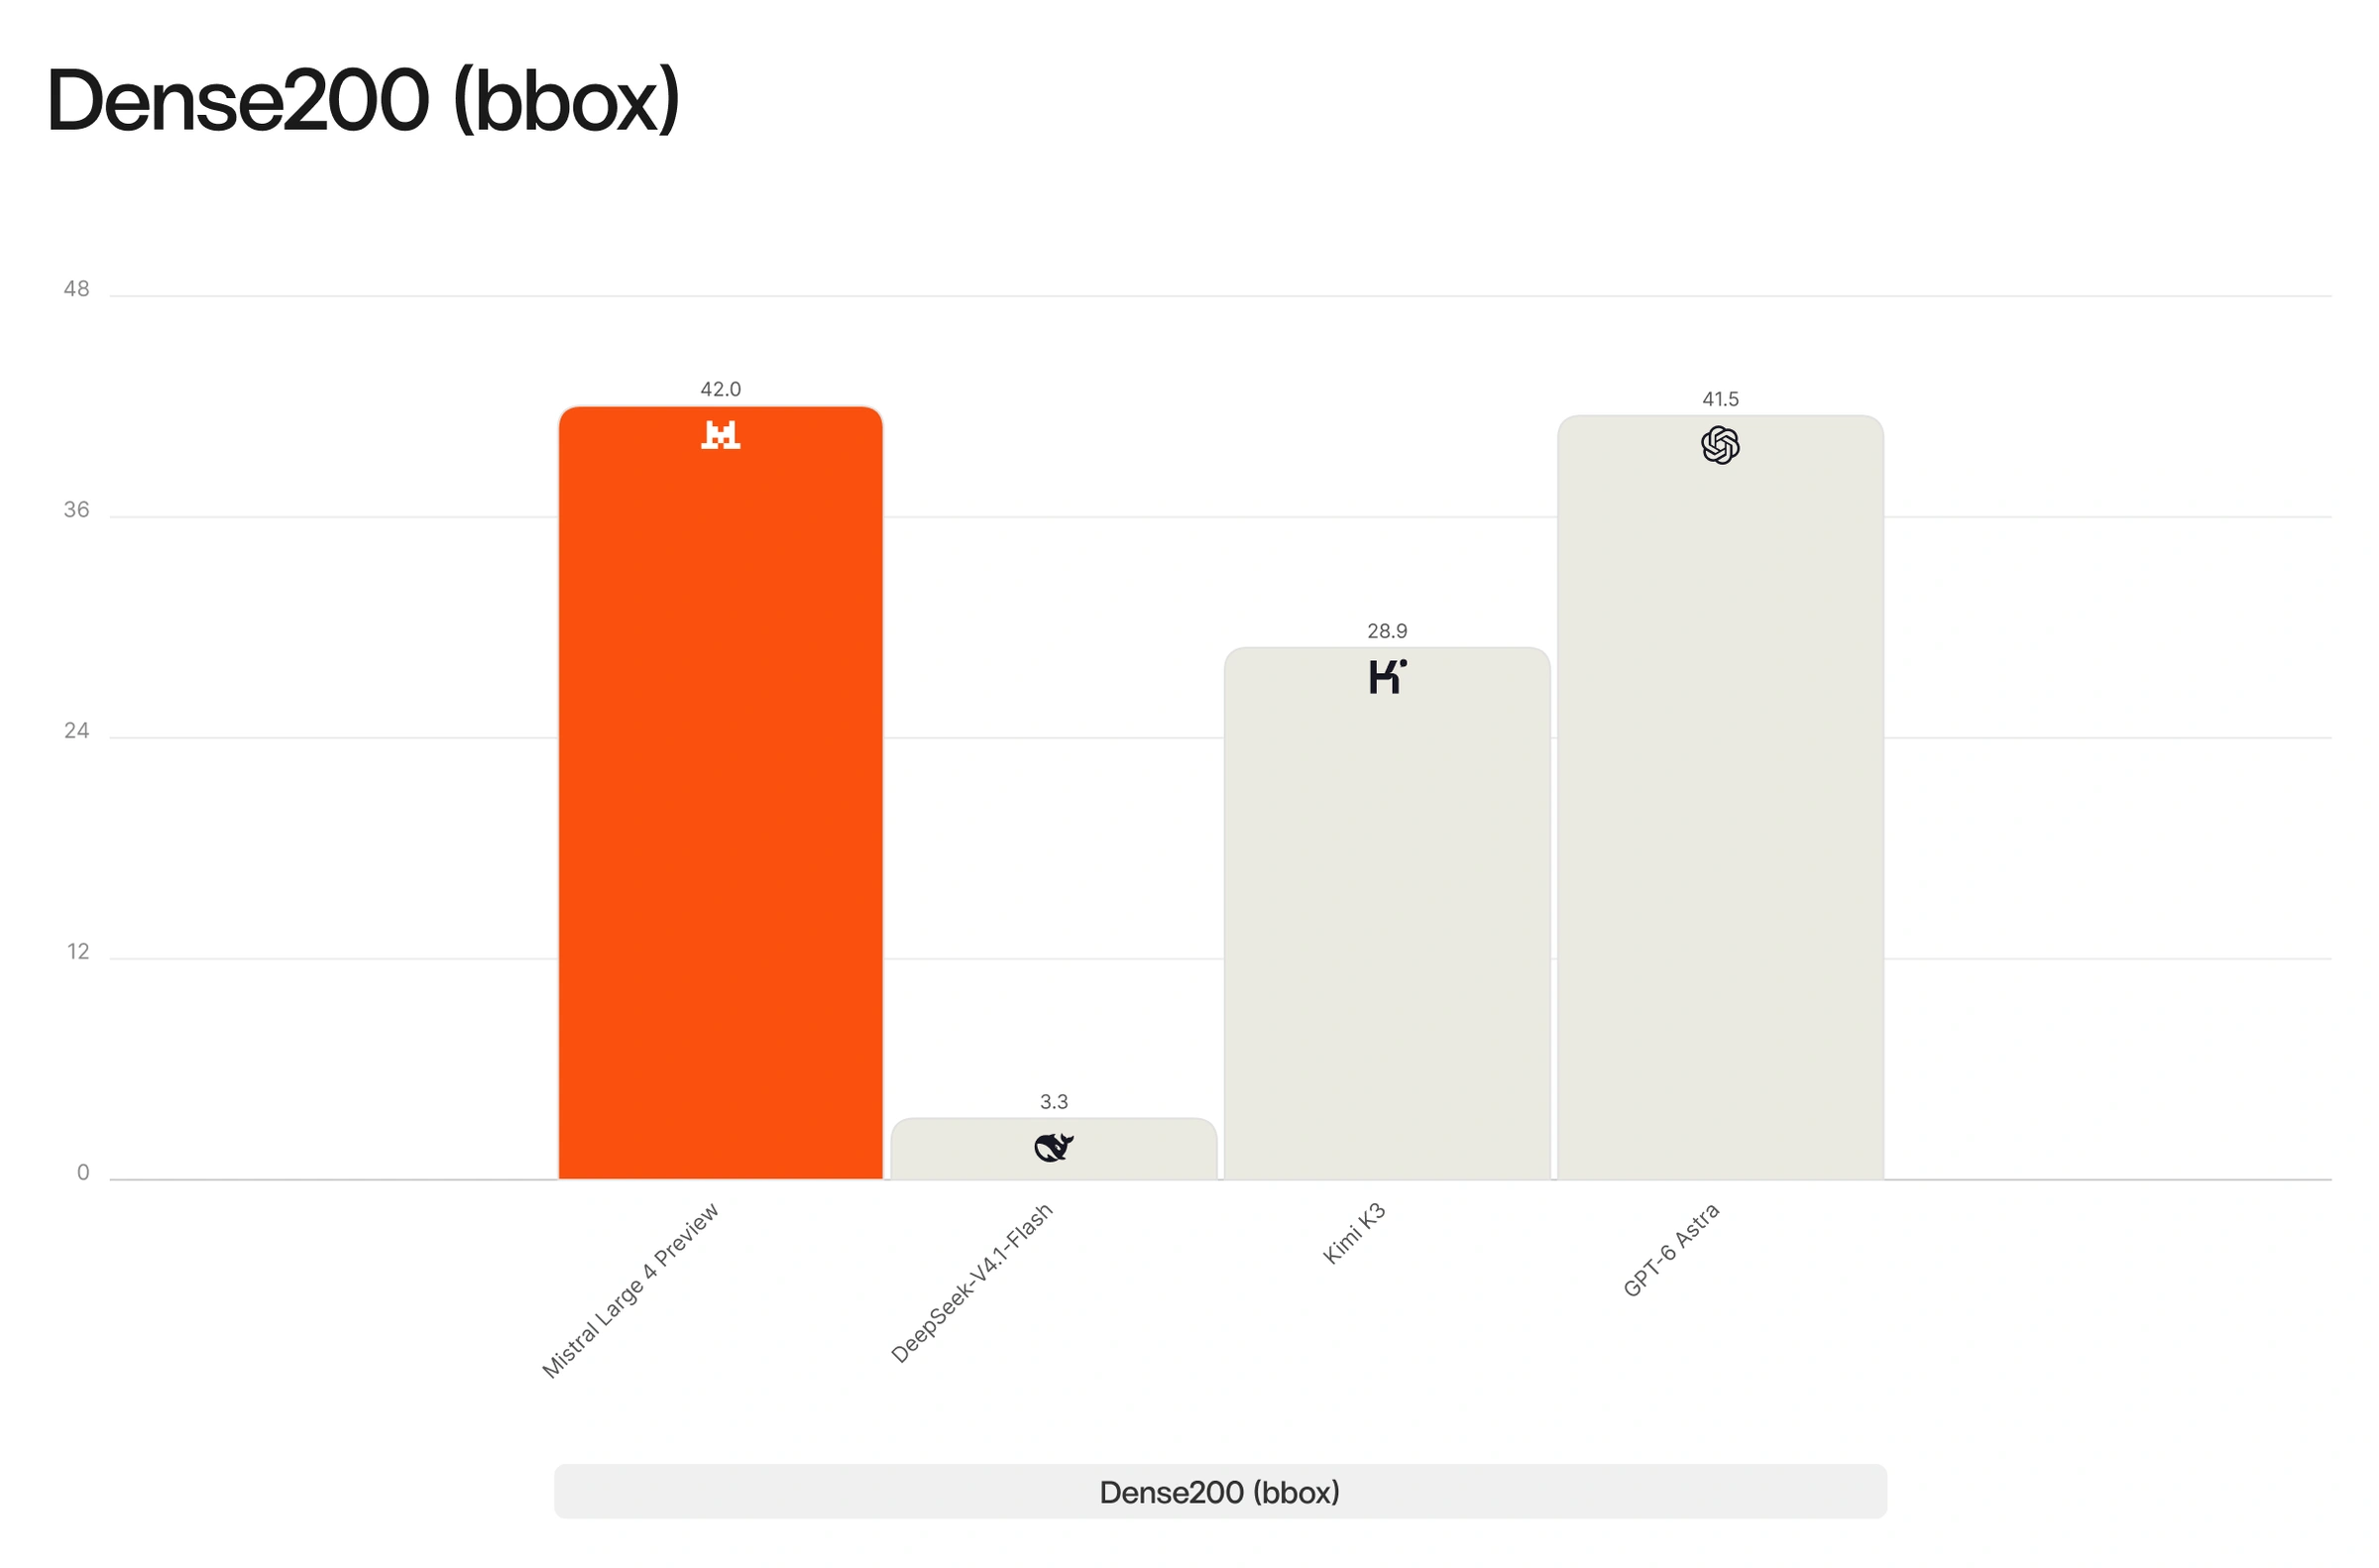
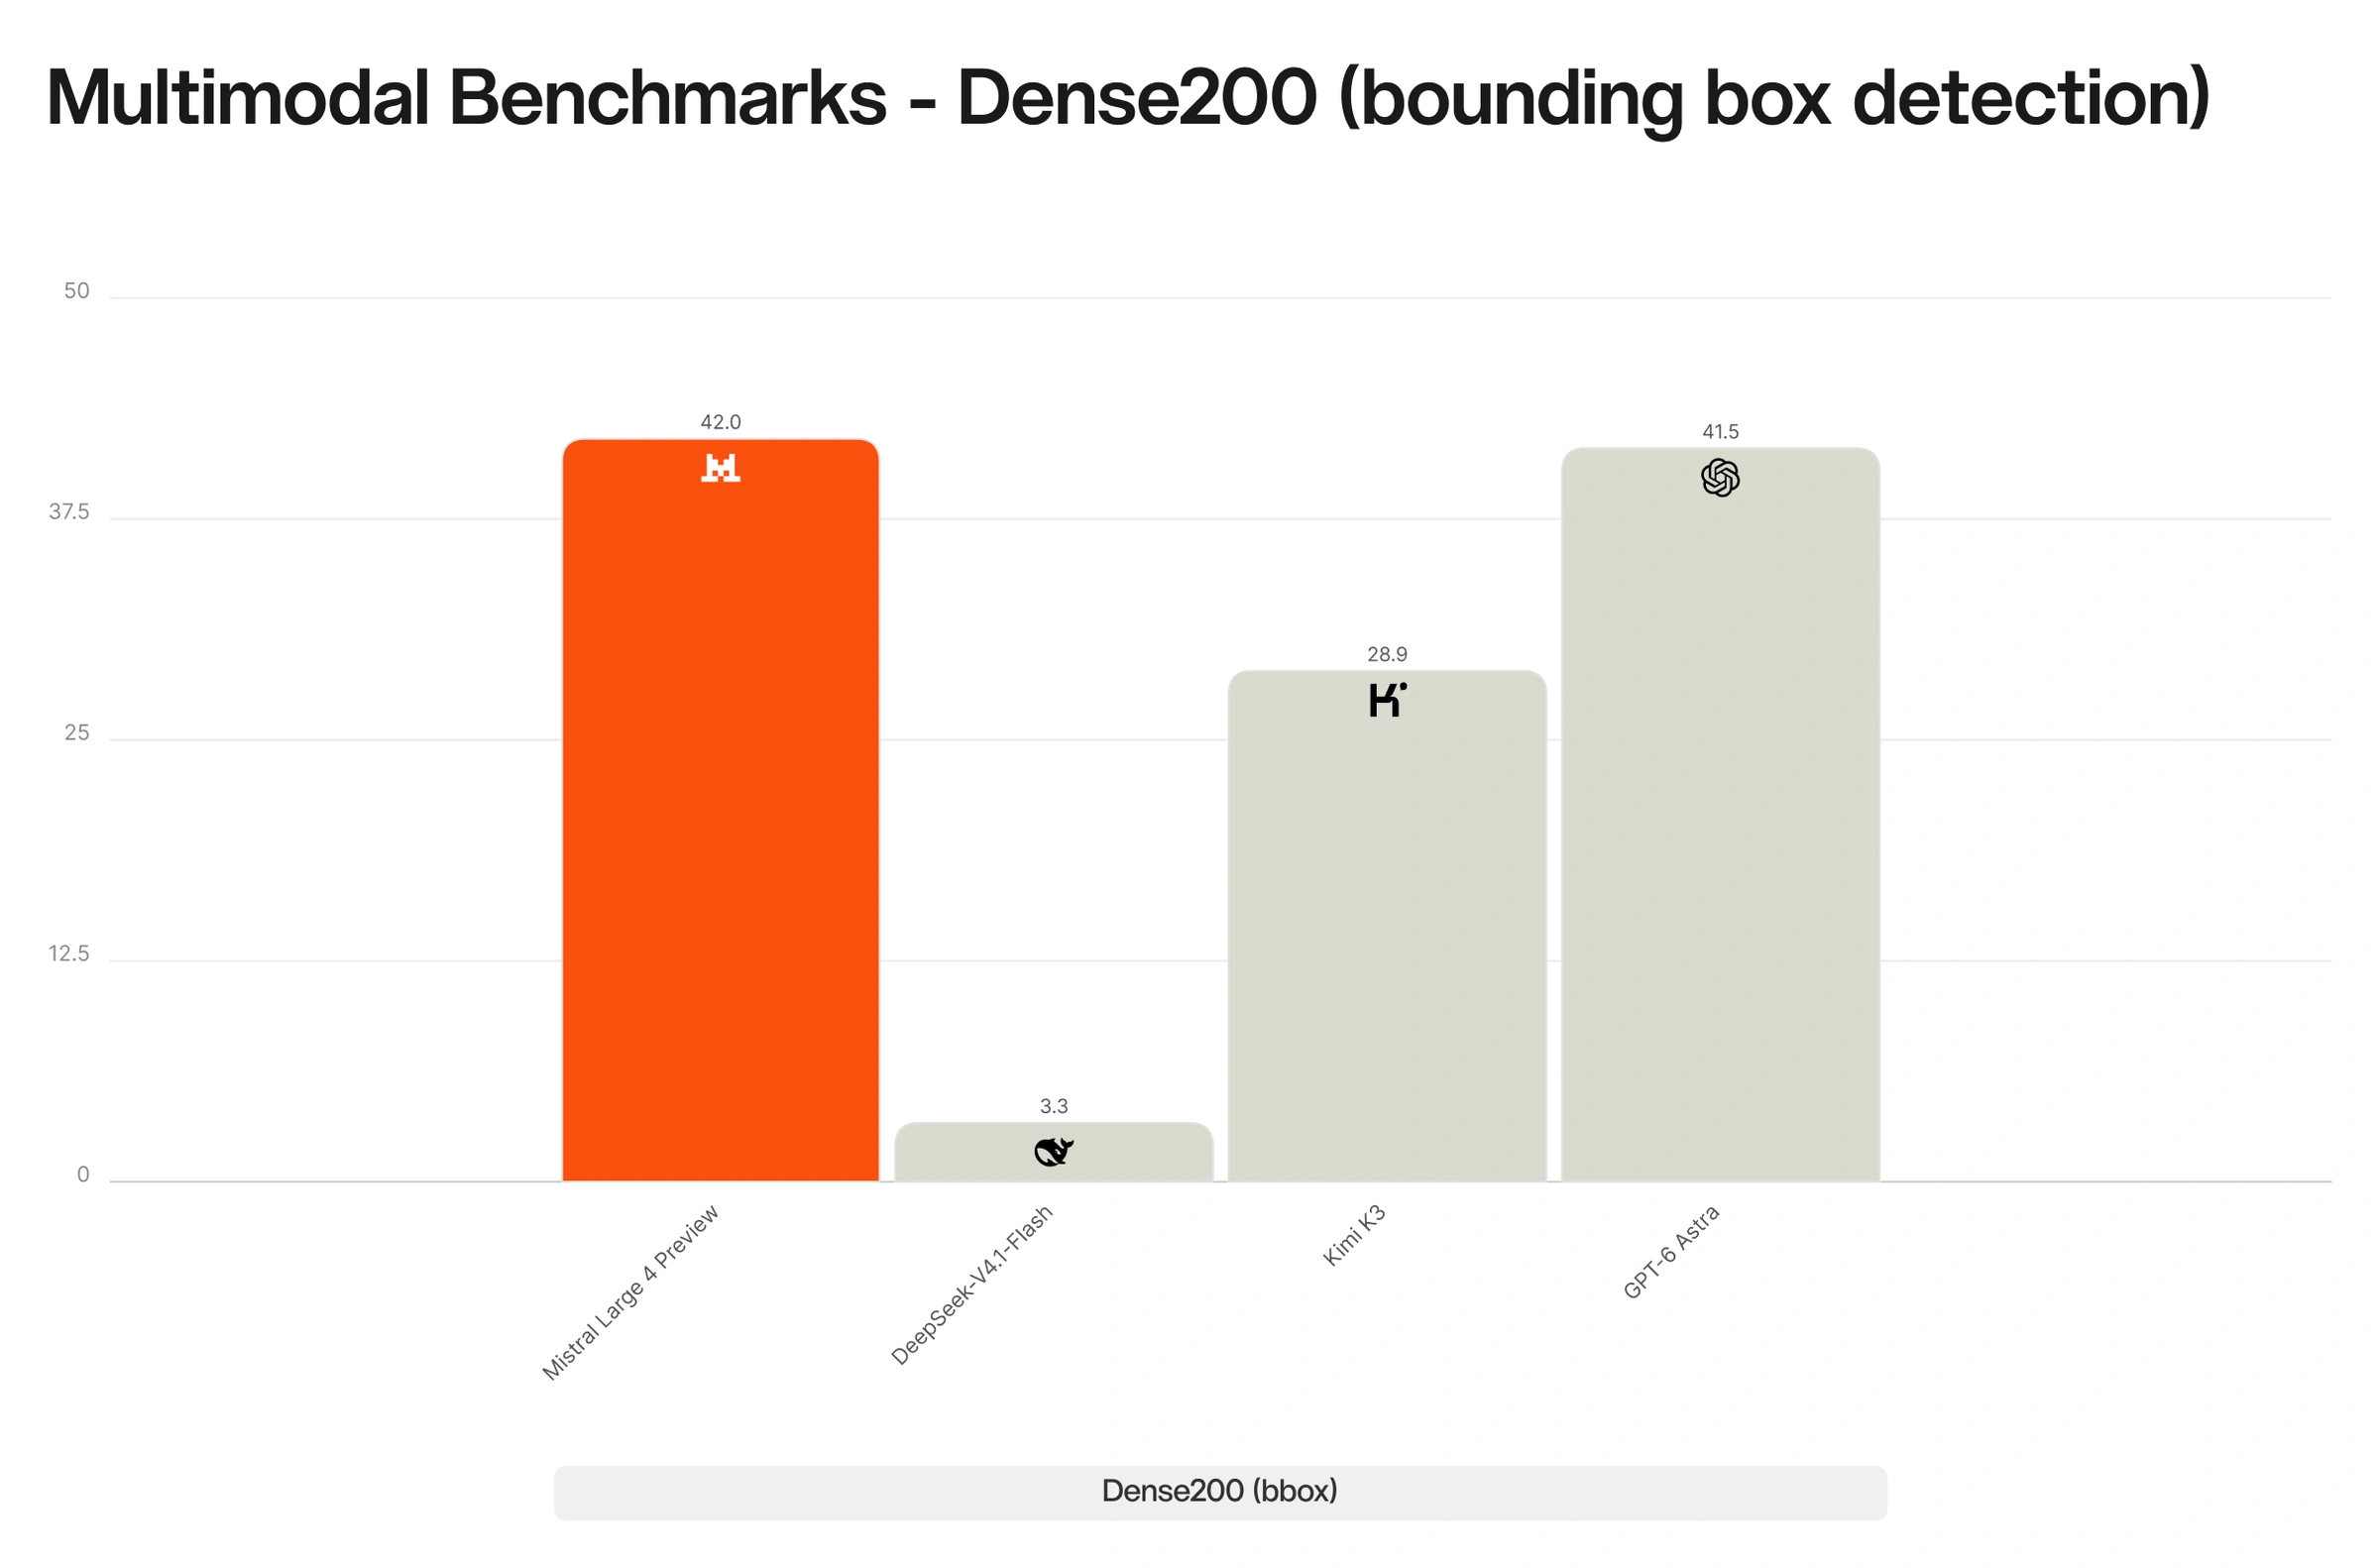
Sur le visual grounding en particulier, nous constatons que ML4 est l'un des modèles les plus performants que nous ayons testés : il surpasse par exemple GPT-6-Astra sur Dense 200 (42 % contre 41 %).
Sciences et mathématiques
ML4 apporte de solides capacités scientifiques, forgées en combinant des méthodes fondées sur l'IA avec l'expertise de nos chercheurs en mathématiques, en physique et en chimie.
Il excelle en codage agentique pour des tâches scientifiques telles que l'analyse de données, la modélisation et la simulation de la réalité physique, ce qui permet aux chercheurs de se concentrer sur les questions plutôt que sur les rouages techniques. Sur les benchmarks, ML4 est à l'état de l'art sur SciCode-Verified parmi les modèles à poids ouverts. En pratique, il peut générer une simulation Hartree–Fock complète en une seule fois — une tâche de chimie complexe et multi-étapes, construite à partir d'une série de routines avancées.
ML4 est aussi plus solide en mathématiques, tant en raisonnement formel qu'en mathématiques appliquées. Dans nos évaluations humaines, il raisonne avec plus de précision et plus de structure que GLM-5.3, et il peut mener de longues tâches de mathématiques appliquées propres à un domaine, y compris des travaux pertinents pour la physique théorique de pointe.
Ensemble, ces capacités font de ML4 un solide assistant de recherche sur l'ensemble du workflow technique — de la première question au résultat final.
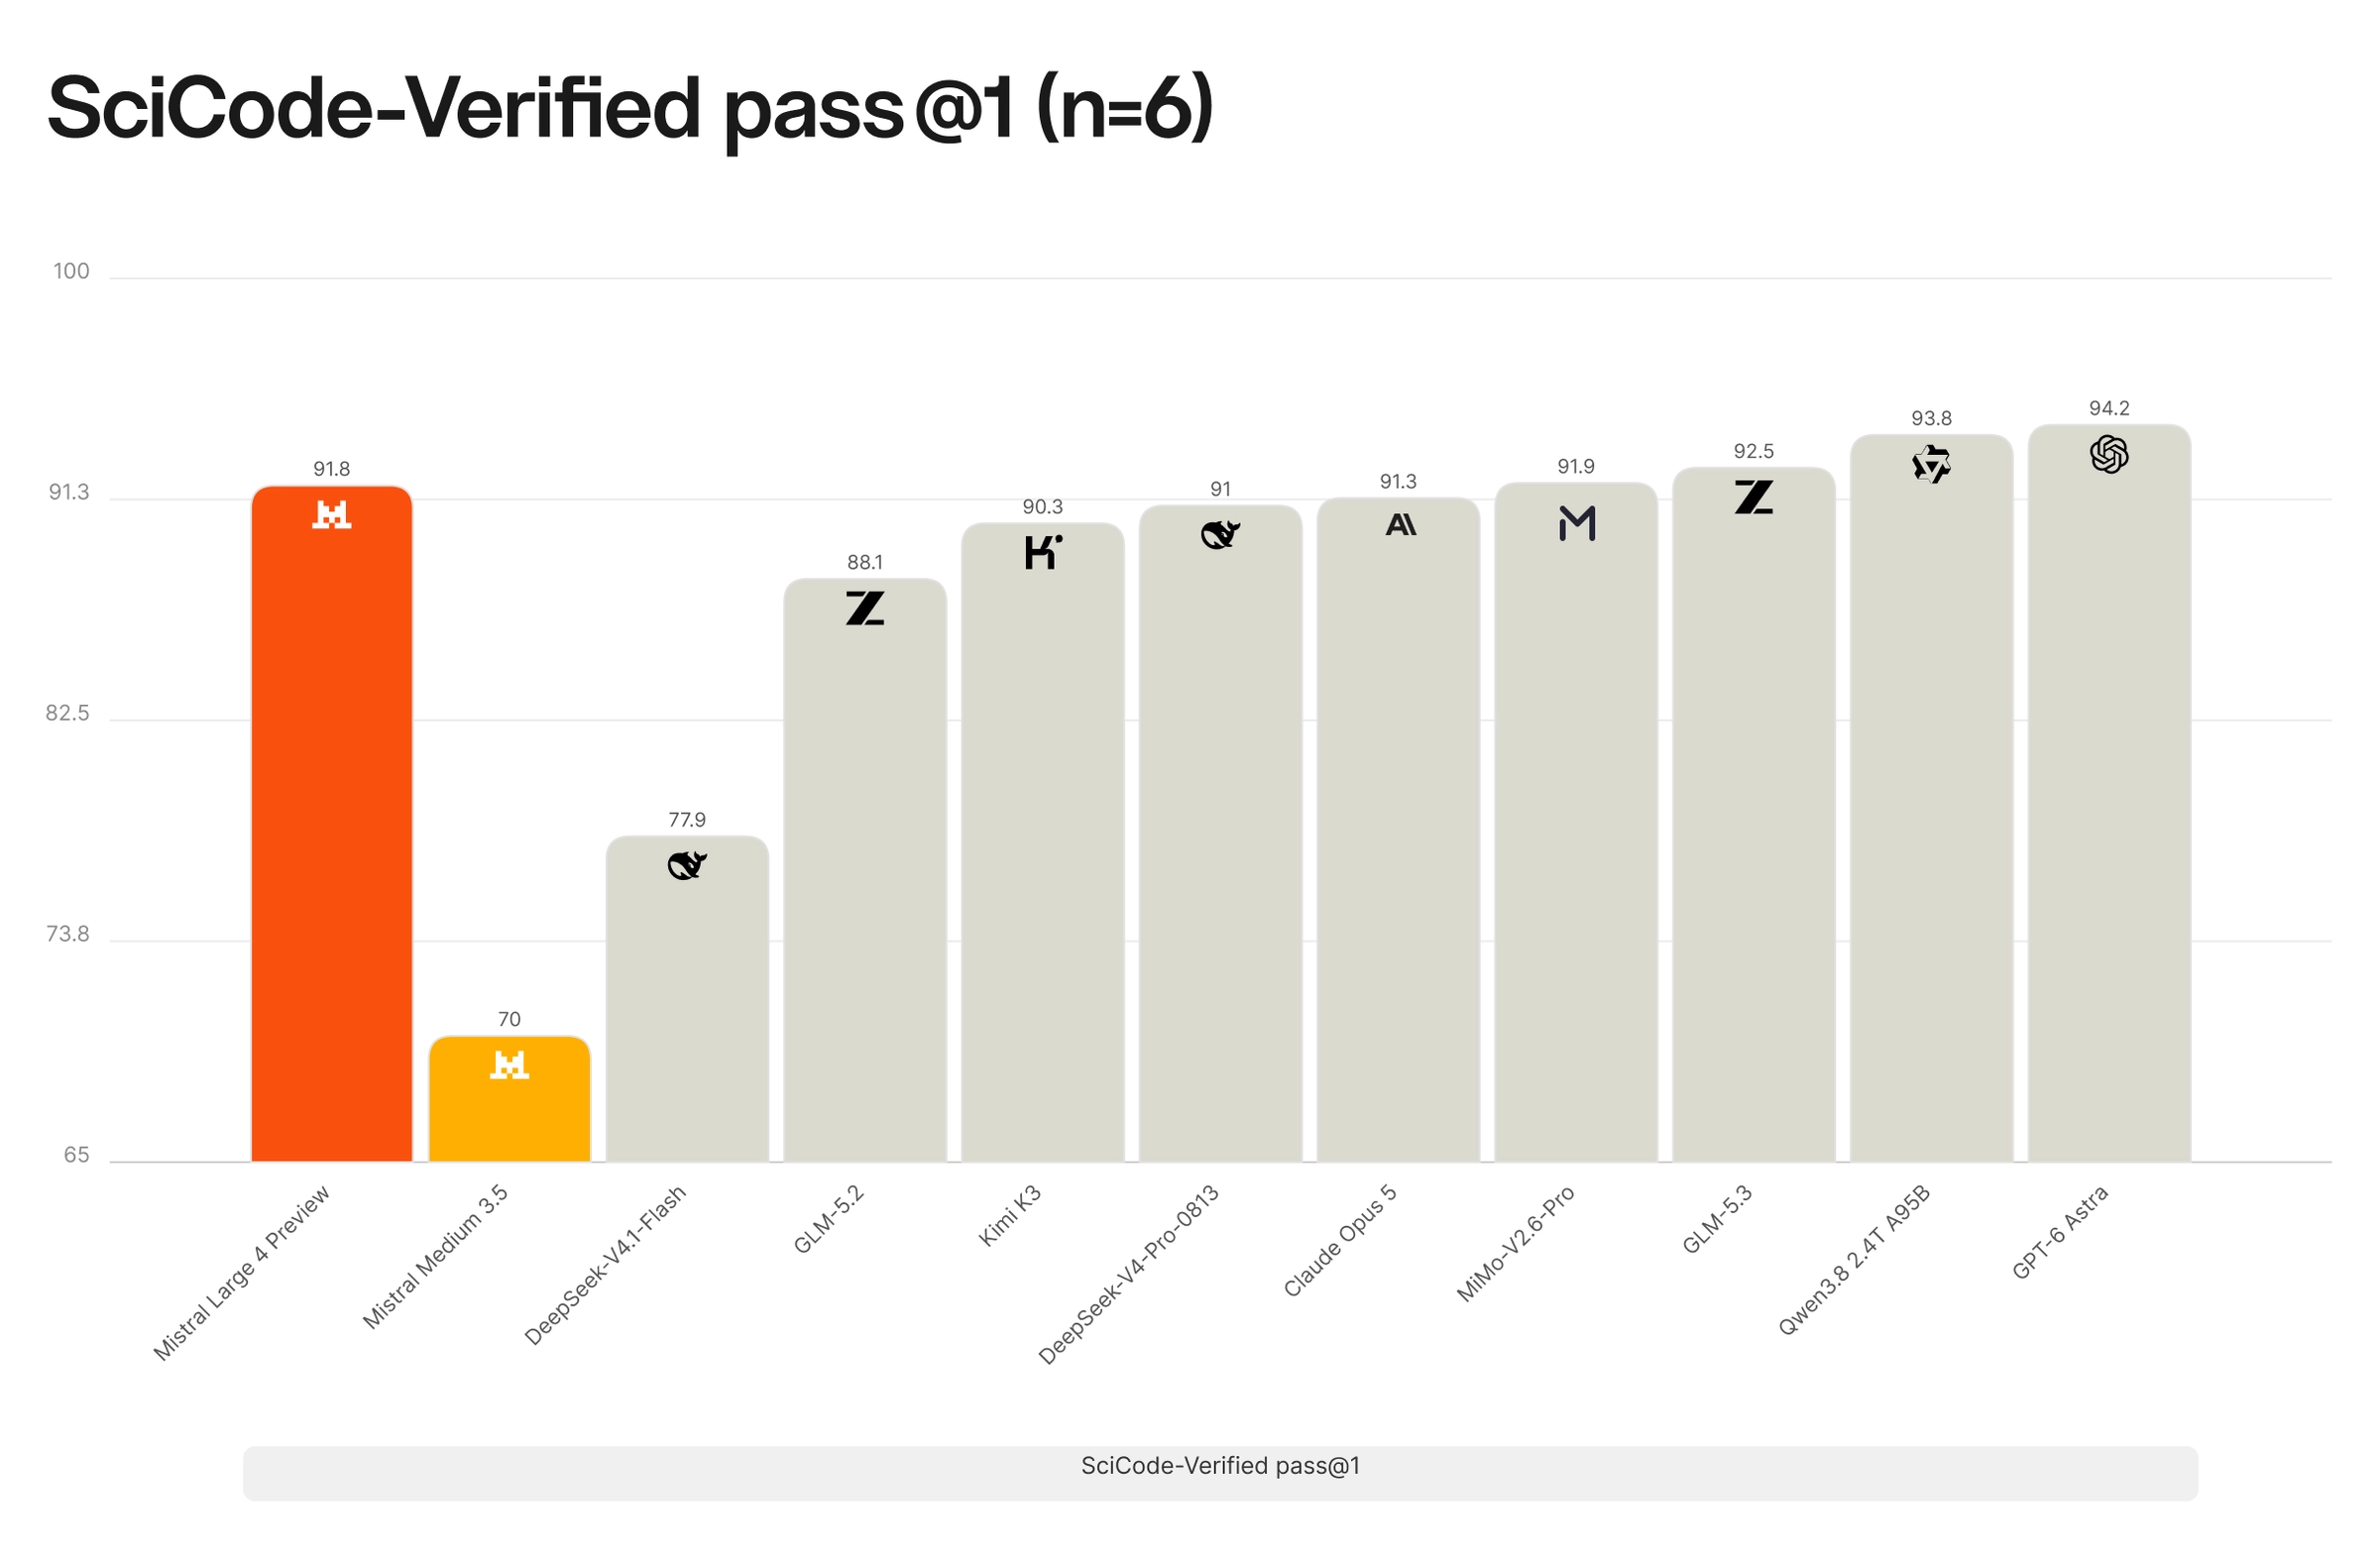
SciCode-Verified évalue la capacité des modèles à implémenter en code des workflows scientifiques complexes pour des domaines tels que la physique, les mathématiques, la science des matériaux et la biologie.

Évaluation interne de ML4 face à GLM5.3 sur des tâches STEM (mathématiques et physique)
Travail intellectuel
ML4 est notre modèle le plus performant pour les tâches concrètes que les professionnels traitent au quotidien. Il peut créer, modifier et corriger des tableurs et des documents complexes, avec des performances exemplaires sur les benchmarks juridiques et financiers.
Notamment, nous avons évalué ML4 via des évaluateurs tiers (vals.ai) sur des tâches représentatives, tant juridiques que financières, et le modèle dépasse GPT-6-Astra dans les deux cas. Sur le benchmark Legal Agent de HarveyAI, ML4 surpasse tous les modèles open source.
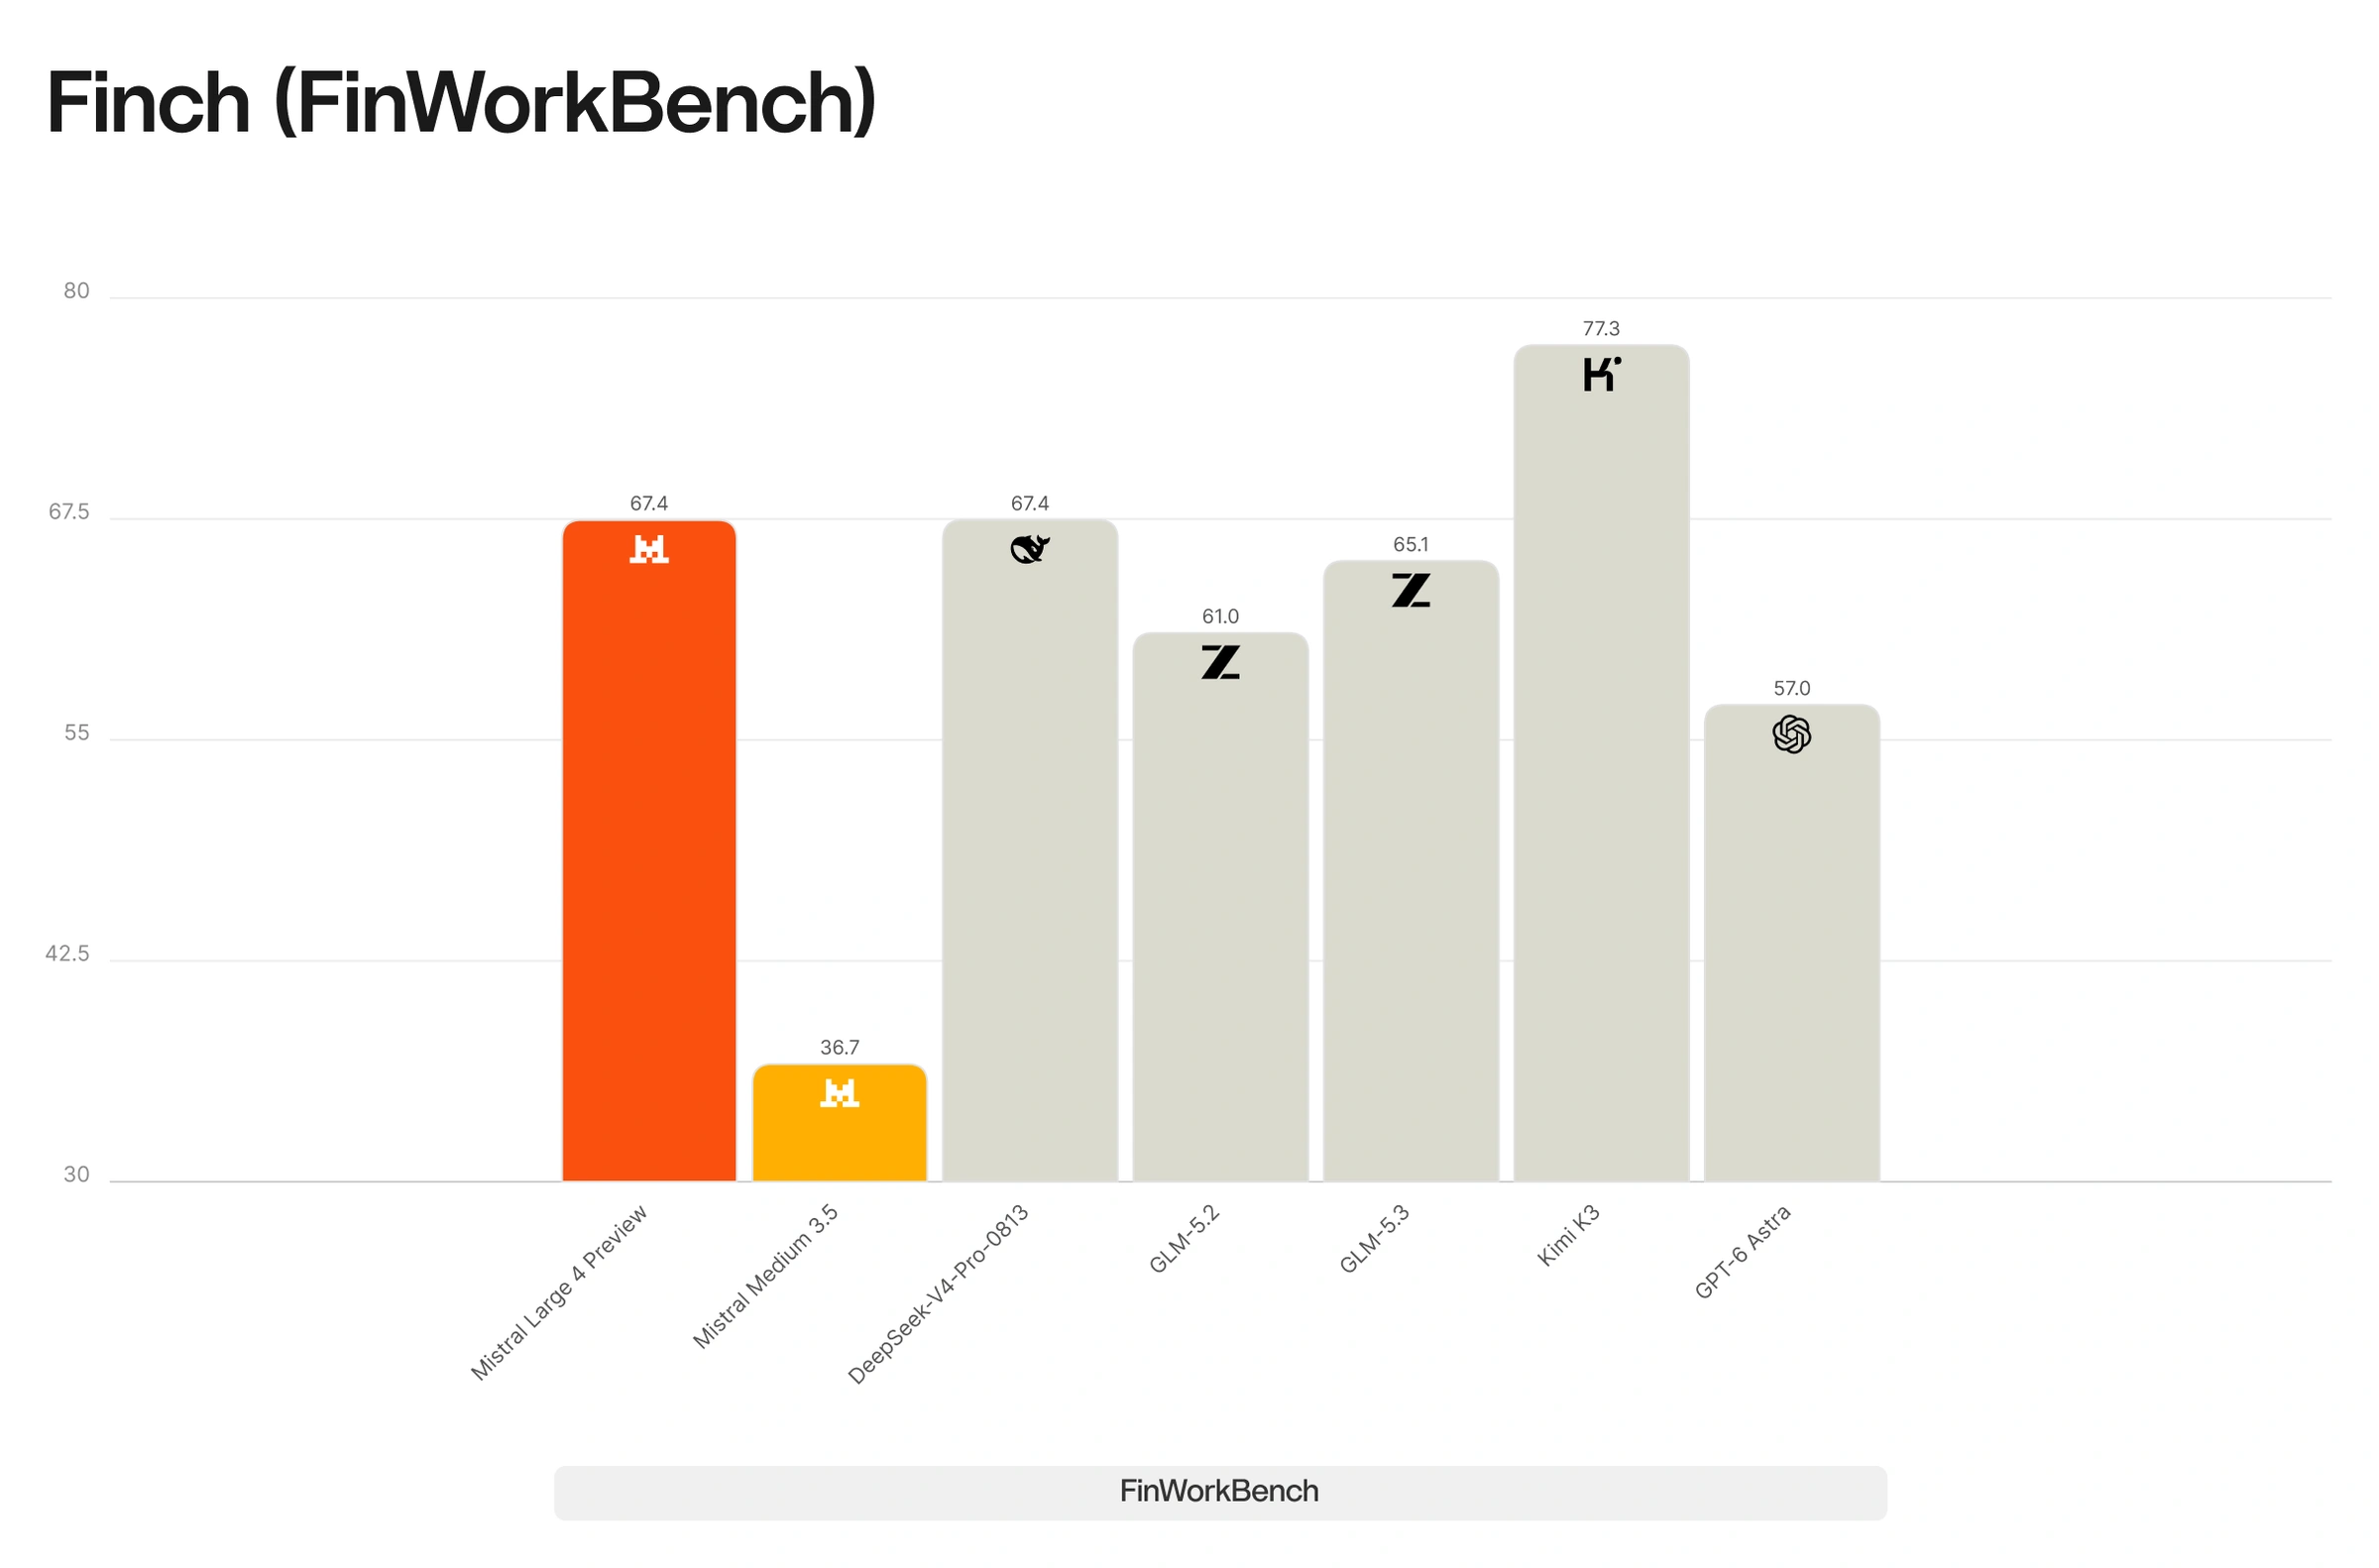
FinWorkBench évalue la capacité des modèles à créer et à modifier des tableurs sur des cas d'utilisation réels en finance et en comptabilité.
L'analyse financière exige de la précision et la capacité à synthétiser des informations issues de sources multiples, un processus encore chronophage dans de nombreuses institutions financières aujourd'hui. Dans cette démonstration, ML4, comparé à d'autres modèles OSS de premier plan, relève le même défi multi-étapes de finance d'entreprise en explorant les dépôts réglementaires et les rapports financiers des sociétés cotées, comme ceux disponibles via EDGAR et les bases de données européennes équivalentes. Une carte sémantique animée retrace le parcours de chaque modèle vers une solution et met en évidence chaque document récupéré en chemin. La position de chaque piste reflète les preuves rassemblées, les résultats des calculs et les questions qui restent sans réponse. Les spectateurs peuvent suivre le déroulement des investigations et comparer les chemins distincts qu'emprunte chaque modèle avant d'aboutir à sa réponse finale.
Sécurité du modèle
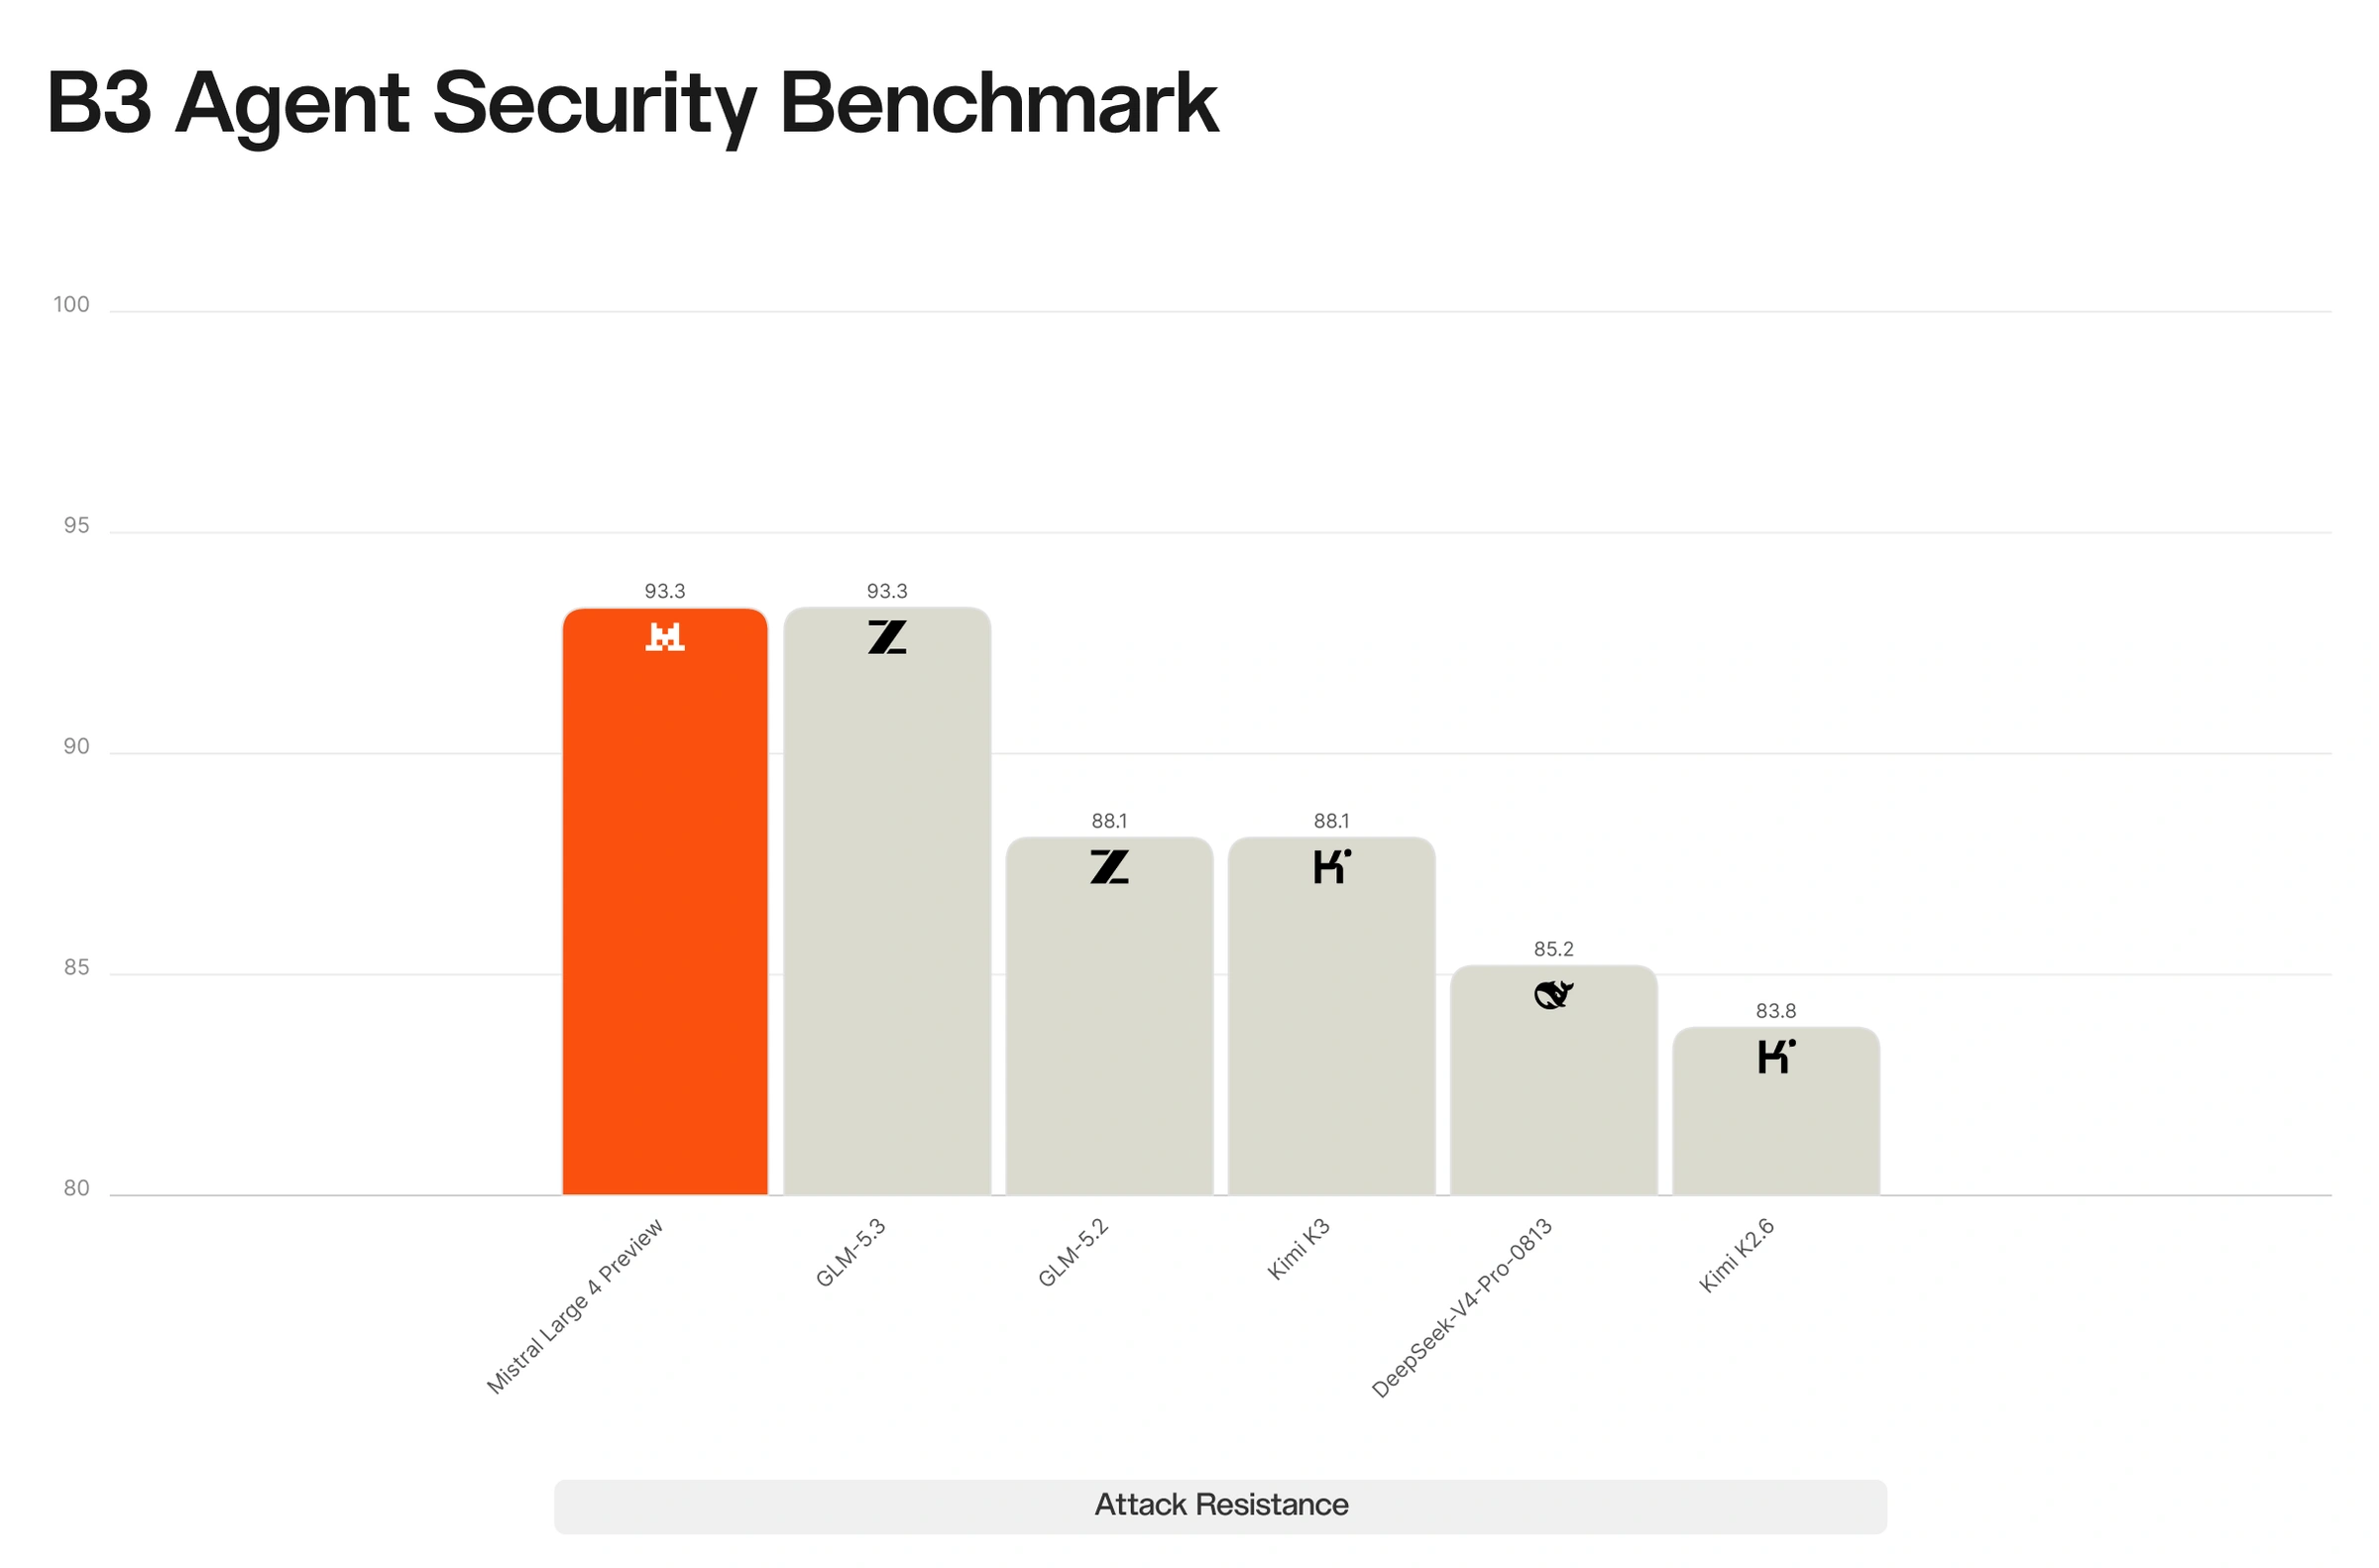

ML4 a saturé nos benchmarks de robustesse aux injections de prompt indirectes, ce qui le place à l'avant-garde des modèles OSS (comparé à GLM-5.2, GLM-5.3, Kimi-K2.6, Kimi-K3, DS-V4-Pro-0813). Sur le B3 AI Security Benchmark public de Lakera, ML4 résiste à 93,3 % des attaques – nous n'observons aucun score supérieur chez les concurrents.
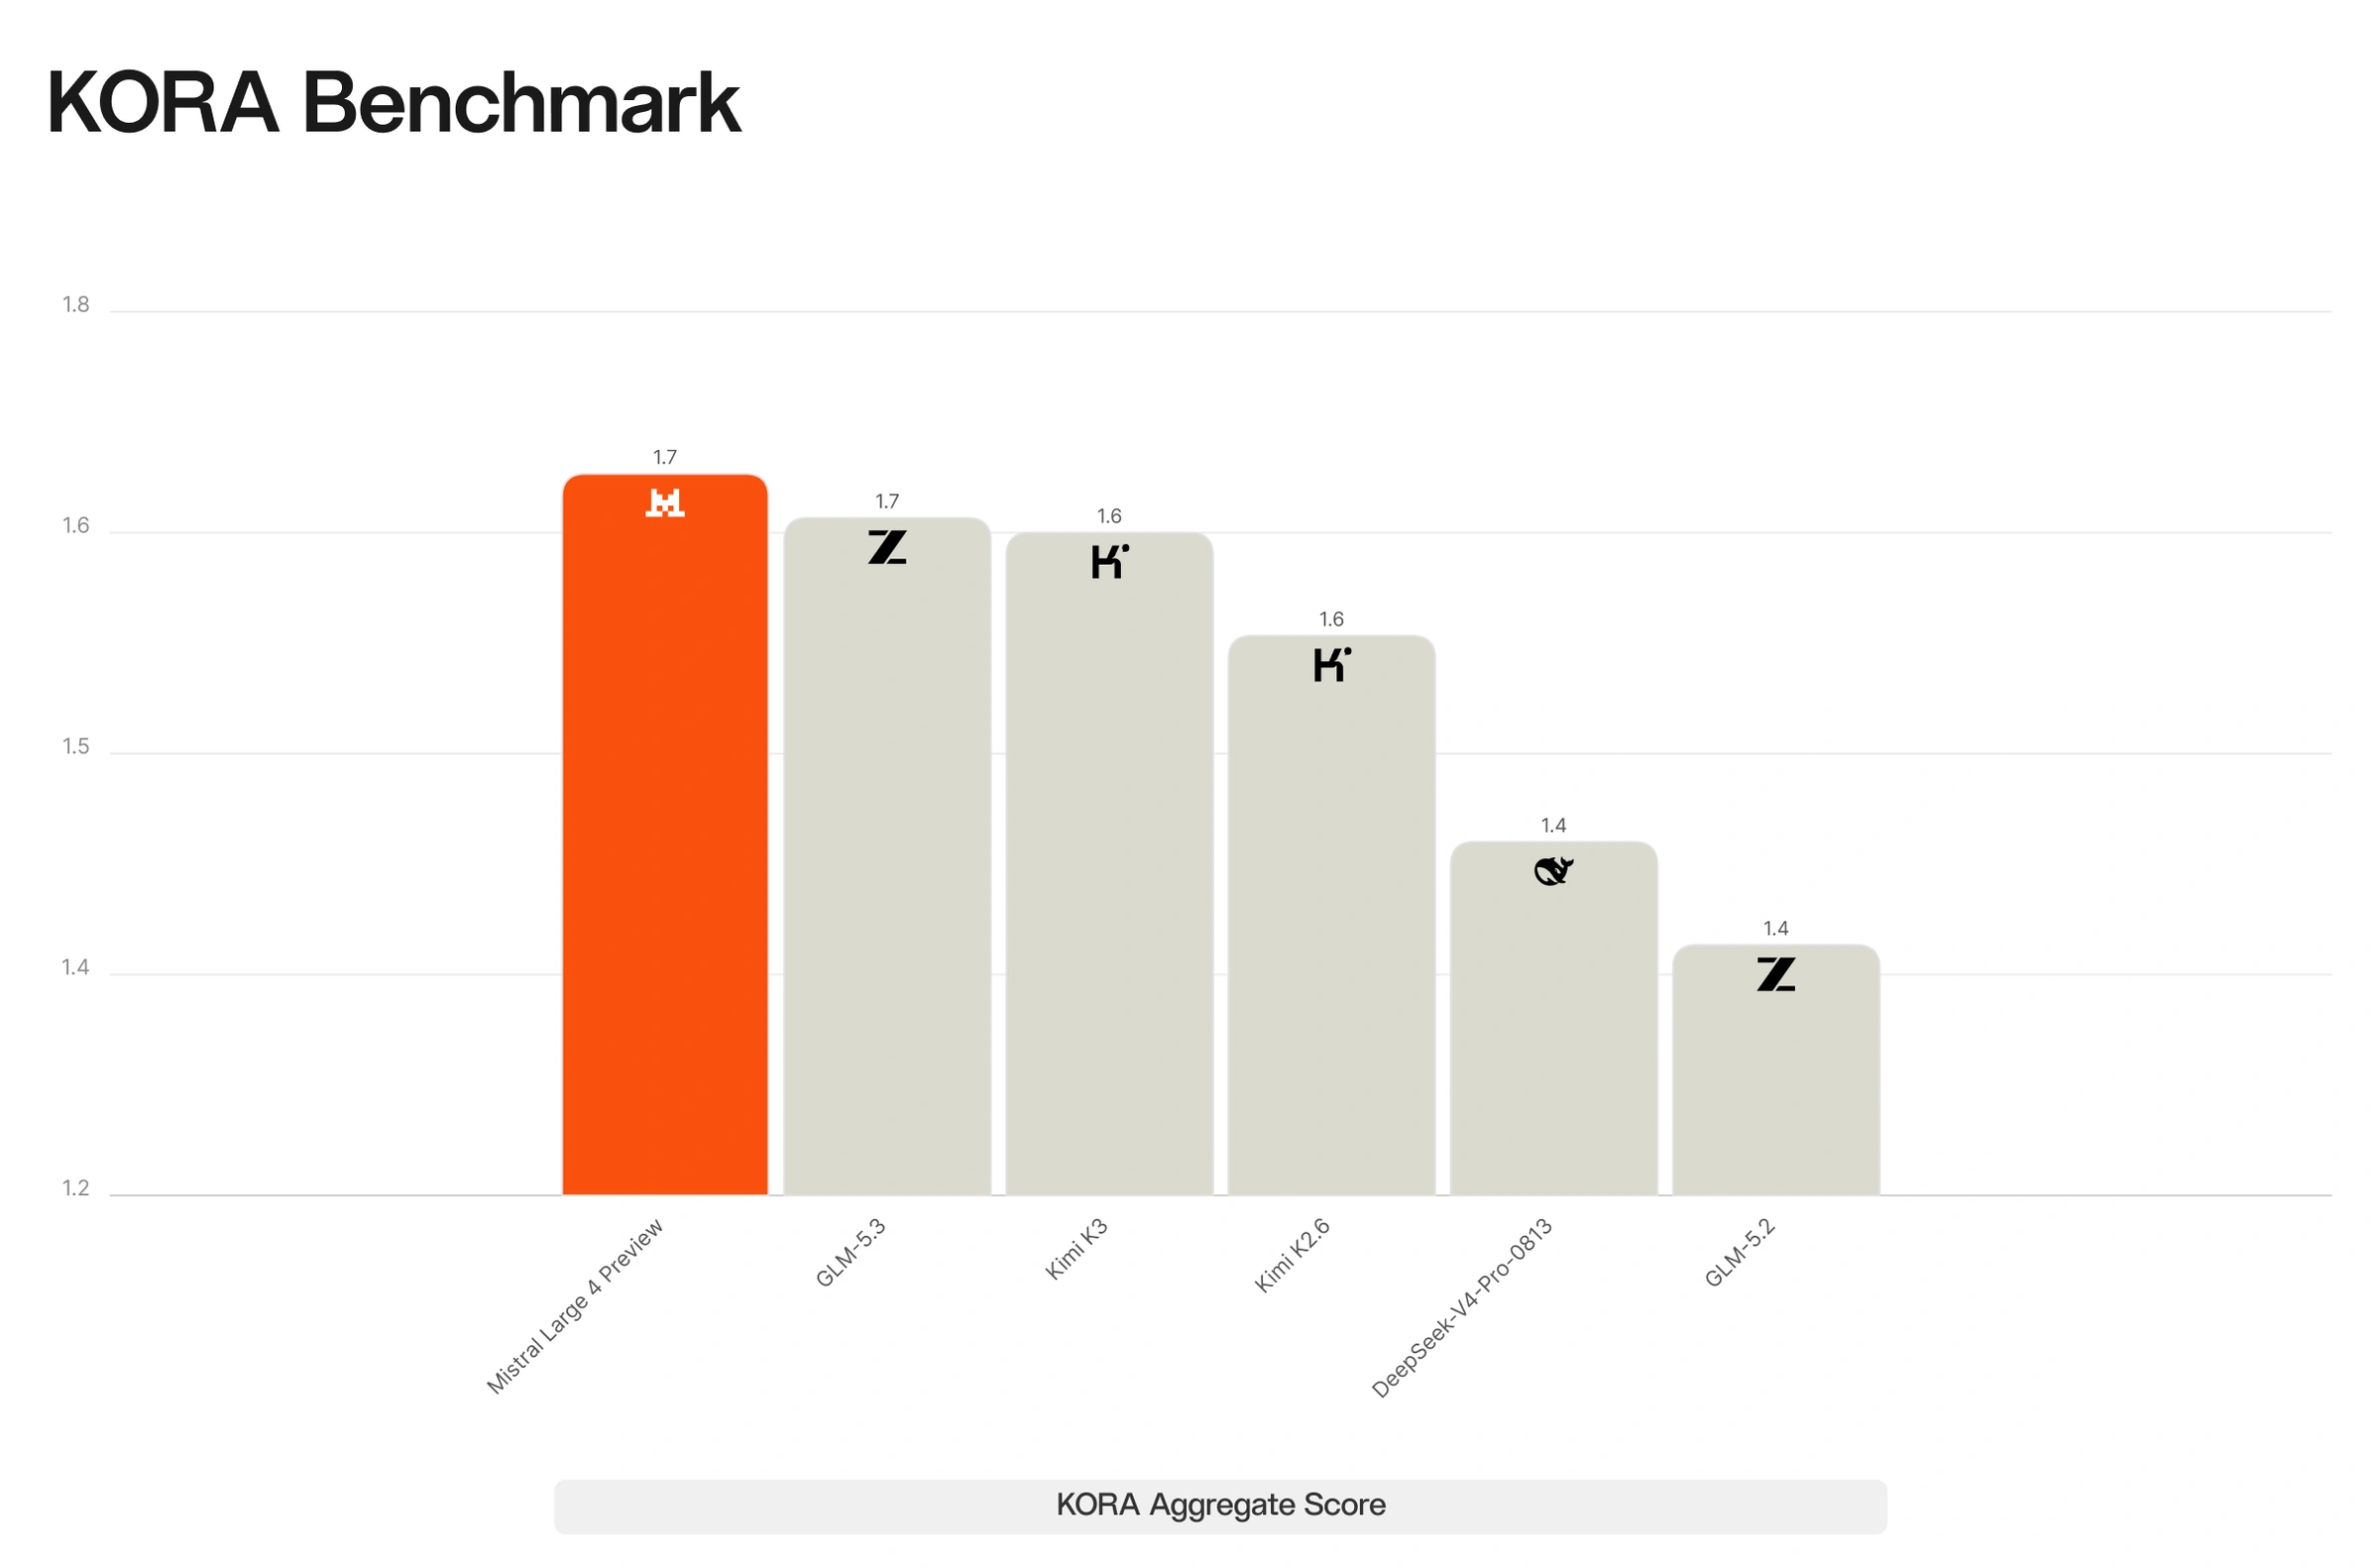
ML4 interagit également avec les utilisateurs de façon plus responsable que tous nos modèles précédents. Nous mettons en avant nos résultats sur le KORA Benchmark, où ML4 obtient de nouveau le score le plus élevé que nous ayons mesuré parmi les modèles OSS (1,691, 2 étant le maximum, noté « Exemplaire »).Exemplary”).
La propension du modèle à refuser les requêtes malveillantes en matière de cybersécurité est particulièrement pertinente. Malgré de solides performances sur les benchmarks de cybersécurité, le taux de refus moyen du modèle sur les prompts de cybersécurité issus de JailbreakBench, StrongREJECT et AgentHarm est supérieur à celui de tous les modèles OSS.
Évaluation humaine
Nous avons mené une évaluation interne dans laquelle des annotateurs experts en codage, en conception assistée par ordinateur (CAD), en finance, en mathématiques et en physique ont comparé Mistral Large 4 à GLM-5.3. ML4 a été préféré en CAD et en STEM, tout en affichant des performances équivalentes ou proches de GLM-5.3 en finance et en codage.
Apprentissage par renforcement à grande échelle
Les modèles de base progressent rapidement, et notre post-training doit suivre le rythme. Une recette ajustée pour le modèle d'hier laisse des capacités de côté avec les modèles de pointe d'aujourd'hui, car les échantillons de vérité terrain qui poussaient autrefois un modèle à ses limites ne le font plus. Nous utilisons l'apprentissage par renforcement (RL) parce qu'il s'adapte au même rythme que le modèle : nous nous entraînons sur les résultats des tentatives du modèle lui-même, et nous pouvons augmenter la difficulté et l'étendue des tâches à mesure qu'il gagne en puissance.
Notre bibliothèque de RL a été conçue pour faciliter l'ajout de nouveaux environnements et leur entraînement à grande échelle. Une interface partagée et composable permet à un seul run d'entraînement de combiner des tâches aussi variées que la conversation en un seul tour, la résolution de problèmes scientifiques complexes, l'alignement sur la sécurité, la factualité et l'utilisation d'outils à long horizon. Ces environnements partagent des scaffolds et des ressources tels que des sandbox de code, la recherche sur le Web et des API externes. Cette même composabilité s'étend à la vérification, avec des modèles de récompense, des tests unitaires, des juges LLM et des vérifications statiques combinés selon les besoins de chaque tâche.
À l'exécution, une flotte d'actors à mise à l'échelle automatique génère des dizaines de milliers de rollouts en parallèle pendant que l'entraînement du modèle se poursuit de manière asynchrone. Le pipeline de génération et d'entraînement est optimisé pour les trajectoires longues : il prend en charge des budgets de rollouts de plusieurs millions de tokens à travers plusieurs compactions, tout en maintenant un staleness faible. Des méthodes et optimisations inédites sur les deux étapes minimisent la dérive off-policy et permettent une RL stable sur de longs horizons.
À notre échelle actuelle (3 000 GPU), un seul run d'entraînement produit environ 33 milliards de tokens par jour, dont environ 16 milliards sont des tokens de complétion entraînables après filtrage et masquage. La progression du run est directement visible dans les rollouts d'entraînement : les récompenses d'entraînement augmentent sur plusieurs environnements représentatifs à mesure que la politique apprend à résoudre des tâches de plus en plus complexes. Quelques exemples ci-dessous.
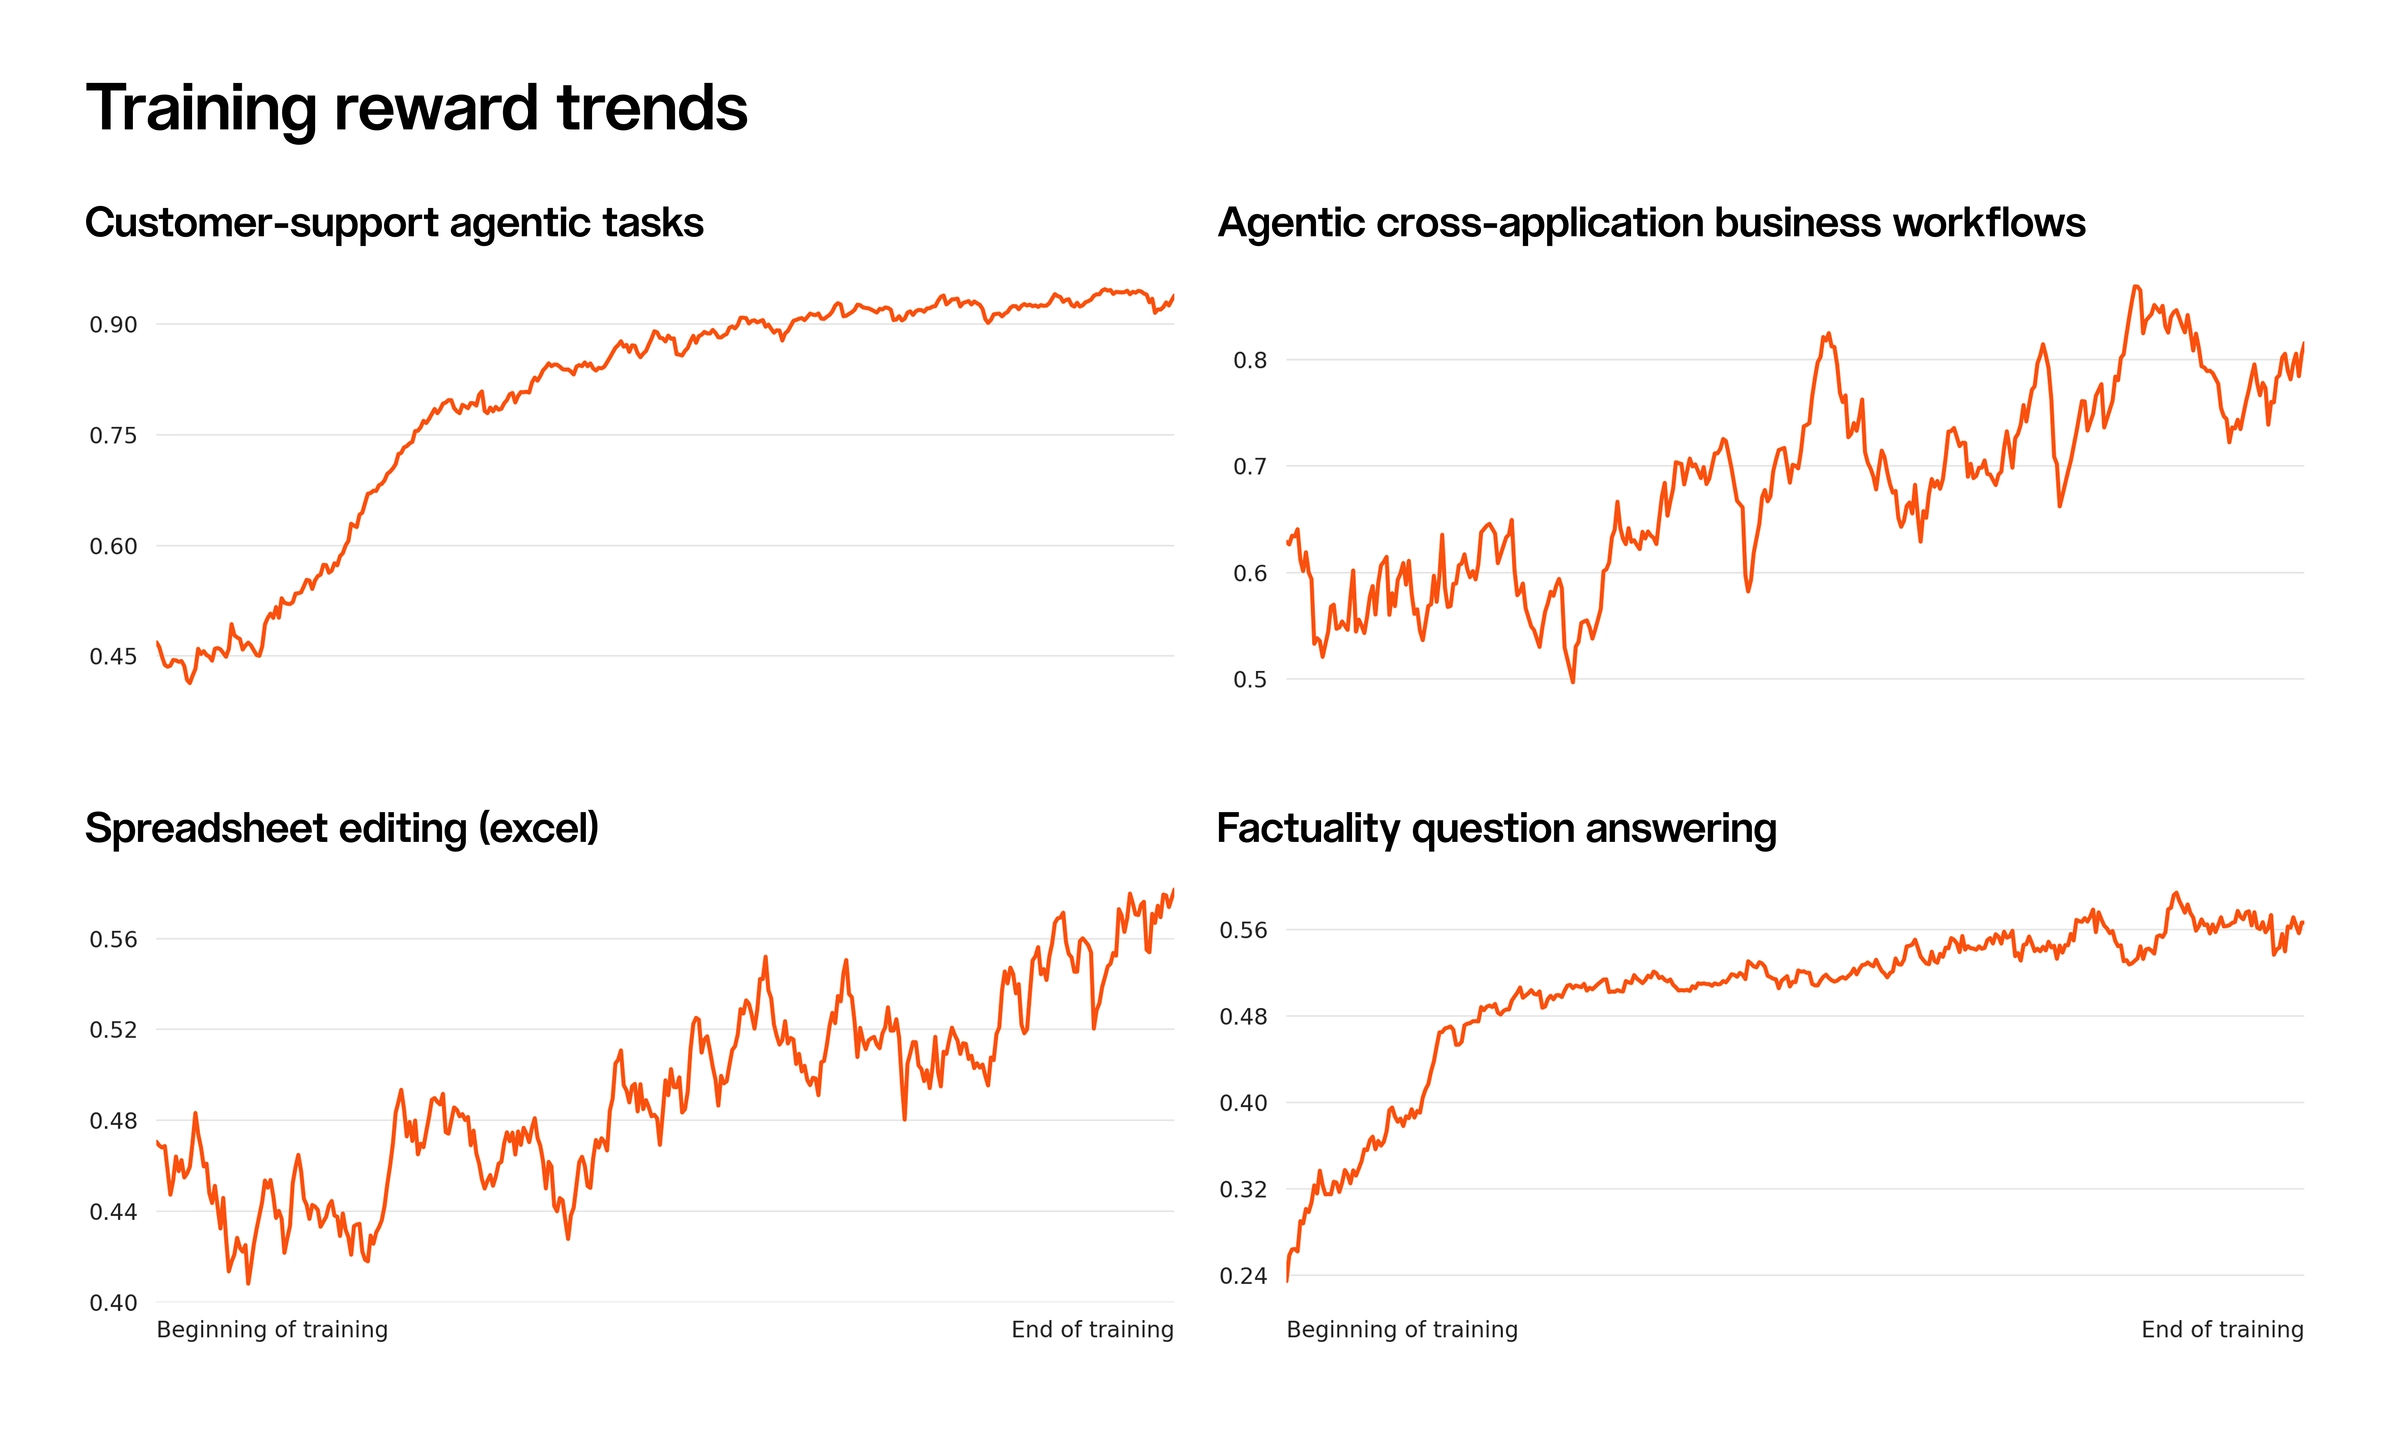
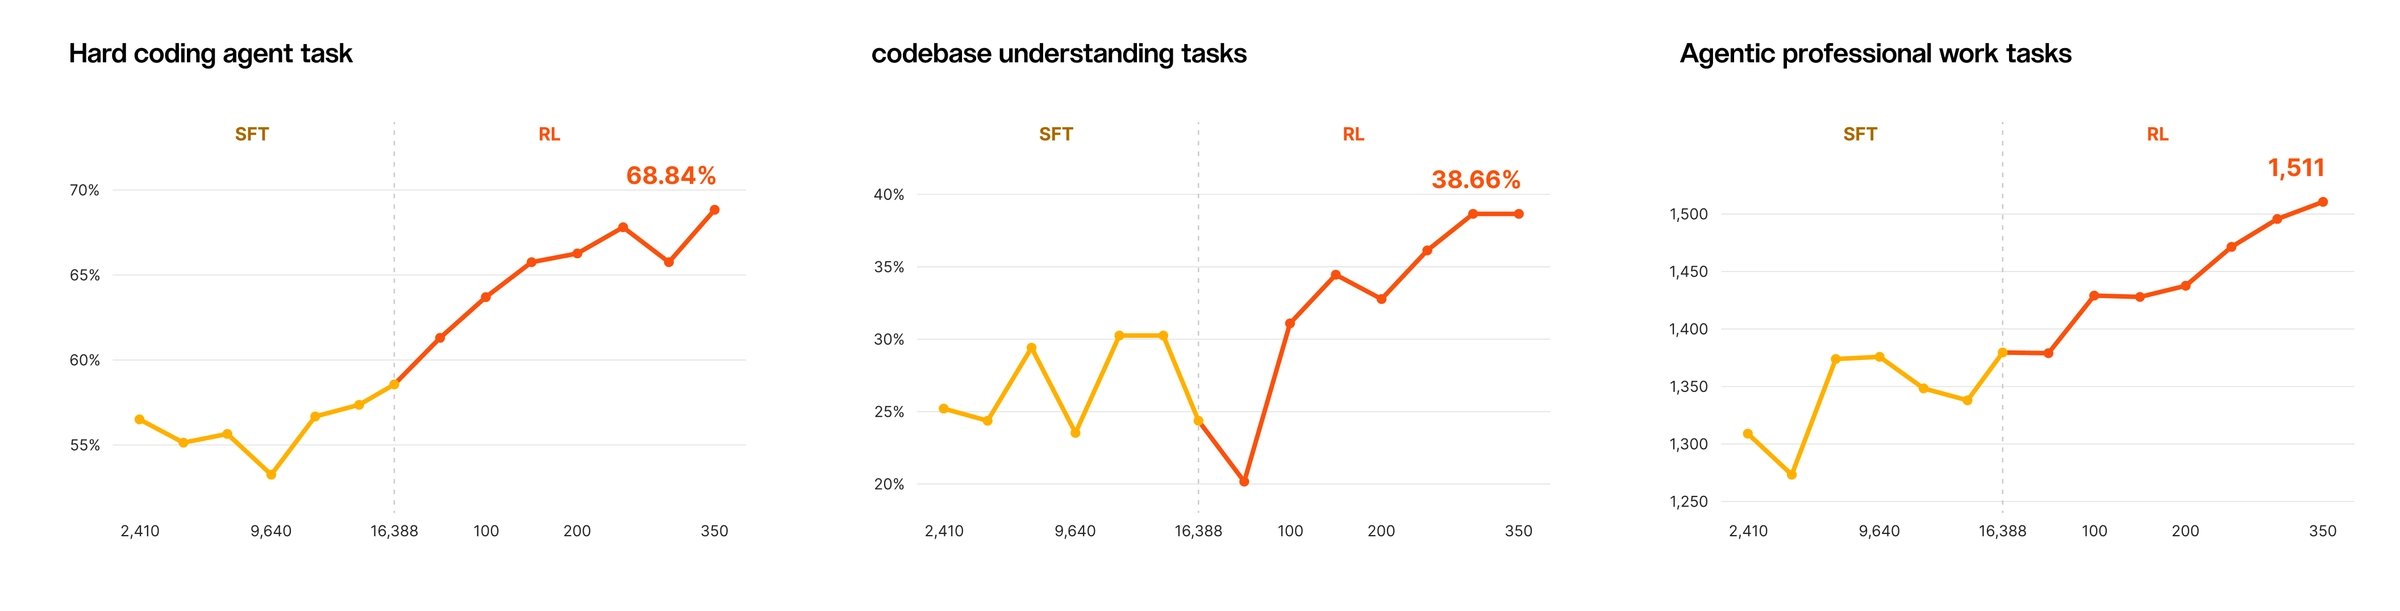
Les améliorations ne sont pas propres aux environnements sur lesquels nous nous entraînons ; elles se transfèrent aux évaluations en aval, et le modèle final les doit aux deux étapes du post-training (le fine-tuning supervisé et la RL), comme le montrent les graphiques.
Et après
Ce n'est que le début. ML4 est le premier jalon de la roadmap financée par notre série D de 3 milliards d'euros — le tour de table en actions le plus important jamais levé par une entreprise technologique européenne. Ce capital est déjà à l'œuvre : nous augmentons considérablement notre capacité de Compute dans nos propres datacenters européens, et bien davantage entrera en service dans les mois à venir.
Plus de Compute signifie plus d'entraînement. Le run d'apprentissage par renforcement derrière cette préversion est toujours en cours, et le modèle ne montre aucun signe de saturation — il reste une marge de progression substantielle. À mesure que nous intensifions l'entraînement sur notre infrastructure renforcée, nous nous attendons à des améliorations importantes et rapides dans les semaines et les mois à venir.
Nous publierons les poids d'ici la fin du mois, accompagnés de plus de détails sur l'architecture, de benchmarks supplémentaires et de notre méthodologie de post-training. Et ML4 n'est que le socle : il servira de base à une nouvelle génération de modèles Mistral spécialisés et optimisés, conçus pour les industries et les charges de travail qui comptent le plus pour nos clients.
Le rythme de progression sera rapide à partir de maintenant. Restez à l'affût.
Mistral Large 4
New
Open-weight hybrid instruct-and-reasoning MoE with multimodal input; unifies instruction, reasoning, and agentic capabilities in a single model, state-of-the-art among open weights on cybersecurity, finance, and manufacturing, natively fluent in 160+ languages.
Multimodal
Reasoning
Coding
Agentic
Cybersecurity
Input (/M tokens)
$1.36
Output (/M tokens)
$4.18